Rất nhiều chủ doanh nghiệp và quản trị viên thường có một niềm tin tuyệt đối rằng: "Hệ thống đã có bản backup tự động mỗi đêm, nghĩa là chúng tôi đã an toàn trước mọi thảm họa."
Thế nhưng, khi một sự cố nghiêm trọng thật sự ập đến — nhà cung cấp cloud gặp sự cố ngắt kết nối kéo dài nhiều giờ, chiếc VPS chính bị lỗi phần cứng không thể khởi động lại, hoặc tài khoản quản trị máy chủ bị khóa bất ngờ — sự thật phũ phàng mới bộc lộ:
- Bạn có file backup nhưng không biết phải thuê máy chủ mới ở đâu và cấu hình mạng như thế nào cho tương thích.
- Mã nguồn nằm trong kho Git nhưng không ai nhớ danh sách mật khẩu, API key và file biến môi trường
.envđang lưu ở đâu ngoài chiếc máy chủ đã chết. - Không ai trong công ty có quyền hạn hoặc dám đứng ra quyết định: Có nên trỏ tên miền sang máy chủ dự phòng ngay không, hay tiếp tục chờ bên cho thuê VPS xử lý?
- Sau 8 tiếng đồng hồ loay hoay trong hoảng loạn, website vẫn sập, khách hàng phàn nàn và doanh thu bị gián đoạn nặng nề.
Một file backup chỉ là nguyên liệu thô. Để đưa website từ đống tro tàn trở lại hoạt động bình thường, bạn cần một kế hoạch phục hồi thảm họa (Disaster Recovery - DR). Kế hoạch này không cần phải dày hàng trăm trang như của ngân hàng, mà chỉ cần ngắn gọn, thực tế và trả lời chính xác từng hành động cần làm trong giờ phút nguy cấp nhất.
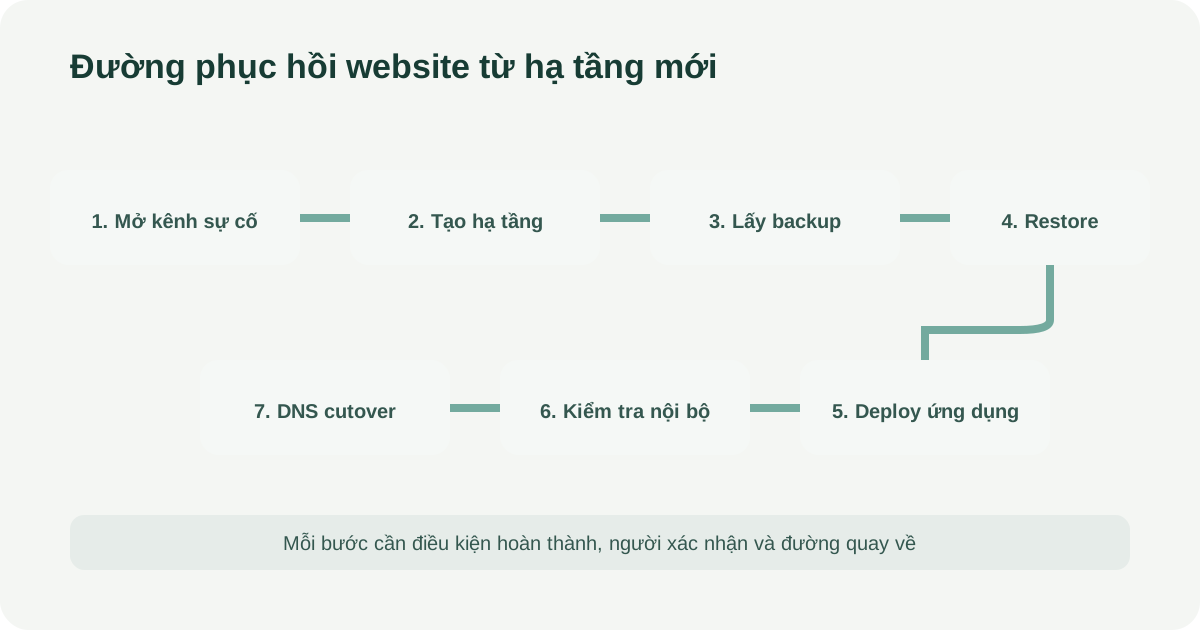
Kế hoạch DR cần mô tả cả đường phục hồi, điểm kiểm tra và người xác nhận ở từng bước.
Phân biệt rõ: Backup, Tính sẵn sàng cao (HA) và Disaster Recovery (DR)
Để không đầu tư lãng phí hoặc hiểu lầm năng lực hệ thống, bạn cần phân biệt 3 khái niệm này:
| Khái niệm | Câu hỏi cốt lõi | Cách triển khai thực tế | Vai trò khi xảy ra sự cố lớn |
|---|---|---|---|
| Backup | Dữ liệu có thể lấy lại từ mốc nào? | Bản xuất database, file nén upload lưu trên cloud storage độc lập | Cung cấp nguồn dữ liệu nguyên vẹn để khôi phục |
| High Availability (HA) | Một thành phần chết thì hệ thống có chạy tiếp không? | Chạy 2 máy chủ song song, cân bằng tải (Load Balancer), database replica | Giúp website không bị gián đoạn khi 1 máy chủ đơn lẻ gặp lỗi |
| Disaster Recovery (DR) | Nếu toàn bộ hạ tầng chính sập, làm sao dựng lại dịch vụ có kiểm soát? | Quy trình kích hoạt, dựng server mới, bung backup, trỏ DNS và xác nhận nghiệp vụ | Bản hướng dẫn hành động giúp đưa dịch vụ trở lại khi mọi giải pháp tự động đều thất bại |
Cơ chế sao chép thời gian thực (replication) của HA rất tốt, nhưng nó không thay thế được DR. Nếu một nhân viên chạy nhầm lệnh xóa sạch database, lệnh xóa đó sẽ lập tức được đồng bộ sang máy chủ dự phòng trong tích tắc. Lúc này, chỉ có quy trình DR kết hợp với bản backup sạch mới có thể cứu được doanh nghiệp.
Bước 1: Xác định rõ khi nào cần kích hoạt kế hoạch DR
Không phải bất kỳ lúc nào website báo lỗi 502 Bad Gateway hay database bị khởi động lại cũng được coi là "thảm họa". Nếu bạn vội vã chuyển đổi hạ tầng quá sớm, bạn có thể tự tạo ra một đợt gián đoạn không đáng có và làm phát sinh dữ liệu phân mảnh ở hai nơi.
Kế hoạch DR cần có các ngưỡng kích hoạt (Trigger Criteria) cụ thể và rõ ràng:
- Sự cố hạ tầng kéo dài vượt ngưỡng cam kết: Máy chủ chính bị sập hoàn toàn và phía nhà cung cấp thông báo thời gian khắc phục dự kiến vượt quá chỉ số RTO của bạn (xem cách đặt chỉ số tại bài RPO và RTO khác nhau thế nào trong một sự cố thật?).
- Mất hoàn toàn quyền kiểm soát máy chủ chính: Tài khoản quản trị bị khóa hoặc hạ tầng nghi ngờ bị xâm nhập, không còn an toàn để tiếp tục phục vụ người dùng.
- Dữ liệu trên máy chủ chính bị hỏng trên diện rộng: Hệ điều hành bị lỗi phân vùng đĩa (filesystem corruption) không thể sửa chữa tại chỗ.
Đồng thời, phải chỉ định rõ ai là người có thẩm quyền ra quyết định kích hoạt DR. Thông thường, đây là quyết định phối hợp giữa người phụ trách kỹ thuật (xác nhận lỗi không thể sửa nhanh) và chủ doanh nghiệp hoặc giám đốc vận hành (đồng ý chuyển sang hạ tầng dự phòng dù có thể chấp nhận mất một lượng dữ liệu nhỏ trong phạm vi RPO đã thống nhất trong chiến lược backup VPS).
Bước 2: Kiểm kê tài sản theo "đường phục hồi", không chỉ nhìn vào cấu hình máy chủ
Để dựng lại một website hoạt động trọn vẹn ở một nơi hoàn toàn mới, bạn cần chuẩn bị trước danh sách những tài sản tối thiểu sau:
- Tên miền và quản trị DNS: Tên miền đang quản lý ở đâu (Cloudflare, bên cung cấp tên miền)? Ai nắm tài khoản? Thời gian cache (TTL) của các bản ghi DNS có đang được để ở mức ngắn (ví dụ 5 phút) để khi cần đổi IP máy chủ mới, người dùng có thể nhận diện ngay lập tức không?
- Mã nguồn và Docker image: Mã nguồn có đang nằm trên GitHub/GitLab độc lập không? Có lưu sẵn đúng phiên bản ổn định (release tag) đang chạy trên production không?
- File biến môi trường và Secret: Toàn bộ chuỗi kết nối database, API key của cổng thanh toán, secret key của ứng dụng được lưu ở đâu? (Tuyệt đối không lưu duy nhất trên chiếc VPS chính; phải lưu trong trình quản lý mật khẩu an toàn của công ty như Bitwarden hoặc 1Password).
- Bản sao lưu dữ liệu cốt lõi: Bản backup database và file upload mới nhất đang nằm ở đâu ngoài VPS chính? Có được phân tán theo quy tắc backup 3-2-1 và lưu trữ tách biệt không? Có tài khoản dự phòng để tải về không?
- Dịch vụ tích hợp bên ngoài: Cổng thanh toán (VNPay, Momo), dịch vụ gửi mail (SendGrid, Resend) có yêu cầu cấu hình IP máy chủ (IP allowlist) không? Nếu chuyển sang IP mới, cần làm gì để các cổng này không từ chối giao dịch?
Bước 3: Phân công vai trò cụ thể trong giờ phút nguy cấp
Trong lúc sự cố xảy ra, tâm lý chung rất dễ rơi vào hoảng loạn, người nọ nhìn người kia hoặc nhiều người cùng thao tác chéo gây xung đột. Kế hoạch DR tối thiểu chỉ cần phân công 4 vai trò rõ ràng:
- Người chỉ huy & điều phối (Incident Commander): Theo dõi tiến độ từng chặng, bấm giờ đối chiếu với RTO, ra quyết định kích hoạt và thông báo trạng thái.
- Người phục hồi kỹ thuật (Technical Lead): Chịu trách nhiệm khởi tạo máy chủ mới, cấu hình môi trường, tải backup và import dữ liệu.
- Người kiểm tra nghiệp vụ (Business Validator): Người hiểu rõ sản phẩm (Tester, Product Owner hoặc chính chủ shop). Sau khi kỹ thuật dựng xong, người này sẽ vào kiểm tra các tính năng: đặt thử đơn hàng, xem ảnh sản phẩm, kiểm tra tiền trong tài khoản xem mọi thứ có khớp không.
- Người truyền thông (Communicator): Phụ trách đăng thông báo bảo trì trên fanpage, gửi email xin lỗi khách hàng hoặc trả lời ban giám đốc để đội kỹ thuật hoàn toàn tập trung vào việc khôi phục.
Mỗi vai trò bắt buộc phải có một người thay thế (backup person) dự phòng trường hợp người chính đang đi công tác hoặc không thể liên lạc.
Bước 4: Trình tự 7 bước phục hồi website từ con số 0
Khi quyết định kích hoạt DR được ban bố, toàn đội ngũ sẽ thực thi tuần tự theo 7 bước tiêu chuẩn sau:
1. Mở kênh trao đổi khẩn cấp
Tạo ngay một nhóm chat riêng (trên Telegram, Zalo hoặc Slack) dành riêng cho sự cố, không trao đổi việc khác. Người điều phối ghi lại mốc thời gian bắt đầu.
2. Khởi tạo máy chủ dự phòng
Thuê một chiếc VPS mới tại một nhà cung cấp khác (hoặc một vùng khác). Cài đặt các gói phần mềm, Nginx, runtime (PHP/NodeJS) và cơ sở dữ liệu tương thích từ kịch bản hoặc template đã chuẩn bị sẵn.
3. Tải và giải mã dữ liệu backup
Truy cập vào dịch vụ lưu trữ đám mây tách biệt (S3, Cloudflare R2), tải bộ Backup Set mới nhất về máy chủ mới. Kiểm tra mã checksum SHA-256 để đảm bảo file nguyên vẹn và tiến hành giải nén.
4. Khôi phục dữ liệu Database và File
- Import database vào hệ quản trị cơ sở dữ liệu mới.
- Giải nén thư mục file upload về đúng đường dẫn, phân quyền thư mục chuẩn xác. Dữ liệu hai phần này phải đồng bộ theo hướng dẫn phối hợp backup database và file.
- Nạp file cấu hình
.envvới các chuỗi kết nối của máy chủ mới.
5. Triển khai mã nguồn ứng dụng
Kéo mã nguồn từ kho Git về (đúng commit hoặc tag tương thích với bản database vừa import). Khởi động dịch vụ web server và ứng dụng.
6. Kiểm tra nội bộ bằng địa chỉ tạm thời (Chưa trỏ tên miền thật)
Người kiểm tra nghiệp vụ cấu hình file hosts trên máy tính cá nhân để trỏ tên miền về IP của máy chủ mới. Tiến hành kiểm tra:
- Đăng nhập trang quản trị thành công.
- Xem chi tiết sản phẩm, bài viết: hình ảnh hiển thị sắc nét, không bị lỗi 404.
- Đặt thử một đơn hàng mẫu để kiểm tra khả năng ghi dữ liệu.
- Đảm bảo các kết nối thanh toán và gửi mail hoạt động trơn tru.
7. Điều hướng lưu lượng truy cập (DNS Cutover)
Khi người kiểm tra nghiệp vụ xác nhận mọi luồng chính đã thông suốt:
- Người phụ trách kỹ thuật truy cập trang quản trị DNS (như Cloudflare) và đổi địa chỉ IP của bản ghi
@vàwwwsang IP của máy chủ mới. - Bật giám sát lưu lượng và kiểm tra log truy cập xem người dùng thực tế đã bắt đầu chuyển hướng sang máy chủ mới hay chưa.
- Người truyền thông cập nhật thông báo website đã hoạt động trở lại bình thường.
Đừng quên kịch bản quay về (Failback)
Một thiếu sót rất lớn của nhiều kế hoạch DR là chỉ tính đường đi (Failover) mà quên mất đường về (Failback).
Sau 2 ngày chạy trên máy chủ tạm thời, nhà cung cấp cũ thông báo máy chủ chính đã hoạt động trở lại. Lúc này bạn sẽ làm gì?
- Tiếp tục giữ máy chủ mới làm máy chủ chính thức luôn, hay chuyển ngược lại về máy chủ cũ?
- Trong 2 ngày qua, khách hàng đã đặt hàng trăm đơn hàng mới trên máy chủ tạm thời. Làm thế nào để đồng bộ số đơn hàng mới này về máy chủ cũ mà không làm mất mát dữ liệu?
Kế hoạch cần ghi rõ: Khi hệ thống chính hồi phục, tuyệt đối không vội vã trỏ ngược DNS về ngay. Hãy chọn một khung giờ bảo trì thấp điểm (ví dụ nửa đêm), chạy một quy trình backup đầy đủ trên máy chủ tạm thời rồi mới khôi phục ngược lại về máy chủ chính một cách bài bản.
Bắt đầu bằng một bản kế hoạch DR trên 1 trang giấy
Bạn không cần một bản kế hoạch cầu kỳ. Hãy mở một file tài liệu nội bộ và điền đầy đủ các thông tin cốt lõi sau:
[KẾ HOẠCH DISASTER RECOVERY WEBSITE - BẢN TỐI THIỂU]

1. MỤC TIÊU:
- RTO (Thời gian phục hồi tối đa): 2 giờ.
- RPO (Lượng dữ liệu tối đa chấp nhận mất): 24 giờ (dữ liệu từ bản backup 2h00 sáng).

2. ĐIỀU KIỆN KÍCH HOẠT:
- Máy chủ chính sập quá 60 phút và nhà cung cấp chưa có phương án khắc phục ngay.
- Người có quyền quyết định: Anh A (Trưởng nhóm Kỹ thuật) hoặc Chị B (Giám đốc Điều hành).

3. DANH SÁCH TÀI SẢN VÀ NƠI LƯU TRỮ:
- Tên miền: Quản lý tại Cloudflare (Tài khoản lưu trong 1Password công ty).
- Mã nguồn: GitHub repo `company/website`, nhánh `main` (phiên bản ổn định).
- Cấu hình & Secret: Lưu trong mục "Production Env" trên 1Password.
- Backup dữ liệu: Lưu tại Cloudflare R2 bucket `backup-prod` (sử dụng Access Key dự phòng).

4. PHÂN CÔNG NHÂN SỰ:
- Chỉ huy & Điều phối: Anh A (Dự phòng: Anh C).
- Kỹ thuật phục hồi: Anh D (Dự phòng: Anh E).
- Kiểm tra nghiệp vụ: Chị F (Dự phòng: Chị B).
- Kênh liên lạc khẩn cấp: Nhóm Telegram "Sự cố Khẩn cấp HTS".

5. QUY TRÌNH THỰC HIỆN: Theo 7 bước phục hồi chuẩn trong tài liệu runbook kỹ thuật.
Diễn tập định kỳ: Bí quyết để kế hoạch thực sự có tác dụng
Một bản kế hoạch DR nằm im trong ngăn kéo sẽ trở nên lỗi thời rất nhanh sau vài tháng khi đội ngũ thay đổi mật khẩu, cập nhật phiên bản phần mềm hoặc có nhân sự mới.
Mỗi 6 tháng một lần, hãy tổ chức một buổi diễn tập ngắn:
- Diễn tập trên giấy (Tabletop Exercise): Mời các nhân sự liên quan ngồi lại trong 30 phút, giả định tình huống "Máy chủ chính bị cháy ổ cứng lúc 10h sáng", từng người sẽ trình bày xem mình cần lấy thông tin gì ở đâu và làm những bước nào.
- Diễn tập khôi phục thực tế: Sử dụng bản backup gần nhất để dựng lại website trên một VPS phụ theo đúng Checklist thử restore website trên môi trường tách biệt.
Khi toàn bộ đội ngũ đã quen tay với quy trình và mọi thông tin cần thiết đều nằm sẵn trong tầm tay, bạn sẽ không còn phải lo sợ trước bất kỳ sự cố bất ngờ nào. Sự bình tĩnh và chuyên nghiệp trong giờ phút ngặt nghèo chính là thước đo năng lực vận hành vững vàng nhất của một doanh nghiệp.