Một sự cố website thường bắt đầu bằng tin nhắn réo chuông từ khách hàng hoặc thông báo đỏ rực từ kênh giám sát tự động. Trong tình huống đó, áp lực phải đưa hệ thống hoạt động trở lại ngay lập tức rất dễ đẩy người trực ca vào các thao tác vội vã: gõ lệnh khởi động lại dịch vụ theo quán tính, hoặc reboot máy chủ mà chưa kịp ghi nhận bất kỳ dữ liệu nào.
Khởi động lại dịch vụ có thể giảm tác động tạm thời nhưng không chứng minh nguyên nhân đã được xử lý. Nó cũng có thể làm mất trạng thái trong bộ nhớ, thay đổi thời điểm trong log hoặc khiến một lỗi ngắt quãng khó tái hiện hơn. Vì vậy, hãy lưu những dữ kiện dễ mất trước khi restart nếu tình trạng cho phép.
Khung thời gian 30 phút đầu tiên sinh ra không phải để tìm ra tận cùng nguyên nhân gốc rễ (root cause), mà để thiết lập lại trật tự điều tra: xác định chính xác người dùng đang bị nghẽn ở đâu, đóng băng hiện trường để lỗi không lan rộng, và chọn biện pháp hạ nhiệt an toàn nhất để khôi phục luồng dịch vụ cốt lõi.
Khung điều phối dưới đây giúp bạn giữ nhịp xử lý điềm tĩnh, tránh rơi vào trạng thái hoảng loạn khi vận hành:
| Khung thời gian | Trọng tâm thao tác | Kết quả cụ thể cần đạt |
|---|---|---|
| 0 – 5 phút | Xác thực sự cố từ góc nhìn người dùng | Một câu tóm tắt chính xác về triệu chứng thực tế và phạm vi ảnh hưởng |
| 5 – 10 phút | Kiểm soát thay đổi và lập timeline | Tạm dừng thay đổi có thể dừng an toàn, ghi nhận các biến số hệ thống vừa thay đổi |
| 10 – 20 phút | Lần theo đường đi của gói tin | Định vị chính xác 1–2 tầng kiến trúc đang nghẽn kèm trích xuất log lỗi |
| 20 – 30 phút | Thực hiện biện pháp giảm tác động có kiểm soát | Dịch vụ ổn định hơn hoặc đã xác định được bước xử lý chuyên sâu tiếp theo |
Các mốc trên là khung giữ nhịp điều tra, không phải SLA và cũng không bảo đảm website sẽ hoạt động lại trong 30 phút. Nếu phát hiện dấu hiệu bị xâm nhập, mất dữ liệu hoặc mất quyền truy cập quản trị, hãy dừng runbook vận hành thông thường, giữ nguyên bằng chứng và chuyển sang quy trình ứng phó chuyên biệt.
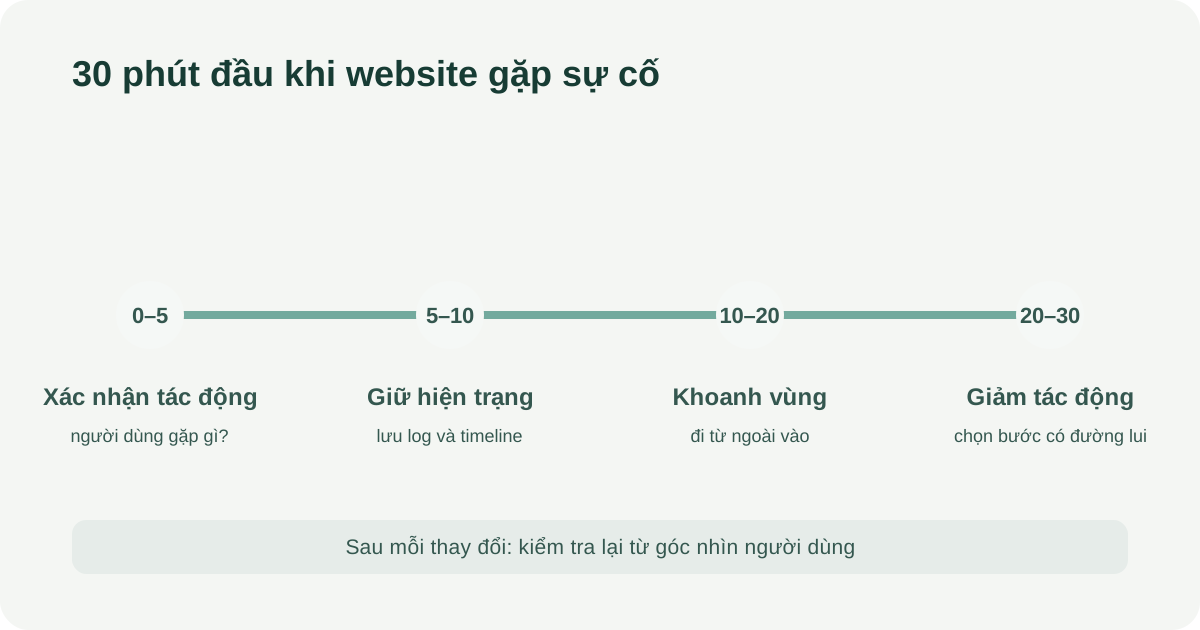
Bốn giai đoạn giúp đội xử lý giữ nhịp: xác nhận tác động, giữ hiện trạng, khoanh vùng và giảm tác động.
0–5 phút: Xác nhận điều người dùng thực sự gặp phải
Một thông báo cảnh báo từ hệ thống monitoring chưa đủ để bạn kết luận toàn bộ máy chủ đã bị sập. Công cụ giám sát tự động có thể bị lỗi mạng cục bộ tại một điểm probe, trong khi khách hàng thực tế vẫn đang mua hàng bình thường. Ngược lại, biểu đồ CPU/RAM của VPS trên dashboard nhà cung cấp đám mây có thể vẫn xanh mướt, nhưng tên miền đã bị hết hạn hoặc chứng chỉ SSL bị lỗi khiến không một ai vào được trang web.
Hãy mở trình duyệt ở chế độ ẩn danh (hoặc dùng mạng 4G/5G độc lập) và trả lời nhanh các câu hỏi:
- Đường dẫn (URL) hoặc tính năng cụ thể nào đang gặp lỗi?
- Lỗi xảy ra trên 100% người dùng hay chỉ xuất hiện ngẫu nhiên ở một số yêu cầu?
- Người dùng nhận được phản hồi gì: màn hình trắng tinh, thông báo Gateway Timeout (504), Bad Gateway (502) hay trang web bị tải chậm bất thường?
- Lỗi xuất hiện trên toàn bộ website hay chỉ xảy ra ở các trang nghiệp vụ nặng như đăng nhập, giỏ hàng, thanh toán hoặc API upload ảnh?
- Thời điểm chính xác bắt đầu phát sinh sự cố là khi nào?
Sử dụng lệnh curl từ máy cá nhân của bạn để kiểm tra trực tiếp mã phản hồi và thời gian kết nối:
curl -Iv https://tenmien.com/api/v1/healthKết thúc 5 phút đầu tiên, bạn cần viết ra được một câu mô tả ngắn gọn, rõ ràng thay vì câu nói mơ hồ "server bị sập":
"Từ 14:15, endpoint thanh toán
/checkoutliên tục trả về lỗi HTTP 504 khi kiểm tra từ 2 nhà mạng khác nhau. Trang chủ và trang xem chi tiết sản phẩm vẫn phản hồi mã 200 dưới 300ms."
Câu mô tả này định hướng chính xác toàn bộ các bước điều tra kỹ thuật tiếp theo.
5–10 phút: Đóng băng hiện trạng và lập timeline sự kiện
Nếu sự cố xảy ra trong lúc đang deploy, chạy database migration hoặc thực hiện một tác vụ tự động có khả năng thay đổi production, hãy tạm dừng các thay đổi chưa bắt đầu và những tác vụ có thể dừng an toàn. Không ngắt một migration hoặc thao tác ghi đang chạy giữa chừng khi chưa biết trạng thái transaction và cơ chế rollback. Việc sửa vội rồi deploy đè lên trong lúc hệ thống đang chập chờn chỉ làm hiện trường khó đọc hơn.
Rà soát nhanh các biến số thay đổi quanh mốc thời gian bắt đầu lỗi:
- Có bản build mã nguồn, container image hoặc bản vá nào vừa được đưa lên production không?
- Cấu hình Nginx, Cloudflare, bản ghi DNS hoặc firewall có vừa bị chỉnh sửa không?
- Có lệnh migration database nào vừa chạy xong không?
- Chứng chỉ SSL hoặc token xác thực API có vừa bị làm mới không?
- Máy chủ có vừa bắt đầu một tác vụ cronjob nặng (như backup nén file zip hoặc xuất báo cáo) không?
- Nhà cung cấp hạ tầng (AWS, Hetzner, DigitalOcean) có đang bảo trì mạng trong khu vực không?
Tạo bảng ghi chép dòng thời gian (Timeline)
Trong các sự cố phức tạp, việc nhiều người cùng nhảy vào gõ lệnh mà không ai biết người kia đang làm gì là nguyên nhân hàng đầu gây thảm họa. Hãy chỉ định một người duy nhất nắm quyền điều phối và ghi nhận timeline:
| Mốc thời gian | Sự kiện / Hành động đã thực hiện | Người thực hiện | Kết quả ghi nhận |
|---|---|---|---|
| 14:10 | Hoàn tất deploy phiên bản release v2.4.1 | Hoàng | Pipeline báo thành công |
| 14:15 | Hệ thống Uptime Robot báo lỗi 504 trên /checkout | Monitoring | Tỷ lệ lỗi 80% |
| 14:18 | Tạm dừng pipeline deploy, giữ nguyên hiện trạng | Thắng | Đóng băng mọi thay đổi |
Tuyệt đối không dán các thông tin nhạy cảm (mật khẩu root, private key, token API khách hàng) vào các nhóm chat trao đổi sự cố.
10–20 phút: Khoanh vùng lỗi từ ngoài vào trong
Một yêu cầu web từ người dùng Internet sẽ đi qua chuỗi kiến trúc tuần tự:
Khách hàng → DNS & SSL → CDN / WAF → Nginx Reverse Proxy → Ứng dụng Backend → Database & Cache → Tài nguyên phần cứng VPS
Thay vì nhảy thẳng vào kiểm tra database hay CPU, hãy đi theo đúng hành trình của gói tin từ ngoài vào trong:
1. Tầng DNS, CDN và Chứng chỉ SSL
Kiểm tra xem tên miền có phân giải về đúng địa chỉ IP máy chủ hay không, chứng chỉ SSL còn hạn không, và nếu dùng Cloudflare thì lỗi phát sinh từ Edge của Cloudflare hay từ máy chủ gốc (Origin Server). Nếu bản ghi tên miền vừa thay đổi nhưng máy khách vẫn trỏ về máy chủ cũ, hãy xem bài DNS đã đổi nhưng website vẫn trỏ sai: kiểm tra từ đâu?. Nếu lỗi xuất phát từ chứng chỉ, xem thêm SSL hết hạn hoặc lỗi chuỗi chứng chỉ: cách khoanh vùng. Khi màn hình hiện lỗi Cloudflare Error 521 (Web Server Is Down) hoặc Error 522 (Connection Timed Out), bạn biết ngay gói tin đã đi qua Cloudflare nhưng máy chủ gốc từ chối hoặc không kịp phản hồi.
2. Tầng Nginx Reverse Proxy
Kiểm tra xem Nginx có nhận được request từ Internet hay không bằng cách xem 50 dòng log truy cập và log lỗi mới nhất:
sudo tail -n 50 /var/log/nginx/access.log
sudo tail -n 50 /var/log/nginx/error.log- Nếu Nginx trả về HTTP 502 Bad Gateway: reverse proxy không nhận được phản hồi hợp lệ từ upstream. Nguyên nhân có thể là tiến trình backend đã dừng, sai socket hoặc cổng, lỗi DNS nội bộ, lỗi TLS tới upstream hoặc ứng dụng đóng kết nối bất thường. Hướng dẫn khoanh vùng nằm tại bài Website lỗi 502: cách kiểm tra Nginx và upstream.
- Nếu Nginx trả về HTTP 504 Gateway Timeout: reverse proxy không nhận được phản hồi trong thời gian cho phép. Cần phân biệt timeout khi kết nối tới upstream với trường hợp ứng dụng đã nhận request nhưng xử lý quá lâu. Hướng dẫn chi tiết nằm tại bài Lỗi 504 Gateway Timeout: nguyên nhân thường nằm ở đâu?.
3. Tầng Ứng dụng và Container
Kiểm tra trạng thái tiến trình backend:
# Nếu chạy service truyền thống
sudo systemctl status php8.2-fpm
# Nếu chạy Docker
docker compose ps
Lưu ý quan trọng: Container ở trạng thái Up không đồng nghĩa với việc ứng dụng bên trong đang phục vụ tốt. Hãy kiểm tra xem container có liên tục bị khởi động lại (Restarting) do crash nội bộ hay không, và xem log của container:
docker compose logs --tail=100 backend4. Tầng Database và Cache
Ứng dụng có thể vẫn đang chạy nhưng request bị chờ vì connection pool đã cạn, truy vấn kéo dài, lock contention hoặc dependency như Redis bị mất kết nối. Deadlock thường khiến database hủy một transaction để phá vòng chờ; hãy đọc log và trạng thái transaction thay vì mặc định toàn bộ database đã treo:
sudo systemctl status mysql
# Hoặc kiểm tra kết nối cục bộ
mysqladmin -u root -p ping
Nếu dịch vụ cơ sở dữ liệu bị dừng hoàn toàn hoặc crash liên tục khi khởi động, hãy tham khảo thứ tự kiểm tra an toàn tại bài MySQL hoặc MariaDB không khởi động: thứ tự kiểm tra an toàn.
5. Tầng Tài nguyên phần cứng VPS
Bạn có thể xem nhanh tài nguyên ngay từ đầu và tiếp tục đối chiếu song song với log của các tầng dịch vụ. Mục tiêu là tìm tương quan, không kết luận nguyên nhân chỉ từ một biểu đồ:
- Bộ nhớ RAM & OOM Killer: Chạy
free -hvà kiểm tra xem có tiến trình nào vừa bị nhân Linux khai tử do hết RAM hay không bằng lệnhdmesg -T | grep -i oom. Chi tiết xem tại bài VPS hết RAM và OOM Killer: dấu hiệu, kiểm tra và phòng ngừa. - Tải CPU: Chạy
uptimeđể xem load average vàtop -cđể tìm tiến trình gây tải. Nếu CPU 100%, hãy tra cứu bài VPS CPU 100%: cách tìm tiến trình gây tải mà không vội reboot. - Dung lượng đĩa cứng và Inode: Chạy
df -hvàdf -i. Một ổ đĩa còn trống 50GB nhưng hết 100% Inode sẽ khiến ứng dụng không thể tạo thêm session hay ghi file log, dẫn tới sập dịch vụ diện rộng.
Kết thúc bước này, bạn đã định vị được tầng kiến trúc bị tắc nghẽn (ví dụ: "Nginx nhận request bình thường nhưng backend PHP-FPM bị crash do hết RAM sau đợt deploy").
20–30 phút: Áp dụng biện pháp hạ nhiệt có đường lui
Mục tiêu của giai đoạn này là giảm tác động bằng một thay đổi có phạm vi rõ, có thể quan sát kết quả và có đường lui đã chuẩn bị.
Phương án 1: Rollback phiên bản vừa deploy
Nếu sự cố phát sinh ngay sau đợt deploy code hoặc cập nhật container:
- Thực hiện rollback mã nguồn hoặc lùi container tag về phiên bản ổn định liền trước theo quy trình tại bài Rollback Docker Compose an toàn.
- Lưu ý đặc biệt: Rollback mã nguồn không tự động hoàn tác database migration. Nếu bản deploy mới có kèm migration làm thay đổi cấu trúc bảng, việc rollback code cũ có thể khiến code cũ không đọc được cấu trúc database mới. Luôn kiểm tra tính tương thích ngược trước khi rollback.
Phương án 2: Tạm dừng các tác vụ nặng ngầm
Nếu máy chủ bị quá tải CPU hoặc nghẽn I/O ổ đĩa:
- Tạm dừng các cronjob hoặc worker không thiết yếu nếu thao tác đó an toàn. Không ngắt một backup, migration hoặc tác vụ ghi dữ liệu giữa chừng khi chưa biết trạng thái và hậu quả của việc dừng.
- Giảm số lượng concurrency của worker queue để ưu tiên toàn bộ tài nguyên CPU/RAM cho web server phục vụ khách hàng.
Phương án 3: Khởi động lại dịch vụ đơn lẻ (Restart có chọn lọc)
Nếu một tiến trình cụ thể (như PHP-FPM hay worker) bị rò rỉ bộ nhớ hoặc rơi vào deadlock:
- Xuất nhanh các dòng log quan trọng và danh sách tiến trình ra file tạm.
- Khởi động lại đúng dịch vụ đó bằng
sudo systemctl restart <service>, không khởi động lại toàn bộ máy chủ. - Chỉ cân nhắc reboot toàn bộ VPS khi hệ điều hành mất hoàn toàn khả năng phản hồi và bạn đã hiểu rõ các rủi ro được nêu trong bài Khi nào reboot VPS là hợp lý và cần lưu lại gì trước đó?.
Xác nhận kết quả sau khi can thiệp
Tuyệt đối không tuyên bố "sự cố đã được khắc phục" chỉ vì màn hình terminal không còn báo lỗi hay dashboard chuyển sang màu xanh.
Sau khi thực hiện biện pháp hạ nhiệt, bạn phải hoàn tất các bước nghiệm thu thực tế:
- Mở trình duyệt ngoài mạng nội bộ và kiểm tra đúng hành trình vừa bị lỗi. Ưu tiên tài khoản test, synthetic transaction hoặc thao tác đọc an toàn. Nếu buộc phải tạo dữ liệu thử, phải nhận diện được dữ liệu đó và có cách dọn sau khi xác nhận.
- Kiểm tra log Nginx và backend xem tỷ lệ lỗi của hành trình đó đã trở về mức bình thường hay chưa. Không dùng một phản hồi
200hoặc302đơn lẻ làm bằng chứng toàn bộ dịch vụ đã phục hồi. - Kiểm tra các chỉ số tải hệ thống (CPU, RAM, Database connection) xem đã trở về trạng thái ổn định (baseline) chưa.
- Đảm bảo dữ liệu phát sinh trong thời gian sự cố không bị thất thoát hoặc sai lệch logic.
Thông báo trạng thái chuyên nghiệp, không hứa hẹn viển vông
Trong lúc xử lý sự cố, các bộ phận kinh doanh, chăm sóc khách hàng và ban giám đốc sẽ liên tục yêu cầu câu trả lời. Một thông báo chuyên nghiệp cần dựa trên dữ liệu thực tế đã xác minh, không đổ lỗi cho cá nhân và không đưa ra mốc thời gian hoàn thành (ETA) khi chưa nắm chắc giải pháp.
Mẫu thông báo nội bộ chuẩn:
"Cập nhật sự cố website lúc 14:35: Hệ thống ghi nhận lỗi gián đoạn tính năng thanh toán từ 14:15. Đội ngũ kỹ thuật đã xác định nguyên nhân do dịch vụ backend bị nghẽn bộ nhớ sau bản cập nhật v2.4.1. Chúng tôi đã tiến hành rollback về bản v2.4.0 lúc 14:30. Hiện tại tính năng thanh toán đã hoạt động ổn định trở lại, tỷ lệ phản hồi thành công đạt 100%. Đội ngũ tiếp tục theo dõi tải hệ thống trong 30 phút tới và sẽ có báo cáo phân tích chi tiết."
Những điều tuyệt đối không được làm trong lúc hoảng loạn
- Không reboot VPS ngay lập tức khi chưa kịp lưu log hoặc kiểm tra xem ổ đĩa có đang bị lỗi hay không.
- Không tùy tiện xóa file log, thư mục cache hay database với hy vọng "giải phóng ổ cứng cho máy chạy".
- Không thử nghiệm cùng lúc nhiều giải pháp khác nhau (vừa sửa code, vừa sửa Nginx, vừa đổi cấu hình MySQL) vì bạn sẽ không thể biết hành động nào mang lại kết quả hay tạo thêm lỗi mới.
- Không vội vàng bung bản backup đè lên production khi chưa đánh giá lượng dữ liệu mới phát sinh trong ngày có nguy cơ bị ghi đè mất mát.
Các bước cần làm sau khi hệ thống đã ổn định
Sau khi dập tắt sự cố, hãy dành thời gian thực hiện 3 việc quan trọng:
- Lưu trữ bằng chứng: Gom toàn bộ file log sự cố, ảnh chụp màn hình monitoring và dòng thời gian timeline vào một thư mục lưu trữ an toàn để phục vụ việc điều tra.
- Tìm nguyên nhân gốc rễ: Phân tích mã nguồn hoặc câu truy vấn SQL đã gây ra sự cố trong môi trường staging/test độc lập.
- Thực hiện Postmortem: Tổ chức buổi họp rút kinh nghiệm ngắn theo tinh thần không đổ lỗi (blameless postmortem) như hướng dẫn tại bài Viết postmortem sau sự cố website nhỏ nhằm cải tiến hệ thống giám sát và bổ sung các kịch bản phòng ngừa cho tương lai.
Checklist tóm tắt 30 phút đầu
- ☐ 0–5 phút: Kiểm tra thực tế từ bên ngoài, viết ra câu mô tả triệu chứng và phạm vi ảnh hưởng cụ thể.
- ☐ 5–10 phút: Tạm dừng các thay đổi có thể dừng an toàn, lập timeline sự kiện và chỉ định người điều phối.
- ☐ 10–20 phút: Khoanh vùng theo chuỗi DNS/SSL → Nginx → Backend → Database → Tài nguyên VPS.
- ☐ 20–30 phút: Áp dụng biện pháp hạ nhiệt có kiểm soát (rollback phiên bản, tạm dừng job nặng, hoặc restart dịch vụ đơn lẻ).
- ☐ Nghiệm thu từ mạng bên ngoài bằng tài khoản test, synthetic transaction hoặc một hành trình an toàn tương đương.
- ☐ Cập nhật thông tin cho các bên liên quan bằng dữ kiện thực tế, không đưa ETA cảm tính.
- ☐ Lưu trữ toàn bộ log lỗi và lên lịch phân tích postmortem sau sự cố.
Xử lý sự cố không phải là cuộc đua xem ai gõ lệnh nhanh hơn, mà là bài kiểm tra về tính kỷ luật và quy trình bài bản của người quản trị hệ thống.