Hãy thử nhớ lại lần gần nhất điện thoại của bạn rung lên vì một tin nhắn từ bot giám sát hệ thống:
[ALERT] Host: vps-prod-01 - CPU usage > 90%
Khi đọc được dòng tin nhắn này, câu hỏi đầu tiên nảy ra trong đầu bạn là gì? Có phải là: "Rồi sao nữa? Website có bị sập không? Khách hàng có bị lỗi không? Hay chỉ là script sao lưu đang chạy? Giờ mình phải vào đâu để kiểm tra?".
Đó là chân dung của một cảnh báo vô dụng. Nó chỉ ném vào mặt bạn một con số kỹ thuật màu đỏ, nhưng hoàn toàn không cho bạn biết chuyện gì đang thực sự diễn ra, mức độ khẩn cấp ra sao, và bước tiếp theo bạn cần làm là gì. Hậu quả là người trực ca phải mất cả chục phút mở máy tính, tìm kiếm dashboard, đăng nhập vào server để mò mẫm. Tệ hơn, nếu mỗi ngày có hàng chục tin nhắn mơ hồ như vậy gửi về, cả đội ngũ sẽ dần hình thành thói quen ngó lơ thông báo. Đến khi website sập thật, cảnh báo cứu mạng lại bị trôi mất giữa một đống tin nhắn rác.
Một cảnh báo có giá trị (Actionable Alert) phải tuân theo một nguyên tắc cốt tử: Mỗi thông báo phát ra bắt buộc phải dẫn tới một quyết định hoặc một hành động cụ thể. Nếu một chỉ số tăng cao nhưng bạn không cần phải làm gì cả, chỉ số đó thuộc về dashboard, không bao giờ được phép gửi tin nhắn đánh thức con người.
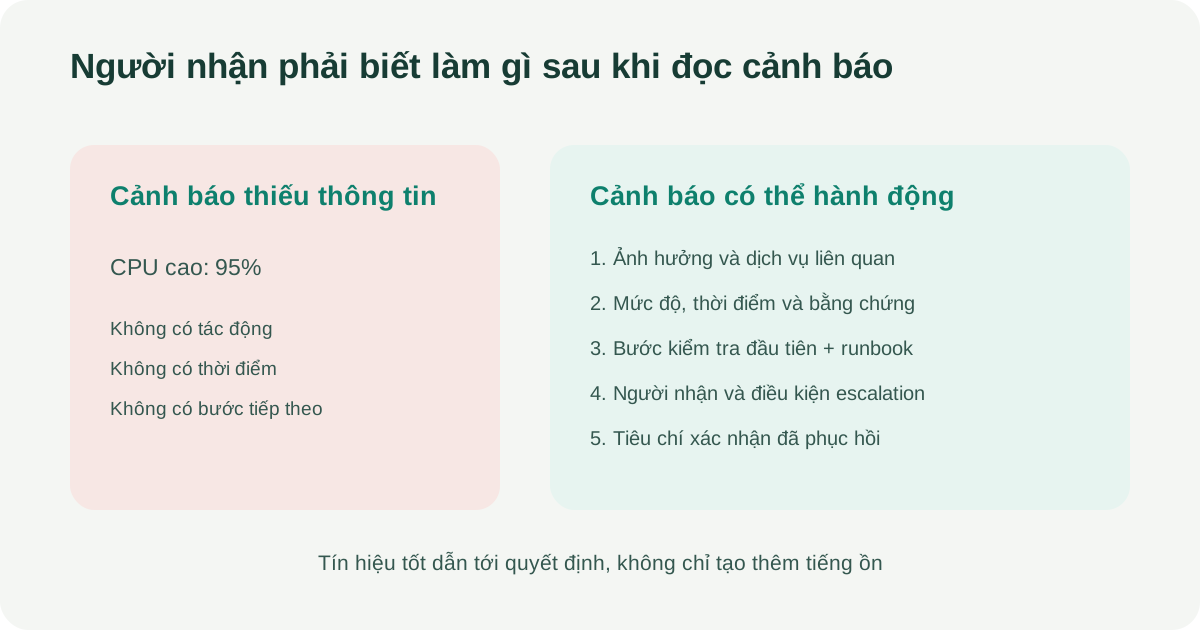
Một cảnh báo tốt phải giúp người nhận hiểu ảnh hưởng, bằng chứng và bước kiểm tra đầu tiên.
4 khái niệm thường bị đánh đồng trong vận hành
Trước khi viết bất kỳ quy tắc cảnh báo nào, bạn cần phân định rạch ròi 4 cấp độ này:
- Sự kiện (Event): Một việc vừa diễn ra trên hệ thống (một container vừa khởi động lại, bản deploy vừa hoàn tất, một câu query chạy mất 3 giây). Hầu hết các sự kiện chỉ cần ghi lại vào log, tuyệt đối không gửi tin nhắn.
- Cảnh báo (Alert): Một trạng thái bất thường kéo dài và có nguy cơ gây hại (tỷ lệ lỗi 5xx vượt 2% trong 5 phút, dung lượng ổ đĩa sắp đầy trong vòng 12 giờ tới). Đây là thứ cần con người đánh giá.
- Thông báo (Notification): Phương tiện chuyển alert tới con người (tin nhắn Telegram, Slack, email, hoặc còi báo động).
- Sự cố (Incident): Khi khách hàng đã thực sự bị ảnh hưởng gián đoạn (không thể thanh toán đơn hàng, website không vào được) và cần nhiều người phối hợp ứng cứu.
Nhầm lẫn giữa Event và Alert là nguyên nhân số một gây ra hiện tượng "ngập lụt thông báo" (Alert Fatigue).
5 thông tin bắt buộc phải có trong một tin nhắn cảnh báo
Khi có sự cố xảy ra lúc nửa đêm, người nhận thông báo đang trong trạng thái ngái ngủ và căng thẳng. Đừng bắt họ phải suy đoán hay giải mã các từ viết tắt kỹ thuật. Một tin nhắn chuẩn mực cần trả lời trọn vẹn 5 câu hỏi trong vòng 30 giây:
1. Chuyện gì đang xảy ra và ảnh hưởng đến ai? (Triệu chứng thực tế)
Thay vì đặt tên cảnh báo là HighErrorRate_Nginx, hãy viết rõ: [Lỗi] Trang thanh toán đang bị gián đoạn. Nói rõ người dùng có đặt được hàng không, hay website đang trả về mã lỗi gì.
2. Xảy ra ở đâu và mức độ nghiêm trọng thế nào?
Ghi rõ tên dịch vụ và môi trường (Production hay Staging). Tuyệt đối không để xảy ra tình trạng bot báo động ầm ĩ nhưng hóa ra là trên môi trường test của một bạn lập trình viên.
3. Bằng chứng cụ thể là gì?
Đưa ra con số thực tế kèm mốc thời gian: "Tỷ lệ lỗi 502 đạt 15% trong 5 phút vừa qua (bình thường < 0.1%)". Con số này giúp người nhận biết ngay đây là sự cố diện rộng hay chỉ là một đợt chập chờn nhỏ.
4. Bước kiểm tra đầu tiên là gì? (Kèm link runbook)
Đừng để người trực ca phải nhớ trong đầu các lệnh kiểm tra. Hãy đính kèm ngay đường link dẫn thẳng tới Dashboard tương ứng và một đường link tới tài liệu hướng dẫn xử lý (Runbook). Trong tin nhắn có thể gợi ý luôn một thao tác an toàn: "Kiểm tra trạng thái container app_web và kết nối database".
5. Khi nào cần báo động cho cấp trên (Escalation)?
Nếu sau 15 phút xử lý mà tình trạng không giảm, người trực ca cần liên hệ với ai tiếp theo?
So sánh trực quan hai cách viết cảnh báo:
- Cảnh báo tồi:
CRITICAL: Disk usage on server 192.168.1.10 > 85%
- Cảnh báo chuẩn chỉnh:
🔴 [CẤP BÁCH] Ổ đĩa máy chủ Web Production sắp đầy • Tác động: Ổ cứng còn 3.2 GB (đã dùng 88%), dự kiến đầy trong 8 giờ tới. • Hệ thống: VPS Web Chính (app-prod-01) • Bước đầu tiên: Kiểm tra thư mục log và file backup tạm theo runbook dọn đĩa. • Dashboard: [Link xem chi tiết] | Tài liệu xử lý: [Link Runbook] • Người phụ trách: Đội Hạ tầng / DevOps
Phân cấp cảnh báo: Đừng dùng chung một chiếc còi cho mọi việc
Không phải vấn đề nào cũng cần đánh thức kỹ sư lúc 2h sáng. Bạn nên phân chia thông báo thành 3 luồng xử lý riêng biệt:
| Mức độ | Điều kiện kích hoạt | Kênh nhận tin | Thời hạn xử lý |
|---|---|---|---|
| Báo động Đỏ (Critical / Pager) | Người dùng đang bị gián đoạn diện rộng (web sập, không thanh toán được), hoặc tài nguyên máy chủ sắp cạn trong 1–2 giờ tới. | Rung chuông điện thoại, gọi tự động, kênh Telegram khẩn cấp có bật âm thanh. | Can thiệp ngay lập tức trong vòng 5–15 phút. |
| Nhắc nhở (Warning / Ticket) | Hệ thống vẫn phục vụ khách tốt, nhưng có dấu hiệu hao hụt tài nguyên hoặc lỗi ngầm (SSL còn 14 ngày, backup đêm qua bị trễ, ổ đĩa còn đủ dùng 3 ngày). | Nhóm chat nội bộ trong giờ làm việc, hoặc tự động tạo ticket công việc trên Jira/Trello. | Xử lý trong giờ hành chính ngày hôm sau. |
| Theo dõi (Info / Dashboard) | Các chỉ số bình thường hoặc sự kiện thông tin (deploy xong phiên bản mới, cron job chạy mất 10 phút). | Lưu lại trên biểu đồ Dashboard, không gửi tin nhắn làm phiền. | Xem khi họp tuần hoặc khi cần đối chiếu dữ liệu. |
Để biết cách đặt các ngưỡng kích hoạt hợp lý cho từng loại phần cứng máy chủ, bạn có thể tham khảo bài Ngưỡng cảnh báo CPU, RAM và Disk cho VPS.
3 kỹ thuật giảm bớt thông báo rác (Alert Fatigue)
Để bảo vệ sự tập trung của đội ngũ kỹ thuật, hệ thống cảnh báo (như Prometheus Alertmanager hay Grafana Alerting) cần được cấu hình 3 bộ lọc quan trọng:
1. Gom nhóm thông báo (Grouping)
Nếu cơ sở dữ liệu bị sập, 10 dịch vụ phụ thuộc phía sau sẽ đồng loạt phát cảnh báo lỗi kết nối. Nếu không gom nhóm, điện thoại của bạn sẽ nhận 10 tin nhắn riêng lẻ trong vòng 5 giây. Cơ chế Grouping sẽ tự động gom các cảnh báo có cùng bản chất lại và chỉ gửi duy nhất một tin nhắn: "Phát hiện 10 dịch vụ đang mất kết nối cơ sở dữ liệu trên Production".
2. Ức chế cảnh báo phụ (Inhibition)
Khi toàn bộ máy chủ VPS bị mất mạng hoặc sập nguồn (Alert chính: HostDown), không có lý do gì để hệ thống tiếp tục gửi thêm các cảnh báo phụ như NginxDown, MySQLDown, hay SSLCheckFailed. Cơ chế Inhibition cho phép thiết lập: khi cảnh báo cấp máy chủ đang kêu, hãy tự động tắt tiếng toàn bộ các cảnh báo dịch vụ bên trong máy chủ đó.
3. Tạm tắt cảnh báo khi bảo trì (Silencing)
Khi bạn chủ động bảo trì hệ thống, nâng cấp phần mềm hoặc migrate database, hãy tạo một lệnh tạm tắt cảnh báo (Silence) trong vòng 30 phút hoặc 1 giờ cho đúng dịch vụ đó. Đừng tắt toàn bộ hệ thống giám sát, và hãy luôn đặt thời gian hết hạn cụ thể để tránh việc bảo trì xong mà quên không bật lại cảnh báo.
Đừng vội mừng khi thấy thông báo "Resolved"
Khi nhận được tin nhắn xanh báo [RESOLVED] Tỷ lệ lỗi đã hạ về mức bình thường, rất nhiều người vội vã tắt máy đi ngủ tiếp.
Thực tế, dòng chữ Resolved của công cụ giám sát chỉ có nghĩa là: Chỉ số đo lường trong 3 phút vừa qua tạm thời không còn vượt ngưỡng cấu hình.
Nó hoàn toàn không chứng minh được:
- Nguyên nhân gốc rễ đã biến mất (có thể traffic vừa tự nhiên giảm xuống nên lỗi tạm thời lắng dịu).
- Dữ liệu phát sinh trong lúc lỗi có bị mất mát hoặc sai lệch hay không.
- Các hàng đợi (queue) công việc bị dồn ứ đã được giải tỏa hết chưa.
Với các cảnh báo cấp bách, quy trình ứng cứu sự cố chỉ được coi là hoàn tất khi người trực ca đã vào website thật kiểm tra lại hành trình mua hàng của khách, và ghi lại nhật ký ngắn gọn về nguyên nhân sự cố. Bạn có thể tham khảo thêm Quy trình 30 phút đầu khi website gặp sự cố và Biên bản hậu sự cố (Postmortem) cho doanh nghiệp nhỏ để xây dựng văn hóa xử lý bài bản. Để có góc nhìn tổng thể về các tín hiệu và dịch vụ nào đáng được đặt cảnh báo, hãy xem bài trụ cột Nên monitoring những gì trên một VPS chạy website?.
Checklist rà soát hệ thống cảnh báo
- ☐ Mọi cảnh báo gửi về kênh chat đều có hành động xử lý cụ thể, không gửi các thông tin chỉ để "biết cho vui".
- ☐ Tên cảnh báo mô tả triệu chứng và tác động tới người dùng, không viết tắt tên biến kỹ thuật.
- ☐ Phân định rõ ràng giữa kênh khẩn cấp (báo động đỏ) và kênh công việc giờ hành chính (tạo ticket).
- ☐ Tin nhắn có đầy đủ mốc thời gian, môi trường, số liệu thực tế và đường dẫn tới Dashboard + Runbook.
- ☐ Đã cấu hình cơ chế gom nhóm (Grouping) và chặn cảnh báo phụ (Inhibition) khi máy chủ sập diện rộng.
- ☐ Có quy trình đặt lịch tạm ngắt cảnh báo (Silence) mỗi khi tiến hành bảo trì định kỳ.
- ☐ Kiểm thử định kỳ đường truyền tin nhắn (bắn thử test alert) để đảm bảo bot không bị chặn hoặc mất kết nối.
- ☐ Định kỳ hàng tháng rà soát lại các cảnh báo hay kêu nhất để tinh chỉnh lại ngưỡng hoặc sửa dứt điểm lỗi trong code.