Trong quá trình vận hành hạ tầng số, không ít đội ngũ kỹ thuật gặp phải một hiện tượng quen thuộc: hóa đơn thanh toán đám mây (AWS, DigitalOcean, Hetzner hoặc Cloud nội địa) tăng dần đều qua từng tháng dù lượng người dùng và số lượng máy chủ phục vụ ứng dụng hầu như không thay đổi.
Nguyên nhân phổ biến nhất không nằm ở mã nguồn hay lưu lượng mạng, mà đến từ các tài nguyên nhàn rỗi (Zombie / Orphaned Resources) bị bỏ quên. Trong các đợt thử nghiệm tính năng mới (POC), diễn tập cứu hộ hoặc nâng cấp phiên bản phần mềm, kỹ sư thường tạo thêm ổ đĩa phụ, chụp ảnh sao lưu tức thời (snapshot), hoặc cấp phát địa chỉ IP tĩnh dự phòng. Khi hoàn thành công việc, họ xóa máy chủ chính (Compute Instance) nhưng lại quên gỡ bỏ các tài nguyên độc lập đi kèm.
Khác với việc xử lý dung lượng ổ đĩa cục bộ trên VPS, tài nguyên đám mây độc lập được tính tiền liên tục 24/7 theo dung lượng cấp phát hoặc theo giờ giữ chỗ, bất kể máy chủ gắn với nó có còn tồn tại hay không.
Bài viết này hướng dẫn bạn cách nhận diện 4 nhóm tài nguyên dư thừa phổ biến nhất, quy trình 4 bước thu hồi an toàn để tránh xóa nhầm dữ liệu nghiệp vụ, và các câu lệnh CLI thực chiến giúp tự động hóa quá trình rà soát định kỳ.
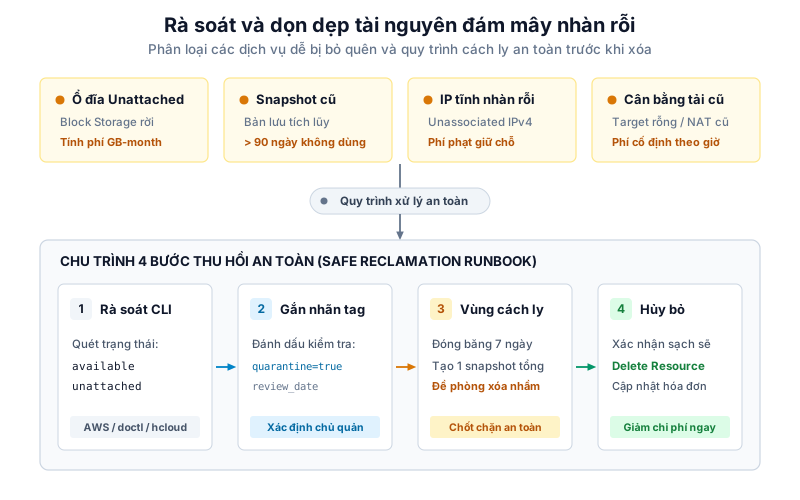
Bốn nhóm tài nguyên dư thừa âm thầm tiêu tốn ngân sách
Trên các nền tảng điện toán đám mây hiện đại, các dịch vụ lưu trữ và mạng được tách rời khỏi máy chủ để tăng tính linh hoạt. Khi một máy ảo bị xóa, các thành phần này không tự động biến mất nếu bạn không kích hoạt tùy chọn xóa kèm.
1. Ổ đĩa gắn ngoài không sử dụng (Unattached Block Storage)
Khi khởi tạo một máy chủ mới hoặc gắn thêm một phân vùng lưu trữ (AWS EBS, DigitalOcean Volume, Hetzner Volume), bạn thường có tùy chọn "Delete volume on termination". Nếu tùy chọn này bị bỏ qua, khi máy chủ bị hủy, ổ đĩa sẽ tự động chuyển sang trạng thái nhàn rỗi (available hoặc unattached).
- Cơ chế tính phí: Nhà cung cấp tính tiền dựa trên dung lượng được cấp phát (Provisioned Capacity) chứ không dựa trên lượng dữ liệu thực tế lưu bên trong.
- Tác động tài chính: Ổ đĩa chuẩn NVMe/SSD thông thường có giá khoảng 0.08 đến0.10/GB mỗi tháng. Một ổ đĩa 500GB được tạo ra để sao lưu tạm cơ sở dữ liệu trong một đêm bảo trì nếu bị lãng quên sẽ tiêu tốn từ 40 đến50 USD mỗi tháng (gần $600 USD mỗi năm).
2. Bản sao lưu tức thời tích lũy qua nhiều năm (Accumulated Snapshots)
Trước mỗi đợt triển khai phiên bản lớn, việc chụp snapshot toàn bộ hệ thống là thao tác chuẩn mực để phòng ngừa rủi ro. Tuy nhiên, sau khi phiên bản mới hoạt động ổn định, các bản snapshot này hiếm khi được lên lịch dọn dẹp.
- Cơ chế tính phí: Dù snapshot áp dụng cơ chế nén và lưu phần chênh lệch (Incremental), chi phí lưu trữ vẫn dao động từ 0.05 đến0.06/GB mỗi tháng.
- Tác động tài chính: Sau 1 đến 2 năm phát triển sản phẩm với hàng chục đợt phát hành, một tài khoản có thể tích lũy từ 1 TB đến 3 TB dung lượng snapshot cũ không còn giá trị sử dụng, gây lãng phí hàng trăm USD mỗi tháng.
3. Địa chỉ IP công cộng tĩnh nhàn rỗi (Idle / Unassociated Public IPs)
Do nguồn tài nguyên địa chỉ IPv4 toàn cầu đã cạn kiệt, các nhà cung cấp đám mây áp dụng chính sách tính phí đối với các địa chỉ IP tĩnh (Elastic IP, Floating IP) đã được cấp phát nhưng không gắn vào bất kỳ máy chủ nào đang chạy.
- Cơ chế tính phí: AWS áp dụng mức phí 0.005 cho mỗi giờ giữ chỗ một địa chỉ IPv4 không sử dụng (~3.6 USD/tháng cho mỗi IP).
- Tác động tài chính: Nhiều dự án sau khi hoàn tất giai đoạn thử nghiệm đã giải phóng máy chủ nhưng vẫn giữ lại 3 đến 5 địa chỉ IP dự phòng, khiến doanh nghiệp phải trả thêm một khoản phí phạt hoàn toàn vô nghĩa.
4. Bộ cân bằng tải và Cổng mạng bỏ quên (Zombie Load Balancers & Gateways)
Các bộ cân bằng tải (như AWS Application Load Balancer - ALB) được tạo ra cho các môi trường thử nghiệm tạm thời, hoặc trỏ vào các Target Group không còn máy chủ nào hoạt động (Healthy Hosts = 0).
- Cơ chế tính phí: ALB duy trì mức phí cố định từ 16.2 đến22.5 USD mỗi tháng chỉ riêng cho chi phí chạy cụm cân bằng tải, chưa tính chi phí mạng.
- Tương tự, một NAT Gateway được tạo trong Private Subnet của môi trường staging không còn dùng tới vẫn âm thầm tiêu tốn khoảng $32.4 USD mỗi tháng.
Quy trình 4 bước thu hồi an toàn (Safe Reclamation Runbook)
Nguyên tắc quan trọng nhất trong quản trị chi phí (FinOps) là: Tối ưu ngân sách không được tạo ra rủi ro gián đoạn dịch vụ hoặc mất mát dữ liệu. Việc xóa ngay lập tức một ổ đĩa nghi ngờ không còn sử dụng có thể làm mất dữ liệu quan trọng nếu ổ đĩa đó chứa tệp lưu trữ lịch sử được cố tình tháo rời.
Để đảm bảo an toàn, bạn nên áp dụng quy trình 4 bước sau:
  [ Bước 1: Rà soát & Lọc ]
  Sử dụng CLI quét toàn bộ tài nguyên ở trạng thái available / unattached.
            │
            ▼
  [ Bước 2: Gắn nhãn cách ly ]
  Gán tag: quarantine=true và review_date=YYYY-MM-DD.
            │
            ▼
  [ Bước 3: Đóng băng 7 ngày & Snapshot chốt chặn ]
  Tạo 1 bản snapshot tổng hợp giá rẻ, ngắt hoàn toàn kết nối trong 7 ngày.
            │
            ▼
  [ Bước 4: Hủy bỏ vĩnh viễn ]
  Xóa tài nguyên sau khi qua thời gian cách ly mà không có phản hồi sự cố.
Bước 1: Rà soát và lập danh mục (Audit & Discovery)
Sử dụng các công cụ dòng lệnh (CLI) chính thức của nhà cung cấp để quét toàn bộ các Region trong tài khoản. Xuất danh sách tài nguyên thỏa mãn các điều kiện:
- Volume:
status == available(chưa gắn vào máy chủ nào). - IP tĩnh:
AssociationId == null(chưa liên kết với máy chủ nào). - Snapshot: Thời gian tạo trên 90 ngày và mô tả không thuộc các bản sao lưu định kỳ chính thức theo nguyên tắc sao lưu dữ liệu có trạng thái.
- Load Balancer: Target Group có
HealthyHostCount == 0.
Bước 2: Gắn nhãn phân loại cách ly (Tagging for Deprecation)
Không thực hiện lệnh xóa ngay. Hãy gắn nhãn (Tag) lên từng tài nguyên nghi ngờ để thông báo cho các bên liên quan:
quarantine=truereview_date=2026-11-05owner=team-backend
Sau khi gắn tag, gửi danh sách này vào kênh trao đổi nội bộ của đội ngũ kỹ thuật để các nhóm dự án xác nhận quyền sở hữu.
Bước 3: Đóng băng 7 ngày và tạo snapshot chốt chặn (Quarantine Period)
Đối với các ổ đĩa dữ liệu (Block Storage), trước khi xóa, bạn nên tạo duy nhất một bản snapshot tổng hợp của ổ đĩa đó rồi gắn tag lưu trữ dài hạn. Bản snapshot này chỉ tiêu tốn chi phí rất nhỏ so với việc duy trì toàn bộ ổ đĩa block storage tốc độ cao.
Giữ tài nguyên trong vùng cách ly 7 ngày:
- Nếu trong 7 ngày không có dịch vụ nào báo lỗi hoặc không có kỹ sư nào phản hồi cần dùng lại, tài nguyên được xác nhận là dư thừa thực sự.
- Nếu có phản hồi cần giữ lại, bạn gỡ nhãn cách ly và yêu cầu nhóm phụ trách gắn tag dự án cụ thể.
Bước 4: Thu hồi vĩnh viễn (Permanent Deletion)
Sau khi thời hạn 7 ngày kết thúc, tiến hành chạy lệnh xóa tài nguyên. Sau khi xóa, ghi nhận lại dung lượng và chi phí đã cắt giảm để đối chiếu với hóa đơn chu kỳ tiếp theo.
Hướng dẫn kỹ thuật rà soát chi tiết bằng CLI
Việc đăng nhập vào giao diện web console để bấm kiểm tra từng vùng địa lý (Region) rất tốn thời gian và dễ bỏ sót. Sử dụng CLI giúp bạn hoàn tất việc kiểm toán toàn bộ tài khoản chỉ trong vài phút.
1. Nền tảng AWS (sử dụng AWS CLI)
Rà soát ổ đĩa EBS không gắn máy chủ:
Lệnh sau đây tìm kiếm toàn bộ ổ đĩa đang ở trạng thái available:
# Liệt kê Volume chưa gắn vào EC2 nào kèm dung lượng và thời gian tạo
aws ec2 describe-volumes \
    --filters Name=status,Values=available \
    --query 'Volumes[*].[VolumeId,Size,VolumeType,CreateTime]' \
    --output table
Rà soát Elastic IP chưa liên kết:
Lệnh sau tìm các địa chỉ IP tĩnh không có mã liên kết máy chủ (AssociationId rỗng):
# Liệt kê Elastic IP đang nhàn rỗi gây phát sinh phí phạt
aws ec2 describe-addresses \
    --query 'Addresses[?AssociationId==null].[PublicIp,AllocationId]' \
    --output table
Sau khi xác định IP không còn dùng, giải phóng địa chỉ bằng lệnh:
aws ec2 release-address --allocation-id <ALLOCATION_ID>Rà soát Snapshot cũ tích lũy:
Lọc danh sách các bản snapshot do tài khoản tự tạo (bỏ qua snapshot của AMI công cộng) có tuổi đời trên 90 ngày:
# Thay đổi ngày tháng phù hợp với mốc 90 ngày trước
aws ec2 describe-snapshots \
    --owner-ids self \
    --query 'Snapshots[?StartTime<=`2026-07-30`].[SnapshotId,VolumeSize,StartTime,Description]' \
    --output table
Rà soát Application Load Balancer không có máy chủ hoạt động:
# Kiểm tra số lượng mục tiêu khỏe mạnh trong từng Target Group
aws elbv2 describe-target-groups \
    --query 'TargetGroups[*].[TargetGroupArn,TargetGroupName,Port]' \
    --output table
2. Nền tảng DigitalOcean (sử dụng doctl)
Cài đặt công cụ dòng lệnh doctl và thực hiện các lệnh kiểm tra:
# 1. Liệt kê các Volume không gắn Droplet nào (cột DropletIDs để trống)
doctl compute volume list --format ID,Name,Size,DropletIDs

# 2. Liệt kê Floating IP không gán máy chủ
doctl compute floating-ip list --format IP,DropletID,Region

# 3. Liệt kê các bản Snapshot cũ của Volume
doctl compute snapshot list --resource volume --format ID,Name,CreatedAt,MinDiskSize
Để xóa một volume không còn sử dụng sau khi đã xác nhận an toàn:
doctl compute volume delete <VOLUME_ID> --force3. Nền tảng Hetzner Cloud (sử dụng hcloud)
Hetzner Cloud cung cấp công cụ dòng lệnh hcloud rất trực quan:
# 1. Liệt kê toàn bộ Volume (kiểm tra cột SERVER, nếu để trống là unattached)
hcloud volume list

# 2. Liệt kê các địa chỉ Primary IP (kiểm tra cột ASSIGNED TO)
hcloud primary-ip list
Tự động hóa cảnh báo tài nguyên dư thừa
Thay vì chờ đến cuối tháng mới kiểm tra hóa đơn, bạn có thể thiết lập một script shell nhẹ chạy định kỳ hàng tuần qua cronjob để gửi thông báo trực tiếp về kênh Telegram của nhóm vận hành.
Tạo tệp kịch bản /opt/scripts/audit-orphan-resources.sh:
#!/usr/bin/env bash
set -euo pipefail

# Lấy danh sách ID của các ổ đĩa unattached
UNATTACHED_VOLUMES=$(aws ec2 describe-volumes \
    --filters Name=status,Values=available \
    --query 'Volumes[*].VolumeId' \
    --output text)

# Lấy danh sách IP tĩnh nhàn rỗi
IDLE_IPS=$(aws ec2 describe-addresses \
    --query 'Addresses[?AssociationId==null].PublicIp' \
    --output text)

MESSAGE="Báo cáo tài nguyên nhàn rỗi hàng tuần:"

if [ -n "$UNATTACHED_VOLUMES" ]; then
    MESSAGE="${MESSAGE}\n- Phát hiện ổ đĩa unattached: ${UNATTACHED_VOLUMES}"
fi

if [ -n "$IDLE_IPS" ]; then
    MESSAGE="${MESSAGE}\n- Phát hiện IP tĩnh chưa gán máy chủ: ${IDLE_IPS}"
fi

# Nếu có tài nguyên dư thừa, gửi thông báo qua webhook Telegram
if [ -n "$UNATTACHED_VOLUMES" ] || [ -n "$IDLE_IPS" ]; then
    curl -s -X POST "https://api.telegram.org/bot<BOT_TOKEN>/sendMessage" \
        -d "chat_id=<CHAT_ID>" \
        -d "text=${MESSAGE}" > /dev/null
fi
Cấp quyền thực thi và đưa vào cronjob chạy vào 09:00 sáng mỗi thứ Hai hàng tuần:
chmod +x /opt/scripts/audit-orphan-resources.sh
# Mở crontab để thêm lịch chạy
# 0 9 * * 1 /opt/scripts/audit-orphan-resources.sh
Tiêu chí nghiệm thu và thiết lập phòng ngừa dài hạn
Để việc dọn dẹp tài nguyên dư thừa không trở thành công việc chữa cháy lặp đi lặp lại, đội ngũ kỹ thuật cần thiết lập các nguyên tắc phòng ngừa ngay từ khâu khởi tạo:
- Thiết lập mặc định
Delete on Termination: Khi viết mã hạ tầng (Terraform, CloudFormation hoặc template máy chủ), luôn đặt thuộc tínhdelete_on_termination = truecho các ổ đĩa hệ điều hành và ổ đĩa dữ liệu gắn liền với vòng đời máy chủ. - Chính sách gắn nhãn tài nguyên (Tagging Policy): Mọi tài nguyên được khởi tạo (máy chủ, ổ đĩa, IP) nên được gắn thẻ nhận diện
Environment(prod/staging/poc) vàOwner(tên người phụ trách). Các tài nguyên thiếu nhãn định danh sẽ tự động được đưa vào danh sách rà soát sau 48 giờ. - Chính sách vòng đời cho Snapshot (Lifecycle Policy): Sử dụng AWS Data Lifecycle Manager (DLM) hoặc cronjob để tự động hủy các bản snapshot quá 30 ngày, chỉ giữ lại các mốc sao lưu tuần và tháng theo đúng kế hoạch phục hồi thảm họa.
Sau khi hoàn thành đợt dọn dẹp đầu tiên, bạn sẽ thấy tổng chi phí lưu trữ và mạng trên bảng kê khai giảm rõ rệt ngay trong chu kỳ thanh toán tiếp theo.
Các bài viết tiếp theo trong cụm quản trị chi phí
Sau khi đã thu hồi các khoản lãng phí từ tài nguyên dư thừa, bước tối ưu tiếp theo là phân tích sâu vào cấu hình phần cứng của các máy chủ đang hoạt động:
- Xem bài Tối ưu cấu hình VPS theo số liệu telemetry 30 ngày (
HTS-115) để nhận diện hiện tượng over-provisioning (thuê máy chủ quá thừa vCPU/RAM) và đưa cấu hình về đúng nhu cầu thực tế. - Tham khảo bài Kiến trúc lai Hybrid VPS và Cloudflare tối ưu chi phí hạ tầng (
HTS-113) để giải phóng băng thông và tải CPU cho máy chủ gốc. - Áp dụng Checklist kiểm soát chi phí hạ tầng doanh nghiệp (
HTS-116) vào quy trình kiểm toán tài chính định kỳ hàng tháng.