Nhóm chăm sóc khách hàng của bạn mỗi tháng nhận khoảng vài trăm yêu cầu hỗ trợ qua email và biểu mẫu website. Trong cuộc họp tuần, có thành viên đề xuất tích hợp một mô hình ngôn ngữ lớn (LLM) để đọc nội dung thư, tự phân loại và chuyển thẳng tới bộ phận kỹ thuật hoặc kế toán. Ý tưởng nghe rất hấp dẫn: nhân viên đỡ phải đọc từng bức thư dài, còn AI thì xử lý văn bản rất nhanh.
Tuy nhiên, “dùng AI phân loại yêu cầu” chỉ là một mong muốn, chưa phải một bài toán hoàn chỉnh. Nhóm đang có bao nhiêu luồng xử lý? Những trường hợp nào nhân viên hay phân loại nhầm? Nếu chuyển sai một sự cố máy chủ sang hòm thư kế toán thì hậu quả gián đoạn sẽ thế nào? Hiện tại con người đang mất bao nhiêu phút cho mỗi thư và tỷ lệ chính xác là bao nhiêu?
Nếu bắt tay vào làm mà chưa trả lời được những câu hỏi này, nhóm rất dễ rơi vào cái bẫy quen thuộc: tìm một công cụ hoặc một API thật nhanh, chạy thử vài bức thư mẫu thấy kết quả vừa mắt, rồi sau đó mới chật vật tìm cách chứng minh nó thực sự giúp ích cho công việc.
Cách tiếp cận an toàn hơn là đi từ thực tế vận hành. Bạn cần ghi lại chính xác vấn đề đang nghẽn ở đâu, tiêu chí nào chứng minh kết quả chấp nhận được, rồi mới xem xét liệu AI có phải giải pháp phù hợp hơn một quy tắc lọc cố định hay không. Mọi use case AI nên được kiểm tra qua ba cổng: vấn đề có đủ rõ, AI có thực sự cần và thử nghiệm có kiểm soát được rủi ro hay không. Kết quả có thể là bắt đầu thử, thu hẹp bài toán lại hoặc tiếp tục làm theo cách cũ. Quyết định nào cũng giúp nhóm tiết kiệm thời gian và nguồn lực.
Khoanh vùng bài toán trước khi quan tâm tới model
Khi nhắc đến AI, phản xạ đầu tiên thường là so sánh giá API, chọn model nào thông minh nhất hoặc context window chứa được bao nhiêu trang tài liệu. Những thông số kỹ thuật này chỉ có ý nghĩa khi bạn đã biết chính xác AI sẽ nhận việc gì và ai là người chịu trách nhiệm cuối cùng.
Một đề bài chung chung như “dùng AI xử lý yêu cầu hỗ trợ” rất dễ thất bại vì phạm vi quá rộng. Nó có thể là đọc hiểu để gợi ý bài viết trợ giúp, tóm tắt nội dung trao đổi, trích xuất mã lỗi hệ thống hay tự động gửi thư trả lời cho khách. Mỗi nhiệm vụ đòi hỏi dữ liệu khác nhau và mức độ rủi ro khi model trả lời sai cũng hoàn toàn khác nhau.
Thay vì ôm đồm, hãy thu gọn ý tưởng thành một câu mô tả hành động cụ thể:
AI đọc nội dung yêu cầu hỗ trợ (đã xóa toàn bộ thông tin tài khoản và mật khẩu), đề xuất một trong sáu nhóm xử lý kèm một dòng lý do tóm tắt. Nhân viên trực ca kiểm tra lại gợi ý đó trước khi bấm nút chuyển tiếp.
Câu mô tả này xác định rõ dữ liệu đầu vào là gì, AI làm một việc duy nhất nào, kết quả trông ra sao và con người vẫn giữ quyền kiểm soát ở đâu.
Để nhóm cùng nhìn về một hướng, bạn có thể tóm tắt use case qua bảng bảy thông tin cốt lõi:
| Thông tin | Nội dung cần xác định rõ |
|---|---|
| Vấn đề | Điểm đang chậm, hay nhầm lẫn hoặc tốn nhiều thời gian nhất hiện nay |
| Người sử dụng | Ai trực tiếp đọc kết quả của AI và ai chịu ảnh hưởng khi kết quả đó sai |
| Dữ liệu đầu vào (Input) | Dữ liệu lấy từ đâu, định dạng gì và có được phép chia sẻ cho công cụ bên ngoài không |
| Nhiệm vụ (Task) | Một thao tác duy nhất giao cho AI (như trích xuất, phân loại hoặc tóm tắt) |
| Kết quả đầu ra (Output) | Định dạng dữ liệu cụ thể và hệ thống nào sẽ tiếp nhận kết quả này |
| Tiêu chí đạt | Mốc chất lượng cụ thể so với năng suất của con người hiện tại |
| Kiểm soát rủi ro | Ai là người duyệt, phương án dự phòng khi lỗi và dấu hiệu nào buộc dừng lại |
Nếu nhóm chưa thể điền rõ hai mục cuối cùng (Tiêu chí đạt và Kiểm soát rủi ro), việc mở ngay tài khoản AI hay tải tài liệu thật lên công cụ là quá vội vàng. Một kết quả trả lời trôi chảy trong vài lần thử nghiệm ban đầu không thể thay thế cho tiêu chí đo lường và người chịu trách nhiệm khi có sự cố.
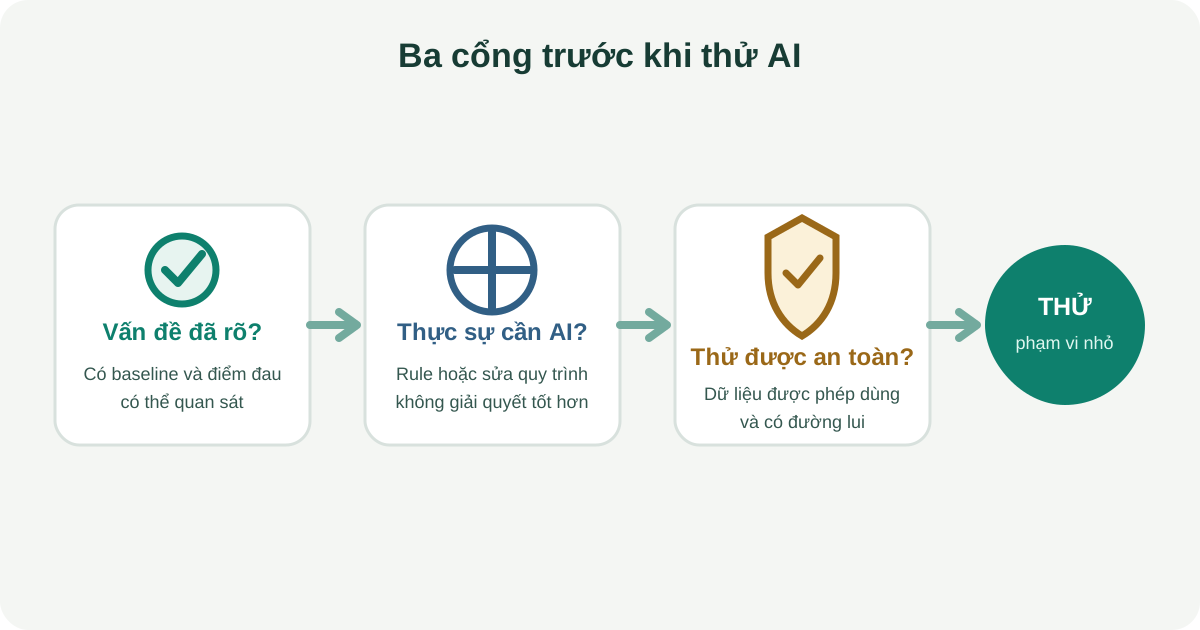
Cổng 1: Vấn đề hiện tại đã có số liệu đo lường cụ thể chưa?
Khi bàn về khó khăn trong quy trình, chúng ta thường nghe những nhận xét chung chung như “nhân viên mất quá nhiều thời gian đọc thư” hoặc “khách hàng phàn nàn phản hồi bị chậm”. Để làm cơ sở đối chiếu sau này, cảm nhận đó phải được quy đổi thành các con số quan sát được:
- Mỗi tuần nhóm nhận trung bình bao nhiêu yêu cầu?
- Một nhân viên mất khoảng bao nhiêu phút để đọc, xác định vấn đề và chọn nhóm xử lý?
- Tỷ lệ thư bị chuyển nhầm bộ phận là bao nhiêu, và những trường hợp nhầm lẫn đó thường rơi vào tình huống nào?
Bộ số liệu này chính là mốc tham chiếu (baseline). Nếu không có mốc này, khi tích hợp thử nghiệm một mô hình AI thấy nó phản hồi sau ba giây, bạn rất dễ lầm tưởng quy trình đã được rút ngắn. Trên thực tế, tổng thời gian xử lý còn bao gồm việc nhân viên phải đọc lại gợi ý của AI, sửa các nhãn bị gán sai, định dạng lại nội dung hoặc xử lý hậu quả khi một yêu cầu khẩn cấp bị phân loại thành mức ưu tiên thấp.
Khi ghi lại hiện trạng, hãy đặc biệt chú ý đến những “ngữ cảnh ngầm” của con người. Có những bức thư nhân viên phân loại rất chính xác chỉ vì họ nhận ra biệt danh của một dự án nội bộ, nhớ tên một khách hàng quen hoặc cảm nhận được mức độ bức xúc qua cách ngắt câu. Những dữ kiện đó hoàn toàn không nằm trong các trường dữ liệu tiêu chuẩn. Nếu không được cung cấp đầy đủ ngữ cảnh này, AI sẽ chỉ phán đoán dựa trên bề mặt câu chữ và rất dễ đưa ra gợi ý sai lệch.
Mức độ rủi ro cũng phụ thuộc vào người nhận kết quả. Một bản ghi chú gợi ý để nhân viên tham khảo trước khi trả lời có thể chấp nhận đôi chút sai sót nhỏ. Nhưng nếu kết quả của AI được dùng để tự động từ chối yêu cầu bảo hành hoặc khóa tài khoản nghi vấn, cái giá phải trả cho một lần phán đoán sai là rất lớn. Hậu quả khi thông tin sai lệch sẽ quyết định mức độ thận trọng bạn cần chuẩn bị cho thử nghiệm.
Cổng 2: Công việc này có thực sự cần đến AI không?
Mô hình AI phát huy hiệu quả tốt nhất khi phải xử lý văn bản tự do, ngôn ngữ tự nhiên không theo quy chuẩn, hoặc đưa ra các đề xuất mang tính xác suất. Nhưng điều đó không đồng nghĩa với việc cứ có văn bản là phải dùng đến AI.
Giả sử hệ thống hỗ trợ của bạn cho phép khách hàng chọn sẵn sản phẩm và danh mục lỗi qua các menu thả xuống trên biểu mẫu. Khi đó, một kịch bản định tuyến theo quy tắc cố định (rule-based) sẽ chuyển tiếp thư nhanh hơn, chi phí gần như bằng không và luôn cho kết quả giống hệt nhau ở mọi lần chạy. Nếu vấn đề bắt nguồn từ việc khách hàng hay chọn sai danh mục, việc sắp xếp lại các trường nhập liệu trên giao diện web thường mang lại hiệu quả cao hơn nhiều so với việc đưa thêm một mô hình ngôn ngữ vào giữa quy trình.
Trước khi chọn giải pháp AI, hãy đặt nó cạnh các phương án đơn giản hơn:
- Biểu mẫu nhập liệu có thể cải tiến để thu thập đúng thông tin ngay từ đầu không?
- Bộ lọc theo từ khóa hoặc các thẻ phân loại có sẵn đã đủ giải quyết vấn đề chưa?
- Một mẫu trả lời chuẩn (template) có giúp nhân viên phản hồi nhanh và đồng đều hơn không?
- Toàn bộ quy trình cần AI xử lý hay chỉ có một bước đọc hiểu nội dung tự do là cần đến nó?
Phần lớn các thử nghiệm thành công không thay thế toàn bộ con người hay toàn bộ quy trình bằng AI. Trong ví dụ về xử lý thư hỗ trợ, bạn có thể để AI đọc bức thư dài để trích xuất ba thông tin: phiên bản ứng dụng, triệu chứng lỗi và mã dịch vụ. Sau khi có ba trường dữ liệu rõ ràng, một workflow automation theo luật cố định sẽ tiếp nhận để kiểm tra điều kiện bảo hành và gán việc cho kỹ thuật viên.
Cách phân chia này giúp bạn tận dụng được thế mạnh đọc hiểu của AI, trong khi các bước ra quyết định quan trọng, phân quyền và ghi nhận lịch sử xử lý vẫn nằm trọn trong tầm kiểm soát của hệ thống.
Cổng 3: Thử nghiệm có kiểm soát được dữ liệu và rủi ro không?
Sau khi xác định bài toán đủ rõ và AI thực sự có đất diễn, bạn vẫn chưa nên bật thử nghiệm trên luồng công việc thực tế. Giai đoạn này cần một không gian an toàn để quan sát cách mô hình xử lý cả những tình huống thuận lợi lẫn các ca khó.
Điểm quan trọng đầu tiên là quyền sử dụng dữ liệu. Việc bạn có quyền truy cập một tài liệu hoặc đọc hòm thư hỗ trợ trong nội bộ không đồng nghĩa với việc bạn được phép tải toàn bộ nội dung đó lên một dịch vụ AI bên ngoài. Nhiều công cụ đám mây có điều khoản sử dụng dữ liệu để huấn luyện lại mô hình, hoặc lưu trữ tạm thời trên máy chủ ở khu vực khác. Trong giai đoạn thử nghiệm ban đầu, hãy dùng dữ liệu giả lập hoặc một tập mẫu đã được lược bỏ toàn bộ số điện thoại, địa chỉ, mật khẩu và thông tin hợp đồng.
Tiếp theo, hãy xây dựng một bộ mẫu thử nghiệm có chủ đích. Nếu chỉ chọn những bức thư ngắn, viết rõ ràng và dùng từ ngữ chuẩn mực, bạn sẽ có một kết quả thử nghiệm rất đẹp nhưng vô dụng khi đưa vào vận hành thật. Một bộ mẫu đáng tin cậy cho bài toán phân loại thư cần bao gồm:
- Những yêu cầu điển hình thường gặp mỗi ngày.
- Thư quá ngắn (chỉ có vài từ cụt lủn) hoặc thư quá dài (mô tả nhiều vấn đề cùng lúc).
- Nội dung chứa từ viết tắt của dự án hoặc thuật ngữ kỹ thuật đặc thù.
- Các trường hợp ranh giới, nơi nội dung vừa liên quan đến kỹ thuật vừa dính dáng đến thanh toán.
- Những tình huống mơ hồ mà hành động đúng của AI là thông báo “chưa đủ thông tin” thay vì cố đoán bừa.
Bạn cũng cần thống nhất tiêu chí đánh giá (rubric) trước khi nhìn vào câu trả lời của mô hình. Văn phong trôi chảy, ngữ pháp chuẩn của AI rất dễ tạo ra ảo giác tin cậy, khiến người đánh giá hạ thấp tiêu chuẩn ban đầu. Khi phân loại yêu cầu, hãy đo riêng tỷ lệ chính xác của từng nhóm, đặc biệt là nhóm sự cố nghiêm trọng. Một mô hình phân loại đúng 90% thư thông thường nhưng nhầm 2 trong số 5 sự cố máy chủ khẩn cấp thì không thể coi là đạt yêu cầu.
Trong toàn bộ đợt thử nghiệm đầu tiên, kết quả của AI chỉ nên dừng ở mức đề xuất nội bộ. Không cấp quyền cho mô hình tự bấm gửi thư tới khách hàng, tự ghi đè cơ sở dữ liệu hay kích hoạt các lệnh thay đổi hệ thống. Người kiểm tra cần nhìn thấy đồng thời nội dung thư gốc, gợi ý của AI và lý do ngắn gọn mà mô hình đưa ra trước khi quyết định áp dụng.
Bảng sàng lọc nhanh bốn tình huống thực tế
Bảng dưới đây minh họa cách cùng một công nghệ AI có thể dẫn đến các quyết định rất khác nhau tùy thuộc vào mức độ rủi ro và khả năng kiểm soát của con người:
| Tình huống dự kiến | Khả năng kiểm tra và đo lường | Rủi ro chính khi mô hình sai | Quyết định ban đầu |
|---|---|---|---|
| Gợi ý phân loại thư hỗ trợ, nhân viên trực ca bấm nút xác nhận | Dễ đo tỷ lệ nhân viên phải chọn lại nhóm | Lộ dữ liệu riêng tư, chuyển nhầm luồng xử lý | Thử nghiệm với tập dữ liệu đã làm sạch |
| Tạo bản nháp tóm tắt lỗi, kèm đường dẫn tới tài liệu kỹ thuật gốc | Nhân viên đối chiếu được từng dòng tóm tắt với tài liệu | Bỏ sót điều kiện quan trọng, tự bổ sung chi tiết sai | Thử nghiệm trên các tài liệu nội bộ ít nhạy cảm |
| Tự động gửi câu trả lời cho khách sau khi đọc nội dung thắc mắc | Rất khó kiểm soát toàn bộ câu chữ mà mô hình sinh ra | Khách hàng nhận hướng dẫn sai, ảnh hưởng uy tín dịch vụ | Thu hẹp lại thành việc tạo bản nháp cho nhân viên duyệt |
| Tự động duyệt hoàn tiền hoặc tự xóa bản ghi khi thấy có yêu cầu | Có thể ghi log hành động nhưng tổn thất tài chính khó thu hồi | Thiệt hại tài sản, mất dữ liệu không thể phục hồi | Chưa dùng AI cho khâu ra quyết định và thực thi |
Quyết định Chưa dùng AI hay Thu hẹp lại không có nghĩa là đóng cửa vĩnh viễn với công nghệ này. Nó giúp bạn đặt AI vào đúng vị trí hỗ trợ chuẩn bị thông tin, thay vì giao cho nó quyền hành động vượt quá khả năng giám sát của quy trình hiện tại.
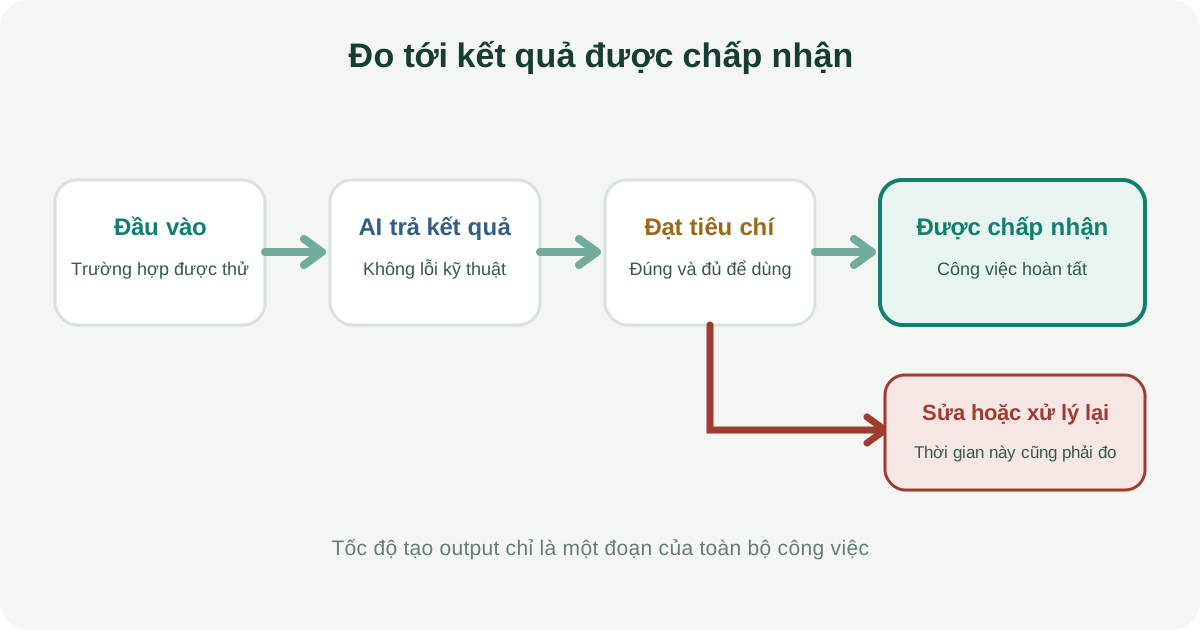
Đo lường kết quả được chấp nhận, không chỉ nhìn tốc độ trả lời
Một mô hình AI có thể tạo ra bản gợi ý phân loại chỉ sau năm giây. Tuy nhiên, nếu nhân viên phải mất thêm ba phút để đọc lại từng bức thư và kiểm tra xem gợi ý đó có đáng tin cậy hay không, tổng thời gian xử lý thực tế có thể còn chậm hơn cách làm cũ.
Để đánh giá chính xác giá trị của thử nghiệm, bạn cần theo dõi toàn bộ đường đi từ khi nhận dữ liệu đầu vào cho đến lúc kết quả được con người nghiệm thu:
- Tổng thời gian xử lý một trường hợp, bao gồm thời gian AI phản hồi và thời gian nhân viên đọc duyệt.
- Tỷ lệ gợi ý được chấp nhận ngay, tỷ lệ phải sửa lại và số trường hợp phải hủy hoàn toàn.
- Tần suất xuất hiện của các lỗi nghiêm trọng, ví dụ sự cố hệ thống bị xếp nhầm thành thư rác.
- Chi phí công cụ hoặc cước API tính trên mỗi kết quả thực sự dùng được trong công việc.
- Số lần hệ thống mất kết nối hoặc trả về kết quả sai định dạng khiến quy trình bị nghẽn.
Mỗi loại công việc cần một thước đo riêng. Với bài toán phân loại, tỷ lệ gán nhãn đúng là chỉ số chính. Nhưng với việc tóm tắt nội dung, tiêu chí quan trọng lại là độ đầy đủ của các dữ kiện chính, không bịa thêm chi tiết ngoài tài liệu và giúp người đọc nắm bắt vấn đề nhanh hơn. Hãy tránh việc gộp tất cả các chỉ số thành một điểm số trung bình duy nhất, vì điểm trung bình rất dễ che giấu những sai sót mang tính rủi ro cao.
Chuẩn bị đường lui trước khi mở rộng quy trình
Trong suốt giai đoạn thử nghiệm, quy trình làm việc thủ công hiện tại vẫn phải được duy trì song song để làm phương án dự phòng (fallback). Khi mô hình gặp sự cố, phản hồi chậm hoặc trả về định dạng lỗi, hệ thống phải tự động chuyển tiếp thư về hòm thư chung để nhân viên tiếp quản bình thường mà không làm thất lạc yêu cầu của khách hàng.
Bạn nên chủ động tạm dừng hoặc thu hẹp quy mô thử nghiệm nếu gặp phải một trong các dấu hiệu sau:
- Chưa thể làm rõ quyền sử dụng dữ liệu hoặc phát hiện dữ liệu nhạy cảm bị đưa vào yêu cầu.
- Nhóm thiếu người có đủ chuyên môn nghiệp vụ để đánh giá đúng - sai của kết quả.
- Kết quả sai lệch của AI quá tinh vi, nhân viên khó phát hiện nếu không kiểm tra đối chiếu mất nhiều thời gian.
- Công sức bỏ ra để rà soát và chỉnh sửa lớn hơn thời gian tiết kiệm được.
- Để thử nghiệm chạy được, bắt buộc phải cấp ngay quyền gửi thư trực tiếp hoặc quyền ghi dữ liệu.
Khi đưa một bước AI vào hệ thống, hãy đối xử với API của mô hình giống như bất kỳ dịch vụ bên ngoài nào khác. Kết nối có thể chập chờn, phản hồi có thể quá hạn và định dạng trả về có thể thay đổi sau mỗi lần nhà cung cấp cập nhật phiên bản. Bạn có thể áp dụng các nguyên tắc trong bài xử lý workflow lỗi giữa chừng để thiết lập thời gian chờ (timeout), giới hạn số lần thử lại và ghi log đầy đủ cho từng lượt chạy.
Checklist kiểm tra use case AI đầu tiên
Trước khi quyết định bắt đầu một thử nghiệm nhỏ, hãy rà soát lại các điểm cốt lõi sau:
- ☐ Vấn đề cần giải quyết được mô tả bằng một điểm nghẽn hoặc sai sót cụ thể có thể đo đếm được.
- ☐ Xác định rõ ai là người trực tiếp đọc kết quả của AI và ai chịu ảnh hưởng nếu kết quả đó sai.
- ☐ Dữ liệu đầu vào, nhiệm vụ của mô hình và kết quả mong muốn được giới hạn trong phạm vi hẹp.
- ☐ Đã có số liệu tham chiếu (baseline) của cách làm hiện tại để so sánh hiệu quả.
- ☐ Đã cân nhắc các giải pháp đơn giản hơn như sửa biểu mẫu, dùng mẫu trả lời chuẩn hoặc bộ lọc quy tắc.
- ☐ Dữ liệu dùng để thử nghiệm đã được loại bỏ thông tin riêng tư và có quyền sử dụng rõ ràng.
- ☐ Bộ mẫu thử nghiệm có đủ trường hợp thông thường, tình huống phức tạp và câu hỏi mơ hồ.
- ☐ Tiêu chí đánh giá chất lượng được thống nhất trước khi chạy thử nghiệm trên mô hình.
- ☐ Kết quả của AI chỉ dừng ở mức gợi ý nội bộ, không tự động kích hoạt hành động bên ngoài.
- ☐ Người duyệt có đầy đủ nội dung gốc và ngữ cảnh để kiểm tra tính chính xác của đề xuất.
- ☐ Luôn có phương án dự phòng để quay về cách làm cũ ngay khi dịch vụ AI gặp sự cố.
- ☐ Quyết định mở rộng dựa trên số kết quả thực sự dùng được và thời gian rà soát thực tế.
Một bài toán AI chỉ sẵn sàng khi bạn có thể trả lời rõ ba câu hỏi: mô hình hỗ trợ bước nào, dựa vào đâu để biết kết quả đó đúng, và quy trình sẽ chạy tiếp ra sao nếu mô hình phản hồi sai. Khi ba câu hỏi này còn mơ hồ, việc thu hẹp phạm vi công việc sẽ mang lại lợi ích lớn hơn nhiều so với việc vội vã chọn mua một công cụ mới.
Bước tiếp theo là phân định ranh giới giữa bước xử lý ngôn ngữ của AI với các khâu điều hướng theo luật cố định. Bạn có thể tham khảo thêm quy trình xác định tự động hóa công việc để kiểm tra độ ổn định của hệ thống trước khi tích hợp các thành phần mới.
Nguồn tham khảo
- NIST AI Risk Management Framework Core
- NIST AI 600-1 — Generative Artificial Intelligence Profile
- AWS Responsible AI Lens — Use case
- AWS Generative AI Lens — Generative AI lifecycle
- Microsoft Azure Well-Architected Framework — AI workloads on Azure
- Microsoft Azure Well-Architected Framework — Design methodology for AI workloads
- OWASP Top 10 for LLM Applications 2025