Một ticket hỗ trợ khách hàng mới được đẩy vào đường ống xử lý tự động (workflow). Mô hình AI nhận dữ liệu, phân loại nhóm sự cố và soạn sẵn một câu trả lời hoàn chỉnh. Trong điều kiện lý tưởng, bước này hoàn tất trong vòng 3 đến 5 giây.
Hôm đó, cổng dịch vụ của nhà cung cấp AI gặp hiện tượng nghẽn mạng cục bộ. Sau 20 giây chờ đợi mà chưa thấy phản hồi, hệ thống workflow cho rằng kết nối đã chết nên kích hoạt cơ chế thử lại (retry) và gửi đi một request thứ hai. Lần gọi thứ hai may mắn đi qua một cụm máy chủ thông thoáng hơn và trả về kết quả sau 4 giây. Hệ thống lưu bản nháp vào cơ sở dữ liệu và chuyển ticket sang trạng thái chờ nhân viên phê duyệt.
Khoảng một phút sau, request đầu tiên tưởng chừng đã chết bất ngờ hoàn tất và trả về kết quả. Một tiến trình ngầm (worker) khác của hệ thống đón nhận dữ liệu đến muộn này và vô tư lặp lại toàn bộ các bước nghiệp vụ trước đó: ghi đè bản nháp mới, gửi thêm một thông báo lên kênh Slack nội bộ và kích hoạt một webhook thứ hai.
Sự cố này không bắt nguồn từ việc mô hình AI thông minh hay ngây ngô. Điểm yếu chí tử nằm ở kiến trúc bao quanh: workflow đã ngộ nhận rằng hết thời gian chờ (timeout) đồng nghĩa với việc request đầu tiên đã bị hủy bỏ, đồng thời hệ thống thiếu hoàn toàn cơ chế nhận diện hai kết quả trả về thuộc về cùng một tác vụ.
Khi bạn trò chuyện với AI trên giao diện web, một câu trả lời bị treo chỉ khiến bạn bấm tải lại trang. Nhưng khi AI trở thành một mắt xích trong chuỗi tự động hóa, mỗi kết quả trả về đều là dữ liệu đầu vào kích hoạt các bước ghi dữ liệu, trừ tiền hoặc gửi email ở phía sau. Vì vậy, các chốt chặn kỹ thuật bao quanh bước AI quan trọng không kém gì nội dung câu lệnh (prompt) bạn gửi vào mô hình.
Bản chất của timeout và rủi ro từ các phản hồi đến muộn
Timeout là mốc thời gian tối đa mà ứng dụng của bạn chấp nhận treo kết nối để chờ dữ liệu. Khi đồng hồ đếm ngược chạm mốc timeout, client sẽ chủ động ngắt socket và báo lỗi.
Tuy nhiên, việc client ngắt kết nối không đảm bảo rằng máy chủ của nhà cung cấp AI đã dừng việc sinh từ. Trong rất nhiều trường hợp, cụm GPU của nhà cung cấp vẫn tiếp tục chạy ngầm, tính toán xong toàn bộ văn bản và gửi phản hồi về một kết nối vừa bị đóng. Request đó vẫn được ghi nhận thành công trên hệ thống thanh toán của nhà cung cấp, và bạn vẫn bị trừ tiền cho toàn bộ số lượng token đã sinh ra.
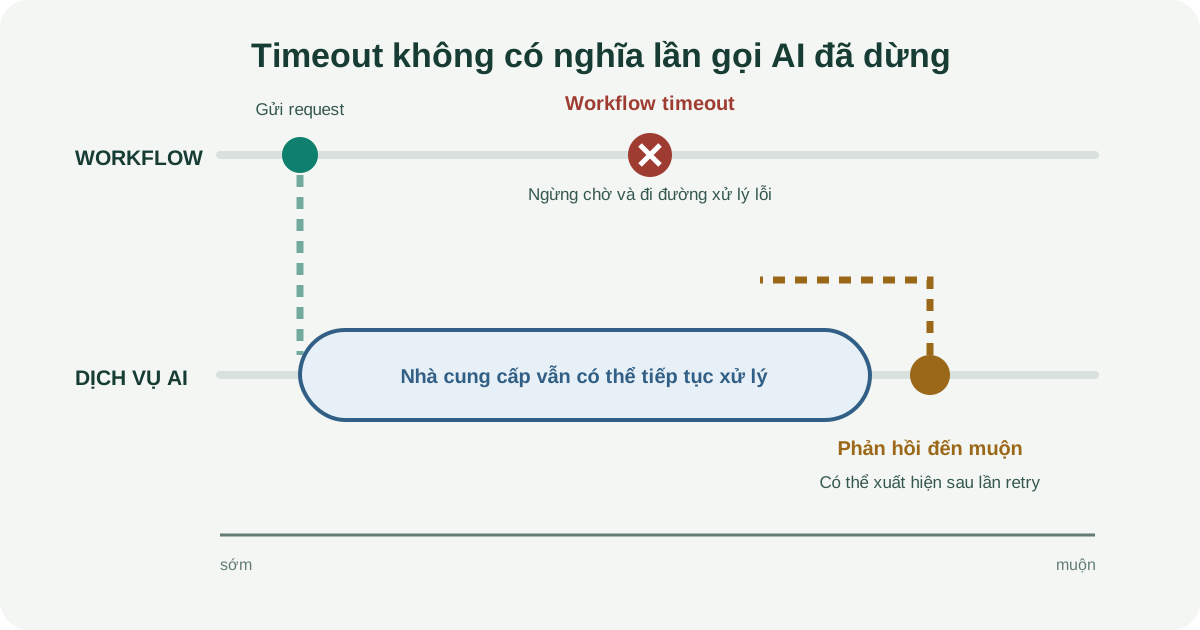
Giải pháp cho vấn đề này không phải là liên tục tăng thời gian timeout lên 2 phút hay 5 phút. Tăng timeout quá cao sẽ làm nghẽn hàng đợi (queue) và giữ chân các tiến trình worker, khiến toàn bộ hệ thống bị tê liệt khi nhà cung cấp gặp sự cố diện rộng.
Thời gian timeout của bước AI bắt buộc phải nằm trong tổng ngân sách thời gian (time budget) của toàn bộ workflow. Nếu cả quy trình xử lý ticket phải hoàn tất trong 30 giây để kịp hiển thị lên màn hình người dùng, bước gọi AI không được phép chiếm quá 15 giây. 15 giây còn lại phải được dự phòng cho các tác vụ truy vấn cơ sở dữ liệu, kiểm tra định dạng và kích hoạt kịch bản dự phòng khi bước AI thất bại.
Thiết lập chính sách thử lại dựa trên mã lỗi thực tế
Một phản xạ lập trình phổ biến là cứ thấy request gọi AI bị lỗi thì lập tức cho chạy lại (retry) 3 lần. Cách làm cào bằng này biến các lỗi logic đơn giản thành các đợt bắn phá API vô nghĩa, làm cạn kiệt hạn mức gọi và gây lãng phí ngân sách.
Để xây dựng một chính sách retry an toàn, bạn bắt buộc phải phân tách lỗi thành hai nhóm riêng biệt:
- Lỗi tạm thời có thể tự phục hồi (Transient Errors): Bao gồm mất kết nối mạng đột ngột, máy chủ AI quá tải tạm thời (mã HTTP
503 Service Unavailable) hoặc chạm hạn mức số lượng request trong một phút (mã HTTP429 Too Many Requests). Với nhóm lỗi này, việc chờ đợi một khoảng thời gian ngắn rồi thử lại là hoàn toàn hợp lý. - Lỗi logic không bao giờ tự hết (Permanent Errors): Bao gồm API key bị thu hồi (mã
401 Unauthorized), prompt vượt quá dung lượng context tối đa (mã400 Bad Request), hoặc tài khoản hết tiền. Khi gặp các mã lỗi này, việc gửi lại cùng một nội dung 10 lần cũng chỉ thu về 10 lần thất bại giống hệt nhau. Hệ thống phải ngắt luồng ngay lập tức và ghi log cảnh báo cho quản trị viên.
Tài liệu hướng dẫn về khả năng phục hồi của AWS Architecture Center và Google Cloud Workflows đều nhấn mạnh hai kỹ thuật then chốt khi thiết kế retry:
- Tăng dần thời gian chờ theo hàm mũ (Exponential Backoff): Lần thử lại thứ nhất chờ 1 giây, lần thứ hai chờ 2 giây, lần thứ ba chờ 4 giây. Điều này cho phép máy chủ của nhà cung cấp có khoảng lặng để giải phóng tài nguyên.
- Thêm độ lệch ngẫu nhiên (Full Jitter): Cộng hoặc trừ một khoảng mili-giây ngẫu nhiên vào thời gian chờ (ví dụ: thay vì chờ đúng 2.000ms thì hệ thống chọn ngẫu nhiên từ 1.500ms đến 2.500ms). Jitter ngăn chặn hiện tượng "bão thử lại" (retry storm) khi hàng nghìn worker cùng hết thời gian chờ và đồng loạt gửi lại request vào cùng một tích tắc, tự đánh sập đường truyền của chính mình.
Bẫy nhân bản request từ cơ chế thử lại đa tầng
Một hiểm họa ngầm thường xuất hiện trong các hệ thống lớn là hiện tượng thử lại chồng chéo giữa nhiều tầng kiến trúc:
Orchestrator (cài retry 3 lần)
  └── Queue Worker (cài retry 3 lần)
        └── HTTP Client SDK (cài retry 3 lần mặc định)
Nếu cấu hình không cẩn thận, một lỗi mạng đơn lẻ ở tầng dưới cùng sẽ bị SDK thử lại 3 lần. Nếu SDK thất bại và ném ngoại lệ ra ngoài, Queue Worker lại coi cả tiến trình là bị lỗi và chạy lại 3 lần (mỗi lần lại gọi SDK 3 lượt, thành 9 lần). Tiếp tục như vậy, tầng Orchestrator ngoài cùng lại khởi động lại tác vụ 3 lần.
Kết quả là một ticket duy nhất đã âm thầm kích hoạt $3 \times 3 \times 3 = 27$ lượt gọi API đắt đỏ lên mô hình AI.
Nguyên tắc vàng trong vận hành phân tán là: chỉ giao quyền quyết định thử lại cho duy nhất một tầng kiến trúc. Nếu bạn đã dùng Orchestrator (như Temporal, Airflow hoặc Google Cloud Workflows) để quản lý luồng, hãy tắt hoàn toàn tính năng tự động retry ngầm bên trong HTTP client SDK. Tầng client chỉ có nhiệm vụ duy nhất là ném đúng mã lỗi để tầng điều phối trung tâm ra quyết định.
Đảm bảo tính an toàn khi chạy lại bằng khóa chống trùng lặp
Quay lại sự cố ticket bị tạo hai bản nháp ở đầu bài: nguyên nhân là do hệ thống tạo ra hai mã tác vụ hoàn toàn độc lập cho hai lần gọi API. Khi phản hồi thứ nhất đến muộn, cơ sở dữ liệu không có căn cứ nào để biết rằng bản ghi này thuộc về cùng một công việc đã được xử lý xong.
Để giải quyết triệt để rủi ro này, mọi bước tương tác với AI trong workflow bắt buộc phải tuân thủ nguyên lý Idempotency (tính lũy thỏa: thực thi nhiều lần nhưng trạng thái kết quả chỉ được áp dụng một lần duy nhất).
Giải pháp kỹ thuật gồm ba bước:
- Sinh khóa định danh duy nhất (Idempotency Key): Khóa này được tính toán dựa trên dữ liệu đầu vào cố định của tác vụ, ví dụ:
idempotency_key = hash(ticket_id + step_name + data_version). Bất kể bạn retry bao nhiêu lần do lỗi mạng, khóa định danh này vẫn giữ nguyên không đổi. - Gửi kèm khóa định danh khi gọi API: Nhiều nhà cung cấp đám mây và cổng thanh toán (như Stripe hay AWS) cho phép bạn gửi kèm header
Idempotency-Key. Nếu máy chủ nhận được một request trùng khóa đã xử lý thành công trước đó, nó sẽ lập tức trả về kết quả cũ mà không thực thi lại tiến trình tính toán. - Sử dụng cơ chế khóa phân tán hoặc UPSERT ở tầng lưu trữ: Khi kết quả từ AI được trả về, cơ sở dữ liệu phải dùng lệnh ghi đè theo khóa chính (
UPSERT) thay vì chèn mới (INSERT). Nếu một worker khác đã lưu bản nháp củaticket-8472rồi, kết quả đến muộn chỉ được phép cập nhật lại đúng bản ghi đó hoặc bị hệ thống từ chối vì trạng thái ticket đã chuyển sang "Đang chờ duyệt".
Tài liệu thiết kế kiến trúc phân tán của AWS Durable Execution Best Practices khẳng định: việc chạy lại an toàn không thể chỉ dựa vào niềm tin rằng mạng luôn thông suốt. Sự toàn vẹn dữ liệu phải được bảo vệ bằng chính cấu trúc khóa định danh ở tầng lưu trữ.
Kiểm tra chặt chẽ cấu trúc và tính hợp lệ của đầu ra
Một lỗi tai hại khác khi tích hợp AI vào workflow là giả định rằng: chỉ cần mô hình trả về mã HTTP 200 OK và chuỗi JSON không bị lỗi cú pháp thì dữ liệu đó đã sẵn sàng để chuyển tiếp cho bước sau.
Trên thực tế, mô hình AI có thể trả về một chuỗi JSON chuẩn cú pháp 100% nhưng nội dung bên trong lại hoàn toàn vô nghĩa đối với hệ thống nghiệp vụ:
- Trường
statuschỉ được phép nhận giá trịURGENThoặcNORMAL, nhưng AI lại tự sáng tạo ra giá trịVERY_IMPORTANT. - Trường
assigned_departmentbị bỏ trống (null). - Trường số tiền bồi thường
refund_amountbị AI điền một con số âm.
Nếu bạn đẩy thẳng dữ liệu này vào API của hệ thống ERP hoặc CRM, toàn bộ các bước tiếp theo sẽ bị sập hàng loạt do lỗi vi phạm ràng buộc dữ liệu (data constraint violation).
Quy tắc bắt buộc là phải đặt một lớp kiểm tra cấu trúc (Schema Validation) ngay sau khi nhận phản hồi từ AI:
- Sử dụng các thư viện định nghĩa kiểu dữ liệu chặt chẽ (như Zod trong TypeScript hoặc Pydantic trong Python) để ép khuôn toàn bộ dữ liệu đầu ra.
- Xác thực cả kiểu dữ liệu (kiểu số, kiểu chuỗi) lẫn miền giá trị logic (nằm trong danh sách enum cho phép, số tiền không được âm).
- Nếu dữ liệu vi phạm schema, hệ thống phải lập tức đánh dấu bước AI đó là thất bại logic để kích hoạt luồng xử lý dự phòng, thay vì để dữ liệu rác lan truyền sang các dịch vụ khác.
Luôn chuẩn bị sẵn đường lui khi dịch vụ AI gặp sự cố
Không có nhà cung cấp dịch vụ AI nào dám cam kết thời gian hoạt động (uptime) 100%. Các đợt mất kết nối diện rộng, cạn kiệt hạn ngạch tài khoản (quota exhaustion) hoặc độ trễ tăng đột biến lên hàng phút là những thực tế vận hành mà mọi kỹ sư đều phải đối mặt.
Nếu workflow của bạn được thiết kế theo kiểu "tất tay": AI chết thì toàn bộ hoạt động kinh doanh dừng lại, đó là một thất bại về mặt kiến trúc. Hệ thống luôn cần một kịch bản suy giảm chức năng có trật tự (Graceful Degradation):
- Chuyển đổi sang mô hình dự phòng (Model Fallback): Nếu API chính (ví dụ: Claude 3.5 Sonnet) trả về lỗi
503hoặc timeout liên tiếp 2 lần, hệ thống tự động định tuyến prompt sang một nhà cung cấp thứ hai (ví dụ: GPT-4o-mini hoặc Gemini Flash) với cùng một bản schema đầu ra. - Kích hoạt bộ quy tắc tĩnh (Rule-based Fallback): Nếu toàn bộ các nhà cung cấp AI đều không phản hồi, quy trình tự động chuyển sang dùng các quy tắc phân loại dựa trên từ khóa (regex) hoặc mẫu email phản hồi tĩnh đã chuẩn bị trước. Khách hàng có thể nhận được một phản hồi ít cá nhân hóa hơn, nhưng quy trình hỗ trợ không bao giờ bị đứt gãy.
- Đẩy vào hàng chờ xử lý thủ công (Dead-Letter Queue - DLQ): Khi một tác vụ thất bại sau toàn bộ các nỗ lực tự động, hệ thống đóng gói toàn bộ ngữ cảnh, mã ticket và lịch sử lỗi rồi chuyển thẳng vào hàng chờ riêng cho kỹ sư can thiệp bằng tay. Điều này đảm bảo không có bất kỳ yêu cầu nào của khách hàng bị rơi rụng trong thinh lặng.
Liên kết nội bộ tới bài viết Workflow lỗi giữa chừng: cơ chế retry và khôi phục an toàn sẽ giúp bạn hiểu sâu hơn về cách quản lý các hàng đợi lỗi này.
Giải pháp cho sự cố ticket bị nhân đôi ở đầu bài viết
Quay lại sự cố ticket bị tạo hai bản nháp và kích hoạt hai lần webhook ở đầu bài viết. Sau khi phân tích toàn diện, đội ngũ kỹ thuật đã tái cấu trúc lại bước AI theo ba chuẩn mực an toàn:
- Gán khóa chống trùng lặp cố định: Cả hai lượt gọi API đều mang khóa
idempotency_key = "ticket-8472:draft:v1". - Xử lý bất đồng bộ kèm ghi đè an toàn: Khi request thứ hai hoàn tất trước, hệ thống lưu bản nháp và cập nhật trạng thái ticket thành
AWAITING_HUMAN_REVIEW. Một phút sau, khi request đầu tiên trả về muộn, cơ sở dữ liệu kiểm tra thấy trạng thái ticket đã thay đổi nên lập tức hủy bỏ dữ liệu thừa và ghi một dòng log cảnh báoLATE_RESPONSE_IGNORED. - Giới hạn retry duy nhất 1 lần: Bật cơ chế Exponential Backoff có thêm độ lệch ngẫu nhiên (Jitter) và tắt hoàn toàn tính năng tự động retry bên trong thư viện HTTP client.
Nhờ ba thay đổi này, dù mạng internet có chập chờn hay nhà cung cấp phản hồi chậm, ticket vẫn chỉ có đúng một bản nháp duy nhất và nhân viên hỗ trợ chỉ nhận được một thông báo chuẩn xác.
Checklist kiểm tra bước AI trước khi đưa vào workflow tự động
Trước khi kích hoạt luồng tự động hóa có gắn bước gọi AI trên môi trường production, hãy tự kiểm tra 5 tiêu chí kỹ thuật sau:
- ☐ Thời gian timeout của bước AI được tính toán hợp lý trong tổng ngân sách thời gian của cả workflow.
- ☐ Chính sách retry chỉ áp dụng cho các lỗi mạng tạm thời (
429,503), tuyệt đối không retry các lỗi logic (400,401). - ☐ Toàn bộ hệ thống chỉ có DUY NHẤT một tầng kiến trúc được phép ra quyết định thử lại để tránh bão nhân bản request.
- ☐ Dữ liệu đầu vào và các thao tác ghi dữ liệu đều được bảo vệ bằng khóa chống trùng lặp (Idempotency Key).
- ☐ Đã xây dựng sẵn lớp xác thực cấu trúc (Schema Validation) và kịch bản dự phòng (Fallback) khi dịch vụ AI ngừng hoạt động.
Tài liệu tham khảo
- AWS Architecture Center - Reliability Pillar: Implementing Retry with Exponential Backoff and Jitter.
- Google Cloud Workflows Documentation - Handling errors and configuring deterministic retries.
- Stripe Engineering Blog - Designing robust and idempotent APIs in distributed architectures.