Một báo cáo sự cố dài sáu trang vừa được đưa vào mô hình AI để tóm tắt. Kết quả trả về chỉ còn vài đoạn ngắn: câu chữ gãy gọn, có mốc thời gian rõ ràng và kèm theo cả hướng khắc phục. Nếu chỉ đọc lướt qua để nắm ý, bạn sẽ thấy bản tóm tắt này rất chuyên nghiệp và có thể chuyển ngay cho đội ngũ trực ca.
Tuy nhiên, khi đối chiếu kỹ từng chi tiết kỹ thuật, bản tóm tắt này lại chứa ba lỗ hổng nghiêm trọng:
- Nó ghi phiên bản phần mềm gặp sự cố là
4.8.2, trong khi tài liệu gốc ghi rõ là bản4.8.1. - Nó bỏ sót hoàn toàn mốc thời gian lỗi tái diễn sau lần khởi động lại đầu tiên.
- Ở phần đề xuất, mô hình đưa ra một câu lệnh khởi động lại tiến trình trên máy chủ production nhưng không hề tính đến việc hàng trăm phiên giao dịch của người dùng đang chạy dang dở.
Cả ba lỗi này đều được bọc trong một lớp văn phong rất tự tin và mạch lạc. Trong tài liệu hướng dẫn quản trị rủi ro AI, Viện Tiêu chuẩn và Công nghệ Quốc gia Hoa Kỳ (NIST) gọi hiện tượng này là confabulation – mô hình tự tạo ra các chi tiết sai lệch hoặc không có căn cứ nhưng vẫn trình bày với giọng điệu hoàn toàn thuyết phục. Trong vận hành kỹ thuật, rủi ro không nằm ở việc câu chữ có bóng bẩy hay không; rủi ro thực sự xuất hiện khi người đọc tin tưởng vào những chi tiết sai lệch đó và đem áp dụng vào một thao tác có hậu quả thực tế.
Muốn kiểm tra hiệu quả, câu hỏi đầu tiên bạn phải trả lời là: kết quả này sắp được dùng vào việc gì?
Phân loại mức độ kiểm tra theo hậu quả của công việc tiếp theo
Cùng một đoạn văn bản do AI tạo ra, nhưng mục đích sử dụng khác nhau sẽ đòi hỏi những tiêu chuẩn kiểm tra hoàn toàn khác nhau. Một gợi ý tiêu đề trong buổi thảo luận ý tưởng nếu chưa hay thì có thể bỏ qua ngay mà không gây thiệt hại gì cho hệ thống. Nhưng nếu đoạn văn đó được đưa vào thông báo gửi cho khách hàng, mọi thông số về thời gian gián đoạn và cam kết dịch vụ bắt buộc phải được xác minh chính xác.
Trước khi bắt tay đọc từng câu, hãy xác định kết quả AI đang nằm ở mức độ nào trong bốn cấp độ sau:
| Cấp độ sử dụng | Ví dụ thực tế | Yêu cầu kiểm tra tối thiểu |
|---|---|---|
| Tham khảo nội bộ | Gợi ý ý tưởng, soạn nháp dàn bài | Đọc lướt để loại bỏ các ý vô lý hoặc không phù hợp |
| Đưa vào tài liệu hoặc thông báo | Email gửi khách hàng, biên bản bàn giao | Đối chiếu trực tiếp các mốc thời gian, tên người và số liệu |
| Làm căn cứ ra quyết định | Báo cáo phân tích sự cố, đề xuất kỹ thuật | Kiểm tra tài liệu gốc, rà soát phần bị bỏ sót và có người ký duyệt |
| Kích hoạt hành động trên hệ thống | Câu lệnh dòng lệnh, truy vấn database, mã API | Kiểm tra cú pháp, giới hạn quyền và chạy thử trong môi trường cách ly |
Bảng phân loại này giúp bạn phân bổ nguồn lực kiểm tra hợp lý. Bạn không cần phải mở cuộc họp rà soát cho một ý tưởng tham khảo, nhưng cũng tuyệt đối không được phép để một câu lệnh thay đổi cấu hình tự động chạy thẳng lên máy chủ thật chỉ vì nó được sinh ra từ một bản tóm tắt đọc có vẻ êm tai.
Tách nhỏ kết quả thành từng dữ kiện độc lập
Thói quen đọc lướt từ đầu đến cuối đoạn văn rồi đưa ra nhận xét chung chung là nguyên nhân phổ biến nhất dẫn đến việc bỏ sót các sai sót tai hại. Một bản tóm tắt có thể đúng đến 90% diễn biến sự cố, nhưng chỉ cần ghi sai số phiên bản hoặc nhầm lẫn mốc giờ, người kỹ sư trực ca sau đó có thể tìm sai nhật ký thay đổi (changelog) và đưa ra phán đoán sai lầm về nguyên nhân gốc rễ.
Để kiểm tra chính xác, hãy bóc tách văn bản thành từng đơn vị dữ liệu độc lập:
- Đâu là những sự việc thực tế đã diễn ra?
- Đâu là các con số, mốc giờ, tên riêng hoặc phiên bản kỹ thuật cụ thể?
- Đâu là những kết luận có thể truy vết ngược lại tài liệu nguồn?
- Đâu là phần suy diễn hoặc khuyến nghị do mô hình tự ý thêm vào?
- Có câu lệnh hay thông số cấu hình nào có khả năng làm thay đổi trạng thái của hệ thống hay không?
Khi nhìn vào từng mảnh dữ kiện riêng lẻ, bạn sẽ nhận ra câu khẳng định: "Lỗi phát sinh sau khi nâng cấp lên phiên bản 4.8.2" thực chất chứa ba dữ kiện tách biệt: có lỗi phát sinh, thời điểm lỗi gắn liền với lần nâng cấp, và phiên bản cài đặt là 4.8.2. Việc hai ý đầu tiên đúng với thực tế không đồng nghĩa với việc bạn được phép bỏ qua việc kiểm chứng lại con số phiên bản cuối cùng.
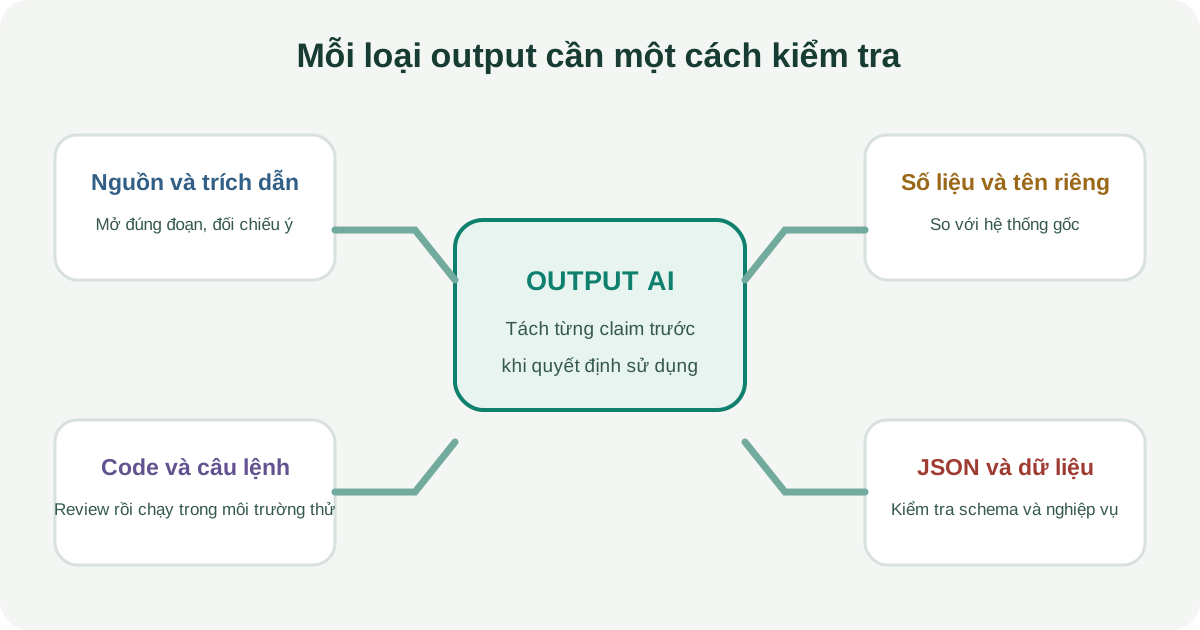
Đối chiếu trực tiếp với nội dung bên trong tài liệu gốc
Một đường liên kết do AI đưa ra có thể dẫn tới một trang tài liệu hoàn toàn có thật trên mạng, nhưng nội dung trên trang đó lại không hề hỗ trợ cho kết luận mà mô hình vừa viết ra. Thậm chí, mô hình có thể trích dẫn một bài viết kỹ thuật đã lỗi thời từ vài năm trước, hoặc áp dụng tài liệu của một hệ điều hành khác vào máy chủ của bạn.
Đối với bất kỳ khẳng định quan trọng nào có dẫn nguồn, bạn cần thực hiện đủ bốn bước đối chiếu:
- Mở trực tiếp đường link hoặc mở tài liệu nội bộ tương ứng để kiểm tra nguồn có thực sự tồn tại hay không.
- Đọc đúng đoạn văn được trích dẫn để xem tài liệu gốc có thực sự khẳng định điều đó hay không.
- Kiểm tra xem tài liệu đó áp dụng cho phiên bản phần mềm và môi trường nào; một tính năng chạy tốt trên bản 5.0 có thể hoàn toàn không hoạt động trên bản 4.8 đang dùng.
- Xem xét liệu mô hình AI có lược bỏ đi các điều kiện ngoại lệ quan trọng hay không. Ví dụ: tài liệu gốc ghi "tính năng này được hỗ trợ thử nghiệm từ bản 4.8", nhưng AI lại tóm tắt thành "bắt buộc phải kích hoạt tính năng này trên bản 4.8".
Khi không tìm thấy căn cứ xác thực trong tài liệu nguồn, cách xử lý an toàn nhất là xóa bỏ hoàn toàn nhận định đó, hoặc ghi chú rõ ràng rằng dữ kiện này chưa được kiểm chứng. Tuyệt đối không sửa câu chữ thành những từ ngữ mơ hồ như "có thể là", "dường như" để giữ lại một thông tin thiếu căn cứ trong báo cáo chính thức.
Bóc tách số liệu, phiên bản và mốc thời gian để kiểm tra độc lập
Những chi tiết mang tính định lượng rất dễ bị đọc lướt qua khi chúng nằm lọt thỏm giữa những câu văn trôi chảy. Để không bị sót, bạn hãy trích riêng các dữ kiện sau ra một danh sách đối chiếu:
- Số hiệu phiên bản phần mềm và mã bản vá (patch version).
- Mốc thời gian bắt đầu xảy ra sự cố, thời điểm phát hiện và thời điểm khôi phục.
- Số lượng người dùng hoặc số lượng giao dịch bị gián đoạn.
- Tên máy chủ, địa chỉ mạng nội bộ và môi trường chịu ảnh hưởng (staging hay production).
- Đơn vị đo lường và khoảng thời gian tính toán số liệu.
Tất cả các chi tiết này phải được so sánh trực tiếp với các bản ghi có thẩm quyền cao nhất: nhật ký máy chủ (system log), bảng điều khiển giám sát (monitoring dashboard) hoặc thông báo phát hành chính thức của nhà phát triển. Tuyệt đối không mở một cửa sổ chat AI khác rồi hỏi xem số liệu đó có đúng hay không; một mô hình ngôn ngữ không thể làm nguồn xác thực độc lập cho chính nó hoặc cho một mô hình khác.
Hãy chú ý đến cả đơn vị đo lường và ngữ cảnh đi kèm. Câu nói "giảm 20% lượng lỗi" khác hoàn toàn với "giảm 20 lỗi". Tương tự, tỷ lệ thành công đạt 99% trong một giờ thử nghiệm ban đêm không thể được dùng để đại diện cho độ ổn định của hệ thống vào giờ cao điểm ban ngày.
Kiểm tra các mốc sự kiện bị bỏ sót trong bản tóm tắt
Nhiều tài liệu kỹ thuật đề cập đến khái niệm Groundedness – tức là câu trả lời của AI hoàn toàn bám sát vào ngữ cảnh được cung cấp mà không tự ý bịa thêm chi tiết ngoài luồng. Đây là tiêu chuẩn bắt buộc, nhưng chưa đủ để bảo đảm tính an toàn trong vận hành. Một bản tóm tắt có thể trích dẫn chính xác 100% từ tài liệu gốc, nhưng việc nó "quên" không nhắc đến một sự kiện quan trọng vẫn có thể dẫn dắt người đọc tới một quyết định sai lầm.
Trong tình huống báo cáo sự cố, bản tóm tắt của AI ghi rất đúng rằng dịch vụ đã hoạt động bình thường trở lại vào lúc 09:18 sau khi khởi động lại tiến trình. Dữ kiện này hoàn toàn có trong tài liệu gốc. Nhưng nó lại bỏ sót một dòng ghi chú quan trọng phía sau: sự cố đã tái phát trở lại vào lúc 09:26 và đội ngũ kỹ thuật chỉ thực sự dứt điểm được lỗi sau khi thay mới chứng chỉ xác thực. Nếu chỉ đọc bản tóm tắt, kỹ sư trực ca sau sẽ lầm tưởng rằng chỉ cần khởi động lại máy chủ là giải quyết xong vấn đề.
Để tránh bẫy bỏ sót, trước khi đọc kết quả của AI, bạn hãy vạch sẵn một danh sách các mốc thông tin bắt buộc phải xuất hiện: thời điểm lỗi tái diễn, những phương án xử lý đã thất bại, và trạng thái thực tế của dữ liệu sau sự cố. Khi đối chiếu, bạn không chỉ kiểm tra xem những gì AI viết ra có đúng hay không, mà còn phải rà soát xem những gì AI không nhắc tới có làm thay đổi bản chất của vấn đề hay không.
Kiểm tra câu lệnh và mã nguồn trước khi chạy trên máy chủ
Một câu lệnh dòng lệnh (command) hoặc đoạn mã do AI viết ra có thể hoàn toàn đúng về mặt cú pháp nhưng vẫn gây tê liệt hệ thống nếu áp dụng sai bối cảnh. Mô hình không tự biết máy chủ của bạn đang chạy bao nhiêu dịch vụ, cơ sở dữ liệu có đang bị khóa bảng hay không và các phiên làm việc của người dùng có được lưu tạm thời hay chưa.
Trước khi thực thi bất kỳ đoạn mã hay câu lệnh nào từ AI, bạn cần rà soát qua sáu câu hỏi kỹ thuật:
- Câu lệnh này chỉ đọc dữ liệu kiểm tra hay có ghi đè, xóa bỏ hoặc thay đổi trạng thái hệ thống?
- Phạm vi ảnh hưởng tác động tới dịch vụ, thư mục hay cơ sở dữ liệu cụ thể nào?
- Có ký tự đại diện (wildcard
*), biến môi trường hoặc tham số mặc định nào có thể làm mở rộng phạm vi tác động ngoài ý muốn không? - Tài khoản thực thi lệnh đang chạy bằng quyền người dùng thông thường hay quyền quản trị cao nhất (root/sudo)?
- Câu lệnh có hỗ trợ chế độ chạy thử không tác động (
--dry-run), hoặc có thể chạy thử nghiệm trước trong container biệt lập không? - Nếu tiến trình bị lỗi giữa chừng, hệ thống có phương án hoàn tác (rollback) hoặc bản sao lưu dự phòng ngay trước đó hay chưa?
Đối với câu lệnh khởi động lại dịch vụ trong ví dụ sự cố, bạn không thể dán thẳng vào cửa sổ dòng lệnh của máy chủ production để "chạy thử xem sao". Thao tác chuẩn mực là phải kiểm tra xem dịch vụ có hỗ trợ cơ chế tắt êm dịu (graceful shutdown) để xử lý nốt các yêu cầu đang dang dở hay không, sau đó kiểm tra tiến trình giám sát trạng thái (health check) để xác nhận dịch vụ đã phục hồi an toàn sau khi bật lại.
Phân biệt kiểm tra cấu trúc JSON với kiểm tra logic nghiệp vụ
Khi mô hình AI trả về kết quả dưới dạng JSON, XML hoặc bảng dữ liệu, hệ thống phần mềm có thể đọc (parse) thành công các trường dữ liệu mà không báo lỗi cú pháp. Tuy nhiên, việc một gói dữ liệu khớp hoàn hảo với cấu trúc kỹ thuật (schema) chỉ chứng minh đoạn mã không bị lỗi lập trình; nó hoàn toàn không chứng minh các thông tin bên trong là có thật.
Một chuỗi dữ liệu máy đọc cần đi qua hai lớp kiểm định độc lập:
- Lớp kiểm tra cấu trúc: Xác thực kiểu dữ liệu (số, chuỗi, boolean), độ dài chuỗi ký tự, các trường bắt buộc và danh mục giá trị cho phép (enum).
- Lớp kiểm tra nghiệp vụ: Xác nhận mã khách hàng có tồn tại trong cơ sở dữ liệu không, số tiền giao dịch có vượt hạn mức quy định không, và hành động đó có phù hợp với trạng thái hiện tại của tài khoản hay không.
Lấy ví dụ về một gói tin JSON do AI sinh ra:
{
  "environment": "production",
  "action": "restart",
  "service": "billing-api",
  "approved": true
}
Dù đoạn mã có trường "approved": true, giá trị này chỉ là một chuỗi ký tự do mô hình tự điền vào. Hệ thống tiếp nhận tuyệt đối không được coi đây là sự phê duyệt thật sự. Quyền phê duyệt phải được truy vấn từ bảng phân quyền nội bộ của công ty, gắn với chữ ký số hoặc mã định danh của một người quản lý cụ thể tại thời điểm đó.
Theo tiêu chuẩn an toàn của OWASP (lỗ hổng Improper Output Handling), mọi kết quả do AI sinh ra đều phải được đối xử như dữ liệu chưa được kiểm chứng gửi từ bên ngoài Internet vào. Trước khi đưa vào câu lệnh SQL, chèn vào giao diện HTML hoặc gửi sang các API thanh toán, dữ liệu đó bắt buộc phải được làm sạch và mã hóa phù hợp để tránh nguy cơ bị chèn mã độc hoặc làm sai lệch luồng xử lý của hệ thống.
Quy trình kiểm tra sáu bước trước khi đưa kết quả vào sử dụng
Để việc kiểm tra diễn ra nhất quán và không phụ thuộc vào cảm tính, bạn có thể áp dụng quy trình sáu bước tuần tự sau:
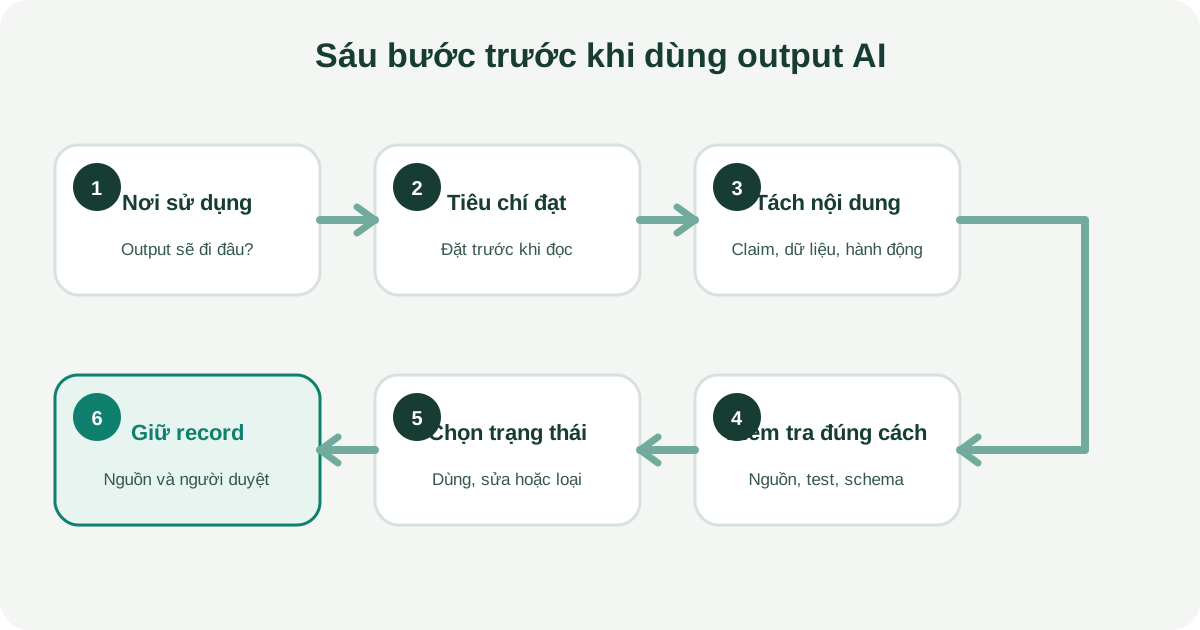
- Xác định đích đến của kết quả: Ghi rõ kết quả này sẽ chuyển cho ai đọc hoặc nạp vào phần mềm nào, thao tác tiếp theo có làm thay đổi dữ liệu hay không và khả năng hoàn tác khi có lỗi là dễ hay khó.
- Chốt tiêu chí nghiệm thu từ trước: Đặt ra các yêu cầu bắt buộc trước khi nhìn vào câu trả lời của mô hình, ví dụ: bắt buộc phải có đủ năm mốc thời gian sự cố và toàn bộ phiên bản phần mềm phải khớp với nhật ký kỹ thuật.
- Bóc tách các khẳng định kỹ thuật: Tách riêng các số liệu, ngày tháng, câu lệnh dòng lệnh và tên riêng ra khỏi phần câu chữ diễn đạt để kiểm tra độc lập.
- Áp dụng phép kiểm tra tương ứng: Đối chiếu từng số liệu với tài liệu gốc, chạy thử câu lệnh trong môi trường biệt lập (sandbox), và kiểm tra logic nghiệp vụ của các gói dữ liệu có cấu trúc.
- Gán trạng thái xử lý dứt khoát: Xếp kết quả vào một trong bốn trạng thái minh bạch:
DÙNG ĐƯỢC: Đạt toàn bộ tiêu chí cho đúng mục đích sử dụng đã xác định.CẦN SỬA: Phát hiện vài sai sót nhỏ có thể tự chỉnh sửa nhanh và đối chiếu lại.CHƯA ĐỦ CĂN CỨ: Thiếu tài liệu đối chiếu hoặc chưa có điều kiện chạy thử an toàn.LOẠI BỎ: Sai lệch bản chất vấn đề, tiềm ẩn rủi ro lớn hoặc công sức sửa chữa tốn kém hơn việc làm lại thủ công.
- Lưu vết kiểm tra vừa đủ: Đối với các quy trình quan trọng, hãy ghi lại mã định danh yêu cầu, người thực hiện kiểm tra, thời điểm duyệt và lý do chấp nhận để phục vụ việc tra cứu khi có sự cố.
Thời điểm cần dừng quy trình và chuyển sang xử lý thủ công
Trong nhiều tình huống, việc cố gắng chỉnh sửa một câu trả lời sai lệch hoặc bấm nút gửi lại câu lệnh (retry) liên tục chỉ làm lãng phí thêm thời gian. Bạn nên chủ động dừng quy trình và chuyển sang xử lý thủ công khi gặp các dấu hiệu sau:
- Không thể tìm thấy bất kỳ tài liệu nội bộ nào hỗ trợ cho khẳng định then chốt của mô hình.
- Tài liệu gốc và câu trả lời của AI mâu thuẫn trực tiếp với nhau nhưng nhóm chưa xác định được đâu là phiên bản thông tin mới nhất.
- Câu lệnh do AI đề xuất đòi hỏi quyền quản trị cao nhất (root/sudo) trên máy chủ nhưng hệ thống chưa có môi trường chạy thử và chưa có bản sao lưu dữ liệu dự phòng.
- Gói tin JSON trả về đúng cấu trúc nhưng chứa các giá trị không tồn tại trong cơ sở dữ liệu thực tế.
- Người chịu trách nhiệm kiểm tra không có đủ chuyên môn nghiệp vụ để đánh giá tính an toàn của đoạn mã do AI viết ra.
Trong các kịch bản tự động hóa, khi dữ liệu đầu ra của AI không vượt qua được các bài kiểm tra logic, hệ thống phải lập tức chuyển tiếp công việc sang nhánh dừng an toàn hoặc gửi cảnh báo cho kỹ sư trực ca. Tuyệt đối không thiết lập vòng lặp thử lại vô hạn với hy vọng mô hình sẽ tự động trả lời đúng ở lần chạy tiếp theo. Bạn có thể xem thêm cơ chế thiết lập thời gian chờ và nhánh dừng khẩn cấp trong bài viết xử lý workflow lỗi giữa chừng.
Checklist bảy câu hỏi trước khi phê duyệt kết quả
Trước khi sao chép một kết quả AI vào báo cáo chính thức hoặc cho phép kịch bản tự động chạy tiếp, hãy tự trả lời nhanh bảy câu hỏi:
- ☐ Kết quả này được dùng để đọc tham khảo, gửi cho khách hàng, làm căn cứ ra quyết định hay kích hoạt hành động trên máy chủ?
- ☐ Những khẳng định kỹ thuật quan trọng nhất đã được đối chiếu trực tiếp với tài liệu gốc chưa?
- ☐ Số hiệu phiên bản phần mềm, mốc thời gian và các con số định lượng đã được xác minh độc lập chưa?
- ☐ Bản tóm tắt có bỏ sót sự kiện sống còn nào làm thay đổi bản chất vấn đề không?
- ☐ Các đoạn mã hoặc câu lệnh hệ thống đã được chạy thử trong môi trường cách ly an toàn chưa?
- ☐ Dữ liệu dạng bảng hoặc JSON đã được kiểm tra tính hợp lệ về mặt nghiệp vụ trong cơ sở dữ liệu chưa?
- ☐ Nếu thông tin này sai lệch hoàn toàn, ai sẽ là người đứng ra chịu trách nhiệm và phương án khắc phục sự cố đã có sẵn chưa?
Mục tiêu của quy trình kiểm tra không phải là tìm cách chứng minh trí tuệ nhân tạo luôn đúng. Mục tiêu thực sự là dựng lên một chốt chặn kỹ thuật vững chắc để ngăn chặn những thông tin chưa được kiểm chứng trở thành văn bản chính thức hoặc gây gián đoạn cho hệ thống đang vận hành.