Khi website hoặc dịch vụ API trả về mã lỗi 500 hoặc lỗi 504 Gateway Timeout, log ứng dụng thường xuất hiện thông báo: Error 1040: Too many connections trên MySQL/MariaDB, hoặc FATAL: remaining connection slots are reserved for non-replication superuser connections trên PostgreSQL.
Đặc điểm đáng lưu ý của sự cố này là mức sử dụng CPU và RAM trên máy chủ database thường vẫn ở ngưỡng an toàn (dưới 30%), băng thông mạng không nghẽn và năng lực xử lý phần cứng còn dư dả. Tuy nhiên, hệ quản trị cơ sở dữ liệu từ chối tiếp nhận thêm bất kỳ truy vấn mới nào.
Nguyên nhân là tổng số kết nối đồng thời từ các tiến trình ứng dụng đã đạt ngưỡng trần max_connections trong cấu hình. Việc tăng thông số này lên cao mà không xác định đúng nguồn phát sinh kết nối có thể khiến database tiêu tốn quá nhiều bộ nhớ cho session, dẫn đến rủi ro sập dịch vụ do tràn bộ nhớ RAM (OOM Killer) hoặc khiến MySQL không thể khởi động lại.
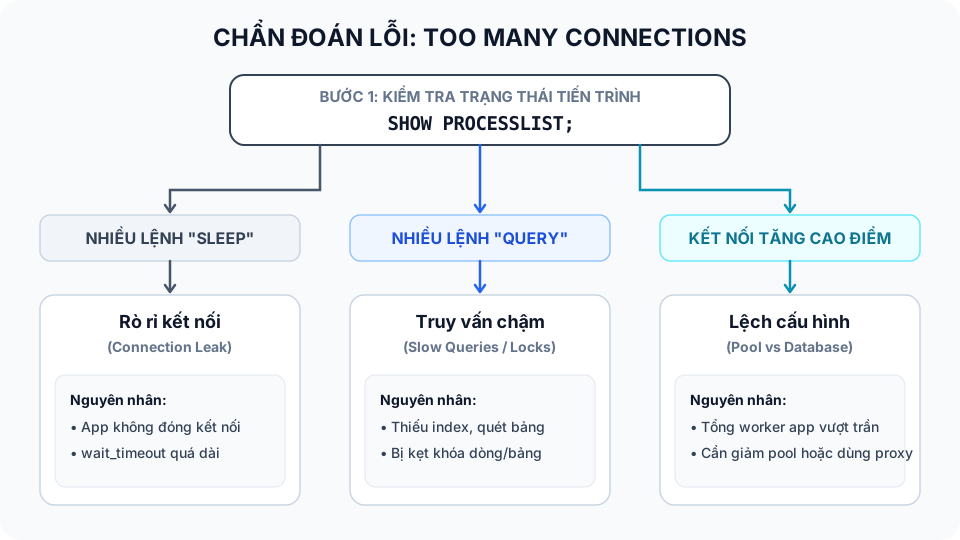
Phân loại 3 nguyên nhân cốt lõi gây cạn kiệt kết nối khi tài nguyên máy chủ vẫn ở mức an toàn.
Cơ chế hoạt động của kết nối cơ sở dữ liệu và Connection Pool
Để hiểu vì sao kết nối bị cạn kiệt, bạn cần nắm rõ vòng đời của một kết nối giữa máy chủ ứng dụng (Web Server / App Server) và máy chủ cơ sở dữ liệu (Database Server).
Mỗi khi ứng dụng cần đọc hoặc ghi dữ liệu, một kết nối TCP phải được thiết lập. Quy trình này bao gồm: bắt tay TCP 3 bước (TCP three-way handshake), xác thực danh tính người dùng (authentication/handshake), cấp phát vùng đệm bộ nhớ riêng cho session trên RAM của database, và thực thi câu lệnh SQL.
Chi phí khởi tạo kết nối mới là rất đắt đỏ về cả độ trễ mạng lẫn tài nguyên CPU. Vì vậy, các framework hiện đại (như Spring Boot, Laravel, Django, NestJS, Go, .NET) đều sử dụng cơ chế Connection Pool:
- Ứng dụng khởi tạo sẵn một lượng kết nối nhất định đến cơ sở dữ liệu ngay khi khởi động.
- Khi một request từ người dùng đến, ứng dụng "mượn" một kết nối đang rảnh rỗi từ pool để thực thi câu lệnh SQL.
- Sau khi có kết quả trả về, ứng dụng "trả" kết nối đó lại cho pool để phục vụ các request tiếp theo, thay vì ngắt kết nối vật lý.
Vấn đề nảy sinh khi tốc độ mượn kết nối vượt xa tốc độ hoàn trả, hoặc kết nối bị chiếm giữ quá lâu mà không được giải phóng. Khi toàn bộ slot kết nối trong pool đều ở trạng thái bận, request mới phải xếp hàng chờ. Nếu hàng đợi quá hạn (connection timeout), lỗi kết nối sẽ bùng phát trên toàn bộ website.
Bước 1: Kiểm tra nhanh trạng thái kết nối trên máy chủ Database
Để xác định nguyên nhân, bạn cần truy cập trực tiếp vào máy chủ cơ sở dữ liệu và thu thập số liệu về số lượng cũng như trạng thái của các kết nối hiện tại.
Đăng nhập khẩn cấp khi database từ chối kết nối mới
Trong tình huống khẩn cấp, lệnh mysql -u root -p qua mạng có thể bị từ chối với lỗi Too many connections.
Trên MySQL và MariaDB, hệ thống luôn dự phòng thêm 1 kết nối vượt mức max_connections cho tài khoản có quyền SUPER hoặc CONNECTION_ADMIN (mặc định là tài khoản root kết nối qua UNIX socket cục bộ tại localhost). Vì vậy, bạn nên kết nối trực tiếp qua socket trên terminal của máy chủ:
# Kết nối qua UNIX socket nội bộ (không đi qua giao thức mạng TCP)
sudo mysql -u root
Nếu kết nối dự phòng này cũng đã bị chiếm dụng từ trước, bạn cần kiểm tra danh sách kết nối mạng ở tầng hệ điều hành thông qua lệnh ss hoặc netstat:
# Đếm số lượng kết nối TCP đang mở tới cổng 3306 của MySQL
ss -tan state established '( dport = :3306 or sport = :3306 )' | wc -l
Lệnh kiểm tra trên MySQL và MariaDB
Sau khi vào được giao diện dòng lệnh của MySQL, chạy các lệnh sau để so sánh số kết nối hiện tại với giới hạn cấu hình:
-- 1. Xem giới hạn kết nối tối đa được phép
SHOW VARIABLES LIKE 'max_connections';

-- 2. Xem số lượng kết nối đang mở tại thời điểm hiện tại
SHOW STATUS LIKE 'Threads_connected';

-- 3. Xem số lượng kết nối cao nhất từng được ghi nhận
SHOW STATUS LIKE 'Max_used_connections';
Khi Threads_connected chạm tới giá trị của max_connections (theo tài liệu MySQL Reference Manual - Too many connections), database bắt đầu từ chối kết nối mới từ phía ứng dụng.
Để biết các kết nối này đang làm gì, truy vấn danh sách tiến trình bằng lệnh:
SELECT Command, count(*) AS total_connections
FROM information_schema.processlist
GROUP BY Command
ORDER BY total_connections DESC;
Kết quả sẽ phân chia các kết nối thành hai trạng thái chính:
Command = 'Query': Các kết nối đang thực thi câu lệnh SQL.Command = 'Sleep': Các kết nối nhàn rỗi, không chạy câu lệnh nào nhưng tiến trình ứng dụng vẫn giữ mở và chưa trả về connection pool.
Lệnh kiểm tra trên PostgreSQL
Với PostgreSQL, bạn đăng nhập vào tài khoản postgres và chạy câu truy vấn sau:
-- 1. Xem giới hạn kết nối tối đa
SHOW max_connections;

-- 2. Đếm số lượng kết nối theo từng trạng thái hoạt động
SELECT state, count(*) AS total_connections
FROM pg_stat_activity
GROUP BY state;
Các trạng thái cần lưu ý trên PostgreSQL:
active: Đang xử lý câu lệnh SQL.idle: Đang rảnh rỗi chờ lệnh tiếp theo từ ứng dụng.idle in transaction: Ứng dụng đã mở giao dịch (BEGIN) nhưng chưa thực hiệnCOMMIThoặcROLLBACK. Đây là trạng thái nguy hiểm vì nó vừa chiếm dụng connection slot, vừa có thể giữ khóa (lock) trên các bảng dữ liệu.
Bước 2: Phân biệt 3 nguyên nhân cốt lõi gây nghẽn kết nối
Dựa vào tỷ lệ giữa kết nối đang xử lý truy vấn (Query / active) và kết nối nhàn rỗi (Sleep / idle), bạn có thể xác định chính xác sự cố thuộc nhóm nào dưới đây:
1. Rò rỉ kết nối từ phía ứng dụng (Connection Leak)
Dấu hiệu nhận biết: Hầu hết các kết nối hiển thị trong processlist đều có Command = 'Sleep', thời gian Time (tính theo giây) tăng liên tục lên hàng trăm hoặc hàng nghìn giây, trong khi số câu lệnh đang chạy (Query) rất ít.
Nguyên nhân xuất phát từ mã nguồn ứng dụng:
- Framework hoặc thư viện database mượn kết nối từ pool nhưng gặp lỗi logic hoặc ngoại lệ (exception) trước khi kịp gọi hàm đóng (
close()hoặcrelease()). - Thiếu khối lệnh
try...finally(trong Java/Node.js/Python) hoặcdefer(trong Go) để đảm bảo kết nối luôn được hoàn trả về pool dù truy vấn thành công hay thất bại. - Tiến trình ứng dụng xử lý các tác vụ tốn thời gian (như gọi API bên ngoài, xử lý ảnh, tạo PDF) ngay trong khi đang giữ kết nối database, thay vì lấy dữ liệu xong thì trả kết nối ngay.
Kết quả là mỗi request bị lỗi sẽ "bỏ quên" một kết nối trên database cho đến khi toàn bộ pool bị chiếm giữ hoàn toàn bởi các kết nối không còn sử dụng.
2. Truy vấn chậm hoặc bảng bị khóa (Slow Queries & Lock Contention)
Dấu hiệu nhận biết: Số lượng kết nối có Command = 'Query' (trên MySQL) hoặc state = 'active' (trên PostgreSQL) tăng đột biến. Cột State trong processlist xuất hiện các trạng thái như Sending data, Sorting result, hoặc Waiting for table metadata lock.
Khi một truy vấn phức tạp thiếu index hoặc quét toàn bộ bảng (full table scan) chạy mất 10 đến 20 giây:
- Kết nối phục vụ truy vấn đó bị giữ chặt trong suốt thời gian xử lý.
- Các request mới từ người dùng tiếp tục đổ về, buộc ứng dụng phải lấy thêm kết nối mới từ pool.
- Nếu truy vấn đó còn thực hiện khóa bảng hoặc khóa dòng (như
UPDATEhoặcDELETEtrên bảng lớn), các câu lệnh đến sau sẽ bị xếp hàng chờ khóa (lock wait). Tình trạng này có thể chuyển biến thành khóa chết (Deadlock) làm treo worker, hoặc gây hiện tượng website tải chậm dù CPU và RAM máy chủ vẫn ở mức thấp.
Hiện tượng này tạo ra hiệu ứng domino: toàn bộ connection pool của ứng dụng bị lấp đầy chỉ trong vài giây, dù lưu lượng truy cập thực tế không hề tăng đột biến.
3. Mất cân đối giữa số lượng Worker ứng dụng và cấu hình Database
Dấu hiệu nhận biết: Kết nối phân bổ đều, thời gian xử lý truy vấn vẫn nhanh (vài mili-giây), nhưng tổng số kết nối luôn tiệm cận giới hạn max_connections vào các khung giờ cao điểm.
Nguyên nhân nằm ở sự không tương thích giữa cấu hình worker của máy chủ ứng dụng và giới hạn của máy chủ database.
Ví dụ: Hệ thống triển khai 4 máy chủ ứng dụng (App Node). Mỗi máy chủ chạy 20 tiến trình worker, và mỗi worker được cấu hình connection pool tối đa là 10 kết nối: $$\text{Tổng kết nối tối đa} = 4 \times 20 \times 10 = 800\text{ kết nối}$$
Trong khi đó, máy chủ MySQL vẫn giữ nguyên cấu hình mặc định: $$\text{max\_connections} = 151$$
Vào giờ bình thường, mỗi worker chỉ dùng 1 đến 2 kết nối nên hệ thống vẫn chạy ổn định. Khi có đợt truy cập tăng nhẹ, các worker đồng loạt mở thêm kết nối trong pool của mình, ngay lập tức vượt ngưỡng 151 của database và làm sập kết nối của toàn bộ cụm ứng dụng.
Bước 3: Các thao tác xử lý khẩn cấp trong sự cố
Khi website đang gián đoạn và người dùng nhận mã lỗi 500, ưu tiên hàng đầu là giải phóng các slot kết nối ngay lập tức để phục hồi dịch vụ trước khi đi vào sửa đổi mã nguồn.
1. Ngắt các kết nối nhàn rỗi (Sleep) đang bị treo
Nếu kiểm tra thấy phần lớn kết nối đang ở trạng thái Sleep với thời gian chờ lớn, bạn có thể ngắt kết nối này để trả slot trống cho các request mới.
Trên MySQL, bạn có thể tạo danh sách lệnh KILL cho các kết nối Sleep đã tồn tại trên 60 giây bằng câu lệnh sau:
-- Tạo danh sách các lệnh KILL cho kết nối Sleep trên 60 giây
SELECT CONCAT('KILL ', id, ';')
FROM information_schema.processlist
WHERE Command = 'Sleep' AND Time > 60;
Sao chép kết quả và thực thi trong MySQL console để giải phóng hàng loạt kết nối nhàn rỗi.
Trên Linux terminal, bạn cũng có thể thực thi nhanh bằng một dòng lệnh bash:
mysql -u root -e "SELECT CONCAT('KILL ', id, ';') FROM information_schema.processlist WHERE Command = 'Sleep' AND Time > 60" | grep KILL | mysql -u rootĐối với PostgreSQL, ngắt các kết nối ở trạng thái idle hoặc idle in transaction kéo dài:
-- Ngắt các kết nối nhàn rỗi chạy quá 5 phút
SELECT pg_terminate_backend(pid)
FROM pg_stat_activity
WHERE state IN ('idle', 'idle in transaction')
  AND state_change < current_timestamp - INTERVAL '5 minutes'
AND pid <> pg_backend_pid();2. Tăng tạm thời giới hạn max_connections có kiểm soát bộ nhớ
Nếu kết nối chạm trần do lưu lượng truy cập thực tế tăng cao (traffic spike) và tài nguyên máy chủ vẫn còn dư dả, bạn có thể nâng tạm thời thông số max_connections ngay trên bộ nhớ mà không cần khởi động lại dịch vụ database:
-- Trên MySQL: Tăng giới hạn lên 300 kết nối
SET GLOBAL max_connections = 300;-- Kiểm tra lại giá trị vừa áp dụng
SHOW VARIABLES LIKE 'max_connections';Lưu ý quan trọng về bộ nhớ RAM: Mỗi kết nối mở trên MySQL tiêu tốn một lượng RAM nhất định để phục vụ các bộ đệm riêng biệt cho từng thread (thread_stack, sort_buffer_size, read_buffer_size, join_buffer_size).
Công thức ước tính dung lượng RAM tối đa mà các kết nối có thể chiếm dụng: $$\text{RAM}_{\text{connections}} \approx \text{max\_connections} \times (\text{thread\_stack} + \text{sort\_buffer} + \text{read\_buffer} + \text{join\_buffer})$$
Nếu mỗi kết nối chiếm trung bình từ 2MB đến 5MB RAM, việc nâng max_connections từ 150 lên 1.000 có thể làm tăng mức tiêu thụ RAM thêm 2GB đến 5GB. Bạn phải kiểm tra dung lượng RAM khả dụng bằng lệnh free -h trên Linux trước khi quyết định tăng thông số này, tránh trường hợp database bị hệ điều hành tắt do hết RAM (Out of Memory).
Bước 4: Cấu hình phòng ngừa và vận hành bền vững
Sau khi đã giải tỏa được sự cố tức thời, bạn cần tinh chỉnh các thông số vận hành để ngăn chặn tình trạng cạn kiệt kết nối tái diễn.
1. Rút ngắn thời gian chờ của kết nối nhàn rỗi (wait_timeout)
Theo mặc định, MySQL thiết lập thông số wait_timeout và interactive_timeout lên tới 28.800 giây (tương đương 8 tiếng). Điều này có nghĩa là nếu ứng dụng mượn kết nối rồi "bỏ quên", kết nối đó sẽ tiếp tục giữ một slot trong RAM suốt 8 tiếng trước khi database tự động ngắt.
Bạn nên hạ các giá trị này xuống mức hợp lý trong file cấu hình /etc/mysql/my.cnf (hoặc /etc/my.cnf):
[mysqld]
# Tự động ngắt kết nối nhàn rỗi sau 60 giây
wait_timeout = 60
interactive_timeout = 60

# Giới hạn số kết nối tối đa phù hợp với dung lượng RAM
max_connections = 300

# Tăng kích thước cache chứa các thread đã ngắt để tái sử dụng nhanh
thread_cache_size = 32
Đối với PostgreSQL, bạn cấu hình tự động ngắt các giao dịch bị bỏ quên trong file postgresql.conf:
# Tự động ngắt transaction nhàn rỗi sau 30 giây
idle_in_transaction_session_timeout = 30000

# Tự động ngắt session nhàn rỗi không làm gì sau 60 giây
idle_session_timeout = 60000
2. Chuẩn hóa kích thước Pool ở tầng ứng dụng
Nhiều quản trị viên cho rằng đặt kích thước connection pool ở ứng dụng càng lớn thì hệ thống chịu tải càng tốt. Trên thực tế, kích thước pool quá lớn sẽ gây phản tác dụng: hàng trăm kết nối đồng thời tranh chấp tài nguyên CPU cache và disk I/O, khiến tốc độ xử lý tổng thể bị suy giảm nghiêm trọng.
Theo công thức khuyến nghị từ nhóm phát triển thư viện HikariCP (tham khảo chi tiết tại HikariCP Wiki - About Pool Sizing): $$\text{Kích thước Pool tối ưu} = (\text{Số Core CPU} \times 2) + \text{Số ổ đĩa đồng thời}$$
Ví dụ: Với một máy chủ database có 4 vCPU và 1 ổ SSD NVMe, kích thước pool cho mỗi tiến trình ứng dụng chỉ nên dao động từ 10 đến 20 kết nối: $$\text{Pool Size} = (4 \times 2) + 1 = 9 \text{ đến } 15\text{ kết nối}$$
Ngoài ra, luôn thiết lập connection_timeout (hoặc acquire_timeout) ở mức từ 2.000ms đến 5.000ms. Khi pool chạm ngưỡng, ứng dụng sẽ báo lỗi timeout ngay thay vì để request của người dùng treo vĩnh viễn trên trình duyệt.
3. Sử dụng Connection Pooler tập trung khi mở rộng hệ thống
Nếu hệ thống sử dụng các mô hình triển khai microservices, kiến trúc serverless, hoặc PHP-FPM với hàng trăm worker độc lập, việc để từng worker mở kết nối trực tiếp đến database sẽ nhanh chóng làm quá tải cổng mạng và bộ nhớ session.
Giải pháp chuẩn cho hạ tầng production là đặt một tầng Connection Pooler trung gian:
- PostgreSQL: Sử dụng PgBouncer ở chế độ Transaction Pooling (tham khảo tài liệu PostgreSQL Connection Settings). Hàng ngàn tiến trình ứng dụng có thể kết nối tới PgBouncer, nhưng PgBouncer chỉ duy trì một cụm nhỏ (ví dụ 30 đến 50 kết nối thật) tới PostgreSQL.
- MySQL: Sử dụng ProxySQL để vừa gom kết nối (connection multiplexing), vừa hỗ trợ định tuyến đọc/ghi (Read/Write Split) và lưu bộ nhớ đệm câu lệnh (Query Cache).
Tóm tắt quy trình kiểm tra và xử lý
Khi hệ thống gặp lỗi cạn kết nối database, bạn xử lý theo 4 bước an toàn:
- Đăng nhập qua socket: Dùng
sudo mysql -u roottrên terminal cục bộ để tận dụng kết nối dự phòng. - Phân loại trạng thái: So sánh số kết nối
SleepvàQuerybằngSHOW PROCESSLISTđể xác định sự cố do rò rỉ kết nối hay do câu truy vấn chậm. - Giải phóng slot khẩn cấp: Ngắt các kết nối
Sleepnhàn rỗi quá lâu hoặc tăng tạm thờimax_connectionscó kiểm soát RAM khả dụng. - Cấu hình bền vững: Hạ
wait_timeoutvề 60 giây, thu hẹp kích thước pool phía ứng dụng và cân nhắc bổ sung connection pooler chuyên dụng.
Để chủ động phát hiện sớm trước khi kết nối chạm trần giới hạn cấu hình, bạn nên đưa chỉ số kết nối vào hệ thống giám sát thời gian thực; tham khảo chi tiết tại bài Monitoring Database: các chỉ số quan trọng cần theo dõi.