Trên màn hình giám sát của trung tâm vận hành (NOC), toàn bộ các biểu đồ kỹ thuật đều hiển thị màu xanh hoàn hảo: tỷ lệ gọi API thành công đạt 99,2%, thời gian phản hồi trung bình duy trì ổn định ở mức 2,4 giây, hàng đợi tin nhắn không hề bị nghẽn và không có bất kỳ ngoại lệ nào phát sinh trên cụm worker.
Tuy nhiên, đội ngũ hỗ trợ khách hàng lại đang đối mặt với một thực tế hoàn toàn trái ngược. Trong ba tuần gần đây, nhân viên trực ca liên tục phải can thiệp sửa đổi các bản nháp do AI soạn trước khi bấm gửi. Mô hình bắt đầu trích dẫn các điều khoản dịch vụ đã hết hạn và bỏ sót một bước xác minh danh tính bắt buộc vừa được bổ sung vào quy trình. Tỷ lệ bản nháp được phê duyệt nguyên trạng đã lao dốc từ 78% xuống chỉ còn 52%.
Không có bất kỳ chuông báo động kỹ thuật nào kêu lên trên hệ thống Datadog hay Grafana. Đối với máy chủ, mỗi request gọi sang OpenAI hay Anthropic đều trả về mã HTTP 200 OK đi kèm chuỗi JSON hợp lệ 100%. Quy trình tự động hóa vẫn đang chạy mượt mà, nhưng giá trị nghiệp vụ thực tế mà nó mang lại đã bị hao mòn một nửa.
Với workflow AI, hệ thống chạy thông suốt không bảo đảm kết quả trả về dùng được. Nếu chỉ nhìn CPU, lỗi mạng và lượng token, bạn sẽ bỏ sót hoàn toàn phần suy giảm chất lượng logic bên trong nội dung.
Phân tách trạng thái kỹ thuật và trạng thái công việc
Trong các quy trình tự động hóa truyền thống, sự thành bại của một bước được xác định rất dứt khoát: một câu lệnh SQL chạy thành công nghĩa là bản ghi đã nằm trong cơ sở dữ liệu; một lệnh gọi API sang cổng thanh toán thành công nghĩa là tiền đã được trừ.
Ngược lại, trong một workflow có tích hợp AI, một lượt gọi API thành công chỉ chứng minh được duy nhất một điều: dịch vụ đám mây đã hoàn tất việc sinh văn bản và trả kết quả về socket. Nó hoàn toàn không nói lên việc câu trả lời đó có đúng sự thật hay không, có bịa đặt số liệu hay không, và có tuân thủ đúng chính sách hiện hành hay không.
Để tránh bị đánh lừa bởi các biểu đồ "xanh giả tạo", hệ thống giám sát của bạn bắt buộc phải lưu trữ và phân tích hai lớp trạng thái hoàn toàn độc lập:
- Trạng thái kỹ thuật (Technical Status): Request có bị timeout không? Có gặp lỗi phân tích JSON không? Có phải retry không?
- Trạng thái công việc (Business Outcome): Kết quả do AI sinh ra có được chấp nhận nguyên trạng không? Người duyệt có phải chỉnh sửa trước khi gửi không? Hay đề xuất bị hủy bỏ hoàn toàn và phải chuyển sang xử lý thủ công?
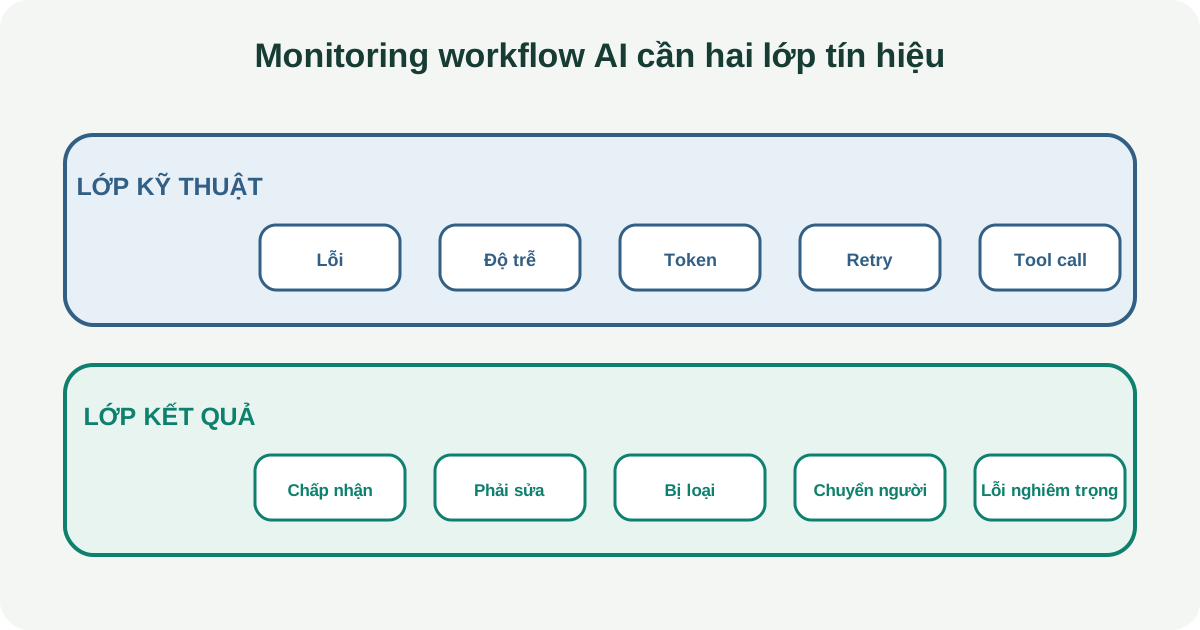
Chỉ khi bạn gắn kết được từng lượt gọi API với hành động tiếp theo của con người tại cổng phê duyệt, bạn mới có thể đo lường chính xác xem workflow tự động hóa có đang thực sự giải phóng sức lao động cho doanh nghiệp hay đang âm thầm tạo thêm việc phụ cho nhân viên.
Những chỉ số hạ tầng kỹ thuật bắt buộc phải thu thập
Mặc dù chất lượng nghiệp vụ là đích đến cuối cùng, các chỉ số vận hành hạ tầng vẫn là nền tảng cốt lõi không thể xem nhẹ. Nếu bước gọi API bị nghẽn mạng, dính rate limit hoặc gặp lỗi timeout liên tục, workflow sẽ không bao giờ có cơ hội tạo ra kết quả có ích.
Tài liệu giám sát hệ thống Generative AI của Amazon CloudWatch Observability Guide và Google Cloud Vertex AI khuyến nghị theo dõi chặt chẽ bốn nhóm chỉ số hạ tầng sau:
- Tần suất và tỷ lệ lỗi (Invocation & Error Rates): Đo lường số lượt gọi mỗi phút, phân tách chi tiết theo mã lỗi HTTP (
429 Rate Limit,503 Service Unavailable,400 Invalid Schema). - Độ trễ theo phân vị (Percentile Latency): Không nên chỉ nhìn vào độ trễ trung bình. Một độ trễ trung bình 3 giây có thể che giấu sự thật rằng có 5% số lượng request mất tới 45 giây để hoàn tất. Các mốc phân vị $p90$, $p95$ và $p99$ cho bạn biết chính xác 90% hay 99% người dùng đang phải chờ đợi trong bao lâu, giúp phát hiện sớm các tác vụ bị treo ngầm.
- Mức tiêu thụ tài nguyên (Token Consumption): Theo dõi số lượng token input, output và cached token cho từng lượt chạy để kiểm soát sự phình to của ngữ cảnh theo thời gian.
- Số lần gọi công cụ phụ trợ (Tool Call Frequency): Đo lường số lần agent gọi hàm truy vấn cơ sở dữ liệu hoặc tìm kiếm tài liệu để kịp thời phát hiện các vòng lặp bất thường.
Để việc điều tra sự cố diễn ra thuận lợi, mọi sự kiện từ lúc nhận yêu cầu, gọi AI, truy xuất dữ liệu RAG cho đến khi con người bấm duyệt bắt buộc phải được gắn chung một mã truy vết duy nhất (trace_id). Khi có khiếu nại về một câu trả lời sai, kỹ sư chỉ cần nhập trace_id là có thể mở lại toàn bộ dòng thời gian của tác vụ đó thay vì phải lục tìm trong nhiều file log rời rạc.
Lượng hóa chất lượng thành ba tiêu chí kiểm chứng cụ thể
Một điểm số chung chung như "Chất lượng bản nháp đạt 85/100" hầu như không có giá trị vận hành vì nó không chỉ ra được điểm yếu cụ thể của mô hình. Bản nháp đó viết sai sự thật, viết lạc đề, hay viết thiếu bước hướng dẫn quan trọng?
Thay vì dùng các thang điểm mơ hồ, tài liệu đánh giá của Microsoft và NIST khuyến nghị bóc tách chất lượng thành ba câu hỏi kỹ thuật cụ thể:
- Độ bám nguồn (Groundedness / Faithfulness): Toàn bộ các câu khẳng định trong bản nháp có trích xuất được từ tài liệu gốc được cung cấp hay không? Nếu AI tự đưa thêm các cam kết hoặc chính sách không có trong tài liệu, bản nháp bị coi là vi phạm độ bám nguồn.
- Tính liên quan (Relevance): Câu trả lời có giải quyết đúng trọng tâm vấn đề mà khách hàng đang hỏi hay không? Mô hình có bị lan man, sao chép nguyên cả bài hướng dẫn dài 5 trang thay vì chỉ trích ra 3 bước cần làm hay không?
- Độ hoàn chỉnh (Completeness): Bản nháp có giữ lại đầy đủ các cảnh báo an toàn và bước xác nhận bắt buộc hay không?
Một phản hồi từ chối trả lời (như: "Hệ thống chưa có dữ liệu về chính sách này, xin vui lòng liên hệ bộ phận hỗ trợ") cũng là một kết quả đạt chuẩn nếu câu hỏi thực sự nằm ngoài kho tài liệu. Bộ tiêu chí đánh giá phải coi đây là một hành vi đúng quy chuẩn an toàn, tránh việc trừ điểm mù quáng các câu trả lời thận trọng của mô hình.
Truy vết nguyên nhân khi chất lượng bắt đầu suy giảm
Khi tỷ lệ bản nháp được duyệt giảm từ 78% xuống còn 52%, con số này báo cho bạn biết hệ thống đang gặp vấn đề, nhưng nó không chỉ ra nguyên nhân nằm ở đâu. Trong cùng khoảng thời gian ba tuần đó, có thể đã có rất nhiều thay đổi diễn ra song song:
- Nhà cung cấp cập nhật phiên bản mô hình ngầm phía sau API.
- Kỹ sư tinh chỉnh lại system prompt để thêm vài quy định mới.
- Kho tài liệu RAG được cập nhật thêm các bài hướng dẫn mới.
- Cơ cấu câu hỏi của khách hàng thay đổi đột ngột do doanh nghiệp vừa ra mắt một tính năng mới.
Hiện tượng suy giảm chất lượng theo thời gian (thường gọi là Data Drift hoặc Concept Drift) chỉ có thể giải quyết được khi bạn có cơ chế đối soát phiên bản (Version Tracking) chặt chẽ.
Mỗi bản ghi log của một tác vụ AI bắt buộc phải gắn liền với bốn thông số phiên bản:
trace_id: "wf-run-91823"
model_version: "claude-3-5-sonnet-20241022"  // Tránh dùng alias chung chung
prompt_version: "support-draft-v3.4"         // Hash hoặc tag của prompt
knowledge_base_version: "kb-release-2026-10" // Phiên bản chỉ mục RAG
input_category: "billing_inquiry"            // Nhóm nghiệp vụ của ticket
Khi có dữ liệu này, việc tìm ra thủ phạm chỉ mất vài phút phân tích tương quan:
- Nếu tỷ lệ từ chối chỉ tăng vọt ở nhóm câu hỏi liên quan đến tính năng mới, nguyên nhân là kho tài liệu RAG chưa được cập nhật kiến thức về tính năng đó.
- Nếu tỷ lệ từ chối tăng đều trên mọi danh mục sau ngày 12/10, bạn chỉ cần đối chiếu lại xem vào ngày hôm đó đội ngũ kỹ thuật có vừa deploy phiên bản prompt mới hay không.
Khả năng cô lập vấn đề theo từng phiên bản giúp đội ngũ vận hành phản ứng chính xác: thay vì hoảng loạn viết lại toàn bộ prompt hoặc đổ lỗi cho mô hình AI, bạn chỉ cần hoàn tác (rollback) đúng phần tài liệu hoặc đoạn cấu hình vừa gây ra xung đột.
Thiết lập cảnh báo hướng đến hành động khắc phục cụ thể
Hầu hết các hệ thống giám sát đều thất bại vì tạo ra quá nhiều cảnh báo rác (alert fatigue). Nếu một kênh Telegram hoặc Slack nhận hàng trăm thông báo mỗi ngày về việc "Độ trễ tăng 10%" hay "Phát hiện một kết quả có điểm bám nguồn thấp", các kỹ sư trực ca sẽ nhanh chóng tắt chuông thông báo và bỏ qua luôn cả những cảnh báo sự cố nghiêm trọng.
Một cảnh báo có giá trị vận hành phải thỏa mãn hai điều kiện: nó phản ánh một sự cố thực tế ở tầng nghiệp vụ, và nó chỉ rõ bước khắc phục cần thực hiện ngay lập tức:
- Thay vì cảnh báo mơ hồ: "Cảnh báo: Tỷ lệ bản nháp bị sửa đang tăng cao trên môi trường production".
- Hãy cấu hình cảnh báo có tính hành động: "Cảnh báo ngưỡng: Tỷ lệ từ chối ở nhóm ticket 'Billing' vượt quá 35% trong 2 giờ liên tiếp sau khi deploy prompt v3.4. Hành động đề xuất: Rollback prompt về phiên bản v3.3 hoặc tạm dừng luồng AI của nhóm Billing".
Khi một cảnh báo gắn liền với một nút bấm khắc phục hoặc một quy trình khôi phục định sẵn, người trực ca có thể xử lý sự cố trong vòng vài phút mà không cần phải triệu tập một cuộc họp khẩn cấp để đoán định nguyên nhân.
Thiết kế bảng điều khiển tối giản trả lời ba câu hỏi thực chất
Không cần phải dựng một dashboard phức tạp với hàng chục biểu đồ chằng chịt khiến người xem bị ngợp thông tin. Một bảng điều khiển vận hành workflow AI hiệu quả chỉ cần tập trung trả lời dứt khoát ba câu hỏi cốt lõi sau:
┌────────────────────────────────────────────────────────────────────────┐
│                   DASHBOARD VẬN HÀNH WORKFLOW AI                       │
├────────────────────────────────┬───────────────────────────────────────┤
│ 1. HỆ THỐNG CÒN SỐNG KHÔNG?    │ 2. KẾT QUẢ CÒN DÙNG ĐƯỢC KHÔNG?       │
│ • Tỷ lệ gọi thành công: 99.4%  │ • Chấp nhận nguyên trạng: 76% (chuẩn) │
│ • Độ trễ p95: 3.2s             │ • Cần người sửa: 18%                  │
│ • Số lượt thử lại: 1.2%        │ • Bị từ chối / Hủy: 6%                │
├────────────────────────────────┴───────────────────────────────────────┤
│ 3. CHI PHÍ TRÊN MỖI KẾT QUẢ ĐƯỢC DUYỆT CÓ BỊ ĐỘI LÊN KHÔNG?            │
│ • Chi phí token trung bình / ticket chấp nhận: 0.038 USD                │
│ • Tổng chi phí nhân sự duyệt / ticket: 0.35 USD                        │
└────────────────────────────────────────────────────────────────────────┘- Hệ thống có đang hoạt động ổn định không? Xem tỷ lệ lỗi HTTP, độ trễ phân vị $p95$ và số lượt retry. Nếu các số liệu này xấu đi, vấn đề nằm ở hạ tầng mạng hoặc nhà cung cấp mô hình.
- Kết quả tạo ra có dùng được không? Xem tỷ lệ bản nháp được chấp nhận nguyên trạng so với tỷ lệ phải sửa và tỷ lệ bị từ chối. Nếu tỷ lệ chấp nhận giảm, vấn đề nằm ở chất lượng prompt hoặc dữ liệu RAG.
- Chi phí cho một kết quả hoàn tất có bị đội lên không? Xem chi phí trên mỗi tác vụ được chấp nhận (kết hợp cả tiền token lẫn thời gian con người phải bỏ ra để sửa lỗi). Nếu chi phí này tăng vọt, tự động hóa đang mất dần tính hiệu quả kinh tế.
Kết hợp đánh giá tự động với lấy mẫu kiểm tra thực tế
Để theo dõi chất lượng trên quy mô hàng nghìn ticket mỗi ngày, việc dùng một mô hình AI khác để chấm điểm tự động (kỹ thuật LLM-as-a-judge) là một công cụ hỗ trợ hữu ích. Mô hình chấm điểm có thể quét qua 100% các câu trả lời để phát hiện các dấu hiệu vi phạm chính sách hoặc lạc đề.
Tuy nhiên, bạn không nên coi điểm số do AI chấm là thước đo tuyệt đối. Mô hình chấm điểm cũng có những thiên kiến riêng, thường có xu hướng ưu tiên các câu trả lời dài dòng và hoa mỹ hơn là các câu trả lời ngắn gọn, chính xác.
Giải pháp cân bằng là duy trì quy trình lấy mẫu kiểm tra định kỳ (Sampling Review):
- Lấy mẫu ngẫu nhiên 5% tác vụ: Hàng tuần, trích xuất ngẫu nhiên khoảng 50 đến 100 tác vụ đã chạy thành công để kỹ sư có kinh nghiệm đọc và đánh giá lại độc lập.
- Tập trung vào nhóm tác vụ bị từ chối: Đọc kỹ 100% các trường hợp mà người duyệt bấm hủy hoặc khách hàng phản hồi tiêu cực. Đây chính là nơi bộc lộ rõ nhất những khoảng trống kiến thức của mô hình và các lỗi logic trong quy trình.
- Hiệu chỉnh lại bộ tiêu chí đánh giá: So sánh kết quả chấm điểm của chuyên gia con người với điểm số của mô hình tự động để liên tục tinh chỉnh các tiêu chí đánh giá cho sát với thực tế vận hành.
Checklist kiểm tra hệ thống giám sát workflow AI
Trước khi bàn giao một workflow AI cho đội ngũ vận hành quản lý, hãy tự kiểm tra 5 tiêu chí sau:
- ☐ Trạng thái kỹ thuật (mã HTTP, lỗi mạng) được lưu trữ tách biệt hoàn toàn với trạng thái công việc (chấp nhận, sửa, từ chối).
- ☐ Độ trễ được theo dõi theo các mốc phân vị ($p90$, $p95$, $p99$) thay vì chỉ nhìn vào số trung bình.
- ☐ Mọi lượt chạy đều được gắn mã truy vết (
trace_id) kèm định danh phiên bản của prompt, mô hình và tài liệu RAG. - ☐ Các ngưỡng cảnh báo được cấu hình gắn liền với hành động khắc phục cụ thể (rollback phiên bản hoặc tạm ngắt luồng).
- ☐ Duy trì quy trình lấy mẫu ngẫu nhiên định kỳ để người có chuyên môn trực tiếp thẩm định lại chất lượng thực tế.
Tài liệu tham khảo
- Amazon CloudWatch Documentation - Generative AI Observability: Metrics, Alarms, and Operational Best Practices.
- Google Cloud Vertex AI Documentation - Model Monitoring and Evaluation for Generative AI Applications.
- Microsoft Azure Architecture Center - Monitoring and Continuous Evaluation for LLM and RAG Pipelines.