Sáng thứ Hai, giao diện quản trị n8n vẫn mở bình thường. Kiểm tra trạng thái máy chủ (health check) hiển thị màu xanh và VPS không có bất kỳ cảnh báo quá tải tài nguyên nào. Tuy nhiên, bảng tổng hợp doanh số cần gửi cho ban giám đốc lúc 8 giờ sáng lại hoàn toàn không xuất hiện.
Tình huống này cho thấy việc giám sát (monitoring) một hệ thống tự động hóa không thể chỉ dừng lại ở câu hỏi đơn giản: "Tiến trình n8n có đang sống không?". Bạn còn phải biết chắc chắn: workflow có được kích hoạt đúng giờ, có đi hết toàn bộ các bước nghiệp vụ và có tạo ra kết quả thực tế tại hệ thống đích hay không.
Bài viết này phân tách các tín hiệu giám sát thành ba lớp độc lập: Nền tảng hạ tầng, Quá trình thực thi và Kết quả nghiệp vụ. Bạn không nhất thiết phải dựng ngay một hệ thống giám sát đồ sộ, nhưng mỗi workflow quan trọng đều phải có bằng chứng rõ ràng chứng minh công việc đã thực sự hoàn thành.
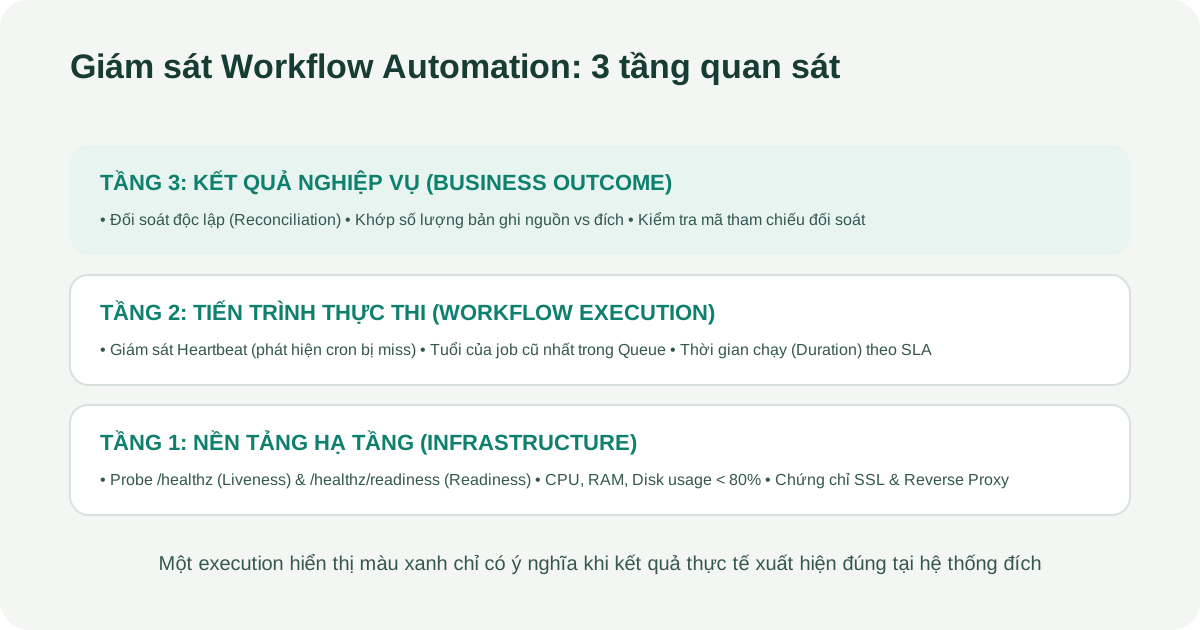
Hệ thống quan sát Workflow Automation 3 tầng: Nền tảng hạ tầng, Tiến trình thực thi và Đối soát kết quả nghiệp vụ.
1. Bắt đầu từ định nghĩa "công việc đã hoàn tất"
Trước khi lựa chọn bất kỳ chỉ số (metric) nào để theo dõi, hãy viết một câu mô tả chính xác kết quả cuối cùng của workflow. Ví dụ: "Mọi đơn hàng hợp lệ nhận trước 17 giờ phải có bản ghi tương ứng trên hệ thống ERP và lưu lại được mã tham chiếu đối soát". Định nghĩa này rõ ràng hơn nhiều so với việc chỉ nói "workflow chạy thành công", vì nó nêu rõ đối tượng, thời hạn hoàn thành và bằng chứng xác nhận.
Từ định nghĩa đó, bạn xác định 4 mốc thời gian và khối lượng cần quan sát:
- Có bao nhiêu sự kiện đầu vào bắt buộc phải được xử lý?
- Workflow phải bắt đầu thực thi trước thời điểm nào?
- Khi nào một lượt chạy bị xem là quá chậm hoặc bị treo?
- Dấu vết hoặc mã phản hồi nào tại hệ thống đích xác nhận công việc đã xong?
Với workflow chạy theo lịch định kỳ (cron), bạn biết trước chính xác thời điểm phải có lượt thực thi mới. Với webhook, tần suất chạy phụ thuộc vào lưu lượng gửi đến từ bên ngoài; khi đó bạn cần đối chiếu cả số lượng webhook tiếp nhận và số lượng sự kiện thực tế phát sinh tại hệ thống nguồn. Một khoảng thời gian không có lượt chạy nào có thể là điều bình thường, nhưng cũng có thể là dấu hiệu trigger đã âm thầm ngừng hoạt động. Chỉ có bối cảnh nghiệp vụ mới giúp bạn phân biệt được hai trường hợp này.
2. Lớp nền tảng: Kiểm tra khả năng sẵn sàng của n8n
n8n cung cấp hai endpoint kiểm tra trạng thái với ý nghĩa hoàn toàn khác nhau:
/healthz: Trả về mã HTTP200khi tiến trình ứng dụng vẫn đang chạy và phản hồi yêu cầu mạng. Endpoint này không đảm bảo kết nối cơ sở dữ liệu còn hoạt động./healthz/readiness: Chỉ trả về HTTP200khi n8n đã kết nối thành công với cơ sở dữ liệu, hoàn tất các bước migration và thực sự sẵn sàng tiếp nhận yêu cầu.
Vì vậy, endpoint /healthz chỉ dùng để phát hiện container bị treo (liveness probe). Khi muốn điều phối lưu lượng mạng từ reverse proxy vào máy chủ, bạn cần kiểm tra qua /healthz/readiness. Cả hai endpoint này đều chỉ xác nhận tình trạng của máy chủ, chưa chứng minh được một workflow cụ thể có xử lý đúng nghiệp vụ hay không.
Trên máy chủ VPS, bạn cần theo dõi bổ sung các chỉ số hạ tầng cốt lõi:
- Số lần container bị khởi động lại (restart count) và thời điểm khởi động lại gần nhất.
- Mức độ sử dụng CPU, dung lượng RAM, tỷ lệ đầy ổ đĩa (disk usage), tốc độ đọc ghi (I/O) và số lượng chỉ mục inode nếu workflow thường xuyên tạo nhiều tệp nhỏ.
- Trạng thái kết nối, dung lượng lưu trữ và thời gian truy vấn của cơ sở dữ liệu.
- Thời hạn của chứng chỉ SSL/TLS và trạng thái hoạt động của reverse proxy.
Bạn có thể xem thêm chi tiết cách đo lường các ngưỡng cảnh báo máy chủ tại bài viết monitoring VPS cần theo dõi gì.
Bảo vệ endpoint thu thập metric của Prometheus
Với n8n self-hosted, endpoint /metrics mặc định bị tắt và có thể được kích hoạt để các hệ thống như Prometheus thu thập dữ liệu hiệu năng. Tài liệu của n8n lưu ý không được mở công khai endpoint này ra Internet vì nó có thể làm lộ tên workflow, loại node và các thống kê vận hành nội bộ.
Chỉ cho phép hệ thống thu thập nội bộ truy cập endpoint này qua mạng riêng. Bảng điều khiển (dashboard) hiển thị biểu đồ cũng cần được bảo vệ bằng tài khoản đăng nhập có phân quyền rõ ràng.
3. Lớp execution: Workflow có chạy đúng lúc và hoàn tất đúng hạn?
Đây là lớp phản ánh trực tiếp hoạt động của từng workflow. Với mỗi quy trình tự động hóa quan trọng, bạn cần thu thập tối thiểu các tín hiệu sau:
- Thời điểm bắt đầu và kết thúc của lượt thực thi (execution) gần nhất.
- Trạng thái thực thi: thành công (success), thất bại (error), bị hủy (canceled) hoặc đang chờ (waiting).
- Thời gian chạy thực tế (duration) và xu hướng biến động theo thời gian.
- Số lần thử lại (retry count) và mã execution gốc.
- Node cuối cùng đã thực thi và thông tin lỗi chi tiết nếu có.
Cạm bẫy lớn nhất ở lớp này là chỉ đặt cảnh báo khi có execution thất bại. Nếu một workflow chạy theo lịch định kỳ bị bỏ lỡ lượt chạy (do scheduler gặp lỗi, workflow bị vô tình tắt kích hoạt, hoặc VPS khởi động lại đúng thời điểm hẹn giờ), hệ thống sẽ hoàn toàn không sinh ra lượt thực thi nào — đồng nghĩa với việc không có lỗi nào được ghi lại để kích hoạt cảnh báo.
Để bắt được các sự cố im lặng này, bạn nên áp dụng cơ chế giám sát nhịp tim (heartbeat monitoring / dead man's snitch): sau mỗi lần workflow hoàn tất thành công, hãy gửi một tín hiệu heartbeat (gồm mã workflow ID và mốc thời gian) về một dịch vụ giám sát độc lập. Nếu sau khoảng thời gian quy định mà dịch vụ giám sát không nhận được nhịp tim mới, một cảnh báo trễ hạn sẽ được phát ra ngay lập tức.
Đối với workflow tiếp nhận webhook, hãy định kỳ đối chiếu số lượng sự kiện được ghi nhận tại hệ thống nguồn với số lượng webhook n8n đã tiếp nhận. Nếu có độ lệch, bạn sẽ biết ngay điểm tắc nghẽn nằm ở đường truyền mạng hoặc tầng tiếp nhận, thay vì mất công dò tìm trong từng node logic của workflow.
Theo dõi thời gian thực thi theo từng workflow cụ thể
Chỉ số thời gian chạy trung bình tính gộp trên toàn bộ máy chủ rất dễ che giấu sự bất thường của các workflow quan trọng. Bạn nên theo dõi thời lượng thực thi riêng biệt cho từng workflow.
Nếu một báo cáo tài chính bắt buộc phải gửi trước 8 giờ sáng, thì một lượt chạy kéo dài tới 8 giờ 10 phút đã là một sự cố nghiêm trọng, ngay cả khi node cuối cùng vẫn báo thành công. Việc thiết lập ngưỡng cảnh báo theo hạn chót nghiệp vụ sẽ giúp người vận hành can thiệp trước khi ảnh hưởng đến công việc kinh doanh.
4. Error workflow giúp thông báo lỗi nhưng không bao phủ mọi tình huống
n8n cho phép cấu hình một workflow xử lý lỗi riêng biệt (error workflow) để tự động kích hoạt mỗi khi có một execution thất bại. Dữ liệu chuyển sang error workflow chứa tên workflow, mã execution, thông điệp lỗi và node bị dừng. Đây là cơ chế thuận tiện để gửi cảnh báo trực tiếp về kênh liên lạc của đội ngũ vận hành.
Tuy nhiên, error workflow không thể bắt được mọi sự cố: các lỗi xảy ra ngay tại bước kích hoạt trigger (như webhook bị từ chối do sai chữ ký hoặc dữ liệu gửi đến bị lỗi cú pháp JSON) có thể bị từ chối trước khi kịp ghi nhận execution ID. Như đã phân tích, error workflow cũng hoàn toàn bất lực trước các sự cố workflow bị bỏ lỡ lịch chạy.
Khi cấu hình gửi cảnh báo từ error workflow, hãy chọn lọc thông tin cẩn thận: chỉ gửi tên workflow, môi trường, thời điểm, mã execution, node gặp sự cố và đường dẫn tới giao diện quản trị an toàn. Tránh gửi toàn bộ dữ liệu đầu vào (payload) hoặc chuỗi truy vết lỗi (stack trace) thô vào kênh chat chung, vì các thông tin này có thể chứa token bảo mật hoặc dữ liệu khách hàng nhạy cảm.
Ngoài ra, không nên cấu hình error workflow tự động bấm chạy lại (retry) một cách mù quáng. Nếu node thanh toán đã trừ tiền thành công nhưng kết nối mạng bị ngắt ngay trước khi n8n nhận được phản hồi, việc tự động chạy lại có thể dẫn tới trừ tiền hai lần. Hãy chỉ retry tự động khi hệ thống đích có hỗ trợ khóa kiểm tra trùng lặp (idempotency key). Bạn có thể tham khảo thêm quy trình retry và phục hồi workflow an toàn.
5. Giám sát chế độ Queue Mode: Tách biệt hàng đợi và worker
Khi triển khai n8n ở chế độ hàng đợi mở rộng (queue mode), việc máy chủ điều phối chính (main instance) vẫn phản hồi không đồng nghĩa với việc các worker đang xử lý công việc bình thường. Hệ thống có thể công bố các chỉ số hàng đợi gồm: số lượng job đang hoạt động (active), đã hoàn tất (completed), bị lỗi (failed) và đang chờ xử lý (waiting).
Nếu số lượng job đang chờ (waiting) liên tục tăng cao trong khi số lượng job hoàn tất (completed) gần như dậm chân tại chỗ, đó là dấu hiệu công việc đang bị ùn ứ nghiêm trọng. Bước đầu tiên cần kiểm tra là các worker container có còn kết nối với Redis hay không, và tài nguyên cơ sở dữ liệu có bị cạn kiệt hay không.
Thay vì chỉ nhìn vào một con số waiting tức thời (bởi một đợt webhook dồn dập có thể tạo ra hàng đợi ngắn rồi tự giải tỏa), chỉ số quan trọng hơn bạn cần theo dõi là tuổi của job cũ nhất đang chờ trong hàng đợi. Nếu một sự kiện đã nằm chờ trong hàng đợi quá thời gian cho phép của quy trình nghiệp vụ, bạn cần cảnh báo ngay.
Nếu hiện tại bạn chưa cần dùng queue mode, đừng vội vã bổ sung thêm Redis và worker chỉ để có thêm biểu đồ theo dõi. Một kiến trúc máy chủ đơn lẻ, được giám sát đúng cách và hiểu rõ ngưỡng chịu tải, luôn dễ chẩn đoán và khắc phục sự cố hơn nhiều so với một hệ thống phân tán được dựng lên khi chưa thực sự cần thiết.
6. Lớp kết quả nghiệp vụ: Đầu ra có thực sự đúng và đủ?
Một lượt thực thi hiển thị trạng thái thành công màu xanh trong n8n chỉ chứng minh tiến trình đã đi qua các node mà không gặp lỗi làm gián đoạn luồng chạy. Điều đó chưa đảm bảo kết quả nghiệp vụ đã được tạo ra chính xác:
- Một node rẽ nhánh điều kiện (IF hoặc Switch) có thể đã vô tình đẩy dữ liệu vào nhánh rỗng vì một trường thông tin bị đổi tên.
- API của đối tác có thể trả về mã HTTP
200nhưng nội dung phản hồi bên trong lại báo lỗi logic. - Một tác vụ xử lý hàng loạt gồm 100 bản ghi có thể chỉ ghi thành công 95 bản ghi, trong khi 5 bản ghi bị bỏ qua mà không làm dừng workflow.
Với mỗi quy trình tự động hóa cốt lõi, bạn cần thiết lập cơ chế kiểm tra kết quả thực tế:
- So sánh số lượng sự kiện nhận vào với số lượng bản ghi thực tế được tạo ở hệ thống đích.
- Kiểm tra sự tồn tại của mã định danh tham chiếu (reference ID) giữa hai hệ thống.
- Theo dõi số lượng bản ghi bị loại bỏ (skipped items) hoặc bị đẩy vào hàng đợi dữ liệu lỗi.
- Lưu vết điểm kiểm tra (checkpoint) gần nhất như mốc thời gian hoặc số thứ tự bản ghi đã đồng bộ.
Đặc biệt, tiến trình đối soát (reconciliation) nên được chạy độc lập với workflow chính. Nếu để chính workflow tự kiểm tra kết quả của nó, một lỗi logic tiềm ẩn có thể khiến cả bước xử lý lẫn bước kiểm tra cùng bỏ qua sai sót, tạo ra cảm giác an toàn giả tạo. Một tác vụ đối soát riêng biệt chạy định kỳ (ví dụ mỗi giờ hoặc cuối ngày) sẽ so sánh dữ liệu giữa hệ thống nguồn, bảng trạng thái trung gian và hệ thống đích để phát hiện kịp thời các chênh lệch.
Bạn có thể tham khảo thêm nguyên lý xử lý đồng bộ và đối soát tại bài viết về so sánh Polling và Webhook trong kiến trúc tự động hóa.
7. Nối chuỗi vết nhật ký bằng mã định danh tương quan
Khi có cảnh báo sự cố, người trực ca cần lần vết được một sự kiện từ điểm phát sinh đầu tiên cho tới kết quả cuối cùng. Hãy lưu giữ các mã định danh sau ở các điểm giao tiếp quan trọng:
- Mã định danh
workflowIdvàexecutionIddo n8n tạo ra. - Mã định danh sự kiện hoặc mã yêu cầu từ hệ thống nguồn (ví dụ:
order_idhoặcevent_id). - Mã bản ghi hoặc mã phản hồi được tạo tại hệ thống đích.
- Mã tương quan tự sinh (correlation ID) được truyền xuyên suốt qua các header HTTP nếu hai hệ thống không có trường định danh chung.
n8n cho phép cấu hình cấp độ ghi nhật ký (log level), nơi xuất log và xoay vòng tệp log. Mức debug rất hữu ích khi cần điều tra lỗi trong khoảng thời gian ngắn, nhưng nó sinh ra lượng dữ liệu khổng lồ và làm tăng nguy cơ đầy ổ đĩa. Tránh duy trì mức debug liên tục trên môi trường production.
Nhật ký hệ thống không được ghi lại thông tin xác thực, token truy cập hoặc dữ liệu cá nhân nhạy cảm của khách hàng. Hãy chỉ ghi nhận mã định danh, trạng thái xử lý, số lượng bản ghi và thông điệp lỗi đã được chọn lọc. Bạn có thể xem thêm cách quản lý an toàn thông tin nhạy cảm tại bài viết về quản lý API key và credential an toàn trong workflow.
8. Đặt ngưỡng cảnh báo theo hạn chót nghiệp vụ
Để cảnh báo phát huy hiệu quả, bạn nên kết hợp hai loại ngưỡng độc lập:
- Ngưỡng theo hạn chót nghiệp vụ (Deadline): Trả lời câu hỏi: khi nào công việc bắt buộc phải hoàn thành để không làm gián đoạn hoạt động kinh doanh? Ví dụ: nếu tệp đối soát bắt buộc phải có trước 8 giờ sáng, cảnh báo phải phát ra từ lúc 7 giờ 30 nếu workflow chưa hoàn tất, giúp đội ngũ kỹ thuật có đủ 30 phút để xử lý thủ công trước giờ làm việc.
- Ngưỡng theo đường cơ sở (Baseline): Giúp phát hiện sự thay đổi bất thường so với trạng thái vận hành hàng ngày. Nếu một workflow xử lý đơn hàng thường chỉ chạy trong 10 giây nhưng hôm nay kéo dài hơn 2 phút, đó là dấu hiệu cho thấy API đối tác đang bị nghẽn hoặc cơ sở dữ liệu đang gặp hiện tượng khóa bảng (lock).
Tỷ lệ lỗi trung bình tính gộp trên toàn instance không phản ánh đúng mức độ nghiêm trọng. Một workflow ít chạy nhưng xử lý dữ liệu doanh thu quan trọng thì chỉ cần thất bại một lần đã phải xử lý ngay lập tức; ngược lại, các lỗi lặt vặt từ một luồng thử nghiệm không được phép làm phiền ca trực đêm. Hãy phân nhóm workflow theo mức độ quan trọng để gắn ngưỡng cảnh báo tương ứng.
9. Cảnh báo phải chỉ rõ bước kiểm tra đầu tiên
Một thông báo cảnh báo có giá trị thực tế bắt buộc phải trả lời nhanh các câu hỏi sau cho người trực ca:
- Workflow nào và môi trường nào (staging hay production) đang gặp vấn đề?
- Tín hiệu nào đã vượt ngưỡng, và sự cố bắt đầu từ thời điểm nào?
- Quy trình nghiệp vụ nào đang bị chậm trễ hoặc có nguy cơ mất mát dữ liệu?
- Có mã
executionIdhoặc mã tham chiếu cụ thể nào để tra cứu không? - Người trực ca cần kiểm tra ở đâu đầu tiên?
- Đường dẫn tới tài liệu hướng dẫn xử lý sự cố (runbook) và cách tạm dừng trigger an toàn nằm ở đâu?
Một thông báo ngắn gọn như "n8n error" không mang lại giá trị hành động. Ngược lại, thông báo: "[Production] Workflow 'Đồng bộ đơn hàng' không nhận được webhook nào trong 45 phút qua — Kiểm tra ngay trạng thái cổng thanh toán và reverse proxy" sẽ giúp người trực ca phản ứng chính xác ngay trong những phút đầu tiên.
Bạn có thể tham khảo thêm các nguyên tắc xây dựng thông báo trực ca tại bài viết về thiết kế cảnh báo có thể hành động.
10. Phân định vai trò: Dashboard, Cảnh báo tức thì và Báo cáo tuần
Hệ thống quan sát hoàn chỉnh cần phân tách rõ vai trò của ba công cụ:
- Cảnh báo tức thì (Alerts): Đánh thức hoặc kéo người trực ca vào xử lý ngay khi một chỉ số vượt ngưỡng hoặc vi phạm hạn chót nghiệp vụ.
- Bảng điều khiển (Dashboard): Nơi người trực ca mở ra để điều tra nguyên nhân gốc rễ và theo dõi xu hướng. Một dashboard gọn gàng nên chia làm ba tầng tương ứng: (1) Tình trạng container, CPU, RAM, database; (2) Tỷ lệ lỗi, thời gian chạy và hàng đợi của từng workflow; (3) Số lượng giao dịch thành công và kết quả đối soát.
- Báo cáo định kỳ (Weekly report): Giúp nhìn lại bức tranh vận hành tổng thể: những workflow nào hay gặp lỗi nhất, node tích hợp nào thường xuyên bị timeout, và những cảnh báo nào không dẫn tới hành động thực tế để tinh chỉnh lại ngưỡng.
Bạn có thể tham khảo cấu trúc đánh giá định kỳ tại bài viết về báo cáo vận hành VPS hàng tuần và thay thế các chỉ số máy chủ bằng các chỉ số tự động hóa tương ứng.
11. Kiểm thử hệ thống giám sát trước khi đưa vào vận hành
Hệ thống giám sát chỉ đáng tin cậy khi chính nó đã vượt qua các bài kiểm tra sự cố giả lập trên môi trường an toàn:
- Tạm dừng instance n8n để kiểm tra xem cảnh báo mất kết nối hạ tầng có phát ra trong vòng 2 phút không.
- Ngắt tạm thời kết nối cơ sở dữ liệu để xem endpoint
/healthz/readinesscó chuyển trạng thái lỗi và báo về kênh trực không. - Cố tình làm lỗi một execution thử nghiệm để xác nhận error workflow gửi đúng mã định danh và đường dẫn tra cứu.
- Tắt tạm thời một scheduled workflow để kiểm tra xem dịch vụ giám sát heartbeat có phát hiện sự cố "bỏ lỡ lượt chạy" hay không.
- Trả về phản hồi thành công kỹ thuật nhưng cố tình làm thiếu dữ liệu đích để kiểm tra xem tác vụ đối soát có bắt được độ lệch không.
Mỗi bài kiểm thử chỉ được tính là đạt khi cảnh báo gửi về đúng người, nội dung chỉ rõ hướng xử lý và cảnh báo tự động khép lại khi sự cố được khắc phục.
Bảng kiểm nhanh các tín hiệu cần theo dõi
| Tầng quan sát | Câu hỏi cốt lõi | Tín hiệu và bằng chứng cần xác nhận |
|---|---|---|
| Hạ tầng (Infrastructure) | Máy chủ và n8n có sẵn sàng nhận việc? | Endpoint /healthz/readiness trả về HTTP 200; CPU, RAM, dung lượng ổ đĩa < 80%; chứng chỉ SSL còn hạn. |
| Thực thi (Execution) | Workflow có chạy đúng giờ và hoàn tất đúng hạn? | Tín hiệu heartbeat của workflow định kỳ; thời gian thực thi (duration) không vượt hạn chót; tỷ lệ lỗi thấp. |
| Hàng đợi (Queue) | Các worker có đang xử lý kịp tiến độ? | Tuổi của job cũ nhất trong hàng đợi (oldest job age); số lượng job waiting không tăng bất thường; worker phản hồi tốt. |
| Lỗi & Truy vết (Diagnostics) | Sự cố nằm ở đâu và cần sửa gì? | Mã workflowId, executionId, mã correlation ID; thông điệp lỗi chi tiết từ error workflow; nhật ký đã lọc bảo mật. |
| Nghiệp vụ (Outcome) | Kết quả thực tế có đúng và đủ không? | Số lượng bản ghi tạo ra tại hệ thống đích khớp với đầu vào; mã tham chiếu đối soát hợp lệ; tiến trình đối soát độc lập không phát hiện lệch dữ liệu. |
| Cảnh báo (Alerts) | Người trực có hành động được ngay không? | Thông báo ghi rõ tên workflow, mức độ ảnh hưởng, mã tra cứu và đường dẫn mở tài liệu hướng dẫn xử lý. |
Kết luận
Một hệ thống giám sát workflow automation toàn diện chỉ thực sự hoàn tất khi bạn có thể trả lời được cả ba câu hỏi: hạ tầng có sẵn sàng, tiến trình có hoàn thành đúng hạn và kết quả nghiệp vụ có thực sự xuất hiện tại hệ thống đích hay không. Đừng chỉ dựa vào giao diện màu xanh của n8n; hãy kết hợp cơ chế heartbeat, mã tham chiếu đối soát và các cảnh báo có ngữ cảnh hành động để giữ cho hệ thống tự động hóa luôn vận hành bền vững.
Bước tiếp theo, hãy chọn ra một workflow quan trọng nhất trên hệ thống của bạn, viết rõ định nghĩa "công việc đã hoàn tất" và đối chiếu với bảng kiểm trên để bổ sung các mắt xích giám sát còn thiếu.