Một kỹ sư trực ca đặt câu hỏi cho AI: "Sau khi xoay vòng thông tin xác thực (credential) của dịch vụ thanh toán, tôi cần khởi động lại những thành phần nào?"
Câu trả lời xuất hiện ngay tức thì. Mô hình AI liệt kê các bước rất trôi chảy: khởi động lại API service, kiểm tra kết nối mạng và theo dõi log hệ thống. Mọi thứ nghe rất hợp lý và đúng chuẩn kỹ thuật chung. Tuy nhiên, quy trình vận hành nội bộ (runbook) mới nhất của công ty vừa được cập nhật tuần trước lại quy định nghiêm ngặt: sau khi đổi credential, kỹ sư bắt buộc phải khởi động lại cả worker ngầm và xóa trắng một vùng cache dữ liệu trên Redis. Nếu thiếu hai thao tác này, worker vẫn tiếp tục gửi dữ liệu bằng token cũ và làm sập toàn bộ luồng thanh toán tự động.
Mô hình AI hoàn toàn không có lỗi trong tình huống này. Nó không thể biết được tài liệu nội bộ của bạn vừa sửa đổi những gì. Mô hình chỉ đơn thuần suy luận dựa trên kiến thức chung từ dữ liệu huấn luyện mở trên internet. Để AI trả lời đúng chuẩn riêng của từng doanh nghiệp, hệ thống bắt buộc phải tìm đúng đoạn tài liệu nội bộ đang áp dụng rồi chuyển cho mô hình đọc trước khi viết câu trả lời.
Đó chính là nguyên lý cốt lõi của RAG (Retrieval-Augmented Generation).
RAG có thể hiểu một cách mộc mạc là: tìm kiếm thông tin trước, rồi mới đưa cho AI đọc và soạn câu trả lời sau. Bản thân mô hình AI không tự động học thêm tài liệu mới của bạn vào trọng số (weights), cũng không cần phải trải qua quá trình huấn luyện lại (fine-tuning) tốn kém sau mỗi lần cập nhật chính sách.
Cơ chế ba bước của một luồng RAG tiêu chuẩn
Khi bạn hỏi một mô hình AI thông thường, câu hỏi được gửi thẳng tới mô hình. Mô hình lục lọi trong "trí nhớ" sẵn có để tổng hợp câu trả lời. Cách làm này hoạt động tốt với các kiến thức đại chúng (như cú pháp lập trình, giải thích khái niệm), nhưng hoàn toàn bất lực trước dữ liệu riêng tư và quy trình đặc thù của doanh nghiệp.
Một hệ thống RAG bổ sung thêm một lớp tìm kiếm chuyên biệt đứng ở giữa. Theo định nghĩa từ tài liệu kỹ thuật của Google Cloud Generative AI, một chuỗi RAG gồm ba bước cơ bản:
- Tìm kiếm (Retrieve): Hệ thống lấy câu hỏi của người dùng để quét qua kho dữ liệu nội bộ và trích xuất ra một vài đoạn văn bản có mức độ liên quan cao nhất.
- Bổ sung ngữ cảnh (Augment): Gom các đoạn văn bản vừa tìm được ghép chung với câu hỏi gốc và bộ quy tắc an toàn vào một prompt duy nhất.
- Sinh nội dung (Generate): Mô hình AI đọc prompt chứa dữ liệu thực tế và đóng vai trò như một người biên tập: tổng hợp thông tin, so sánh dữ kiện và viết thành một câu trả lời hoàn chỉnh.
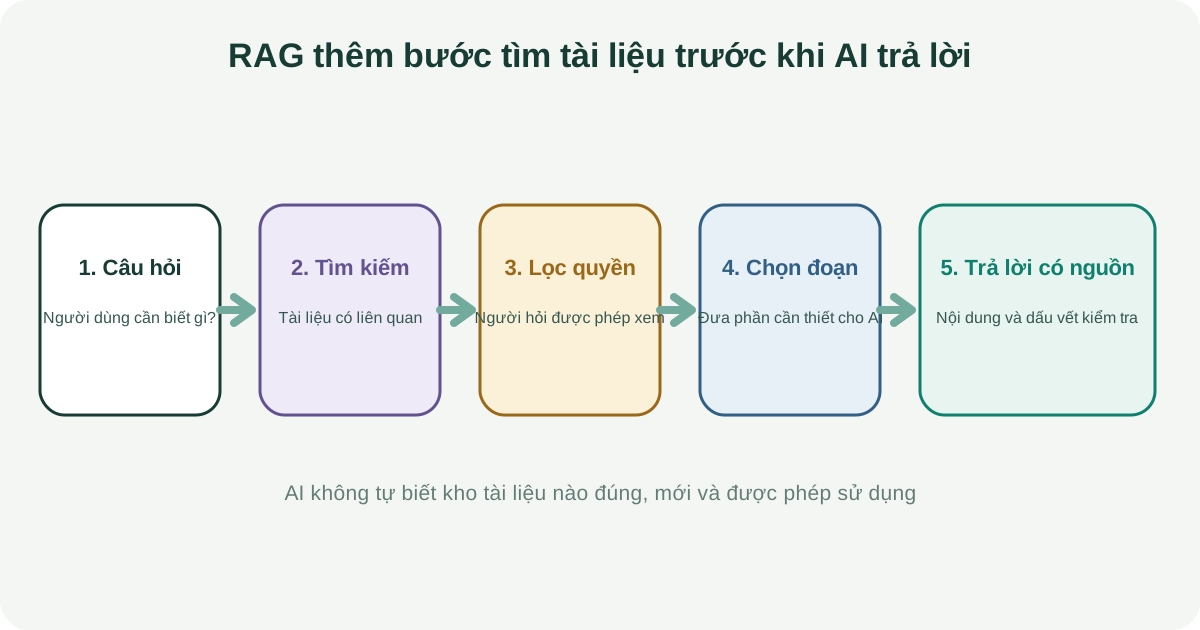
Khâu phức tạp nhất trong RAG không nằm ở việc gọi mô hình AI để hành văn. Nút thắt kỹ thuật luôn nằm ở khâu tìm kiếm: làm sao để hệ thống tìm đúng tài liệu, đúng phiên bản hiện hành và đúng phạm vi bảo mật mà người dùng đó được phép xem.
Nếu khâu tìm kiếm trích xuất nhầm bản hướng dẫn cũ từ năm ngoái, mô hình AI dù thông minh đến đâu cũng sẽ tạo ra một câu trả lời sai lệch với độ tự tin tuyệt đối. RAG giúp câu trả lời có căn cứ đối chiếu, nhưng không đảm bảo kết quả luôn đúng nếu dữ liệu đầu vào bị sai.
Đánh giá nhu cầu thực tế trước khi đầu tư hạ tầng RAG
Nhiều đội ngũ kỹ thuật có tâm lý vội vã: cứ nghe nói muốn hỏi đáp trên tài liệu nội bộ là lập tức nghĩ đến việc dựng cụm Vector Database, cắt nhỏ văn bản (chunking) và lập chỉ mục phức tạp. Đây là một sự lãng phí tài nguyên lớn khi bài toán thực tế chưa đòi hỏi kiến trúc nặng nề đến vậy.
Hãy tự hỏi xem hệ thống của bạn có rơi vào các trường hợp đơn giản sau hay không:
- Số lượng tài liệu rất ít: Nếu nhóm vận hành chỉ có 3 đến 5 bản runbook tiêu chuẩn, cách đơn giản và an toàn nhất là mở trực tiếp file đó ra, sao chép đoạn văn bản cần thiết và dán thẳng vào prompt. Việc dựng cả một đường ống RAG tự động chỉ để tiết kiệm 10 giây mở file của kỹ sư sẽ mang lại gánh nặng bảo trì lớn hơn rất nhiều so với giá trị thu lại.
- Tìm kiếm chính xác bằng từ khóa đã giải quyết tốt: Với các câu hỏi chứa mã lỗi cụ thể (như
AUTH-1042), tên service (payment-worker) hoặc chuỗi cấu hình cố định, các công cụ tìm kiếm toàn văn truyền thống (như Elasticsearch, OpenSearch hoặc thậm chí lệnhgrep) hoạt động cực kỳ chính xác và ổn định. Bạn không cần đến thuật toán tìm kiếm ngữ nghĩa (semantic search) chỉ để tra cứu một mã lỗi duy nhất. - Ngữ cảnh cố định theo tác vụ: Nếu một bot hỗ trợ chỉ làm duy nhất một nhiệm vụ là hướng dẫn đăng ký tài khoản, bạn chỉ cần nạp toàn bộ quy trình đó vào system prompt cố định và tận dụng tính năng Prompt Caching.
Những điều kiện thực sự cần đến giải pháp RAG
RAG chỉ thực sự trở thành một khoản đầu tư xứng đáng khi hệ thống của bạn chạm tới các ranh giới vận hành sau:
- Quy mô kho tài liệu vượt quá dung lượng context: Khi doanh nghiệp sở hữu hàng nghìn trang tài liệu kỹ thuật, hàng trăm quy chế nhân sự hoặc hàng triệu bản ghi lịch sử sự cố. Bạn không thể dồn toàn bộ kho dữ liệu này vào một prompt mà không làm cạn kiệt ngân sách token và gây loãng sự chú ý của mô hình.
- Dữ liệu biến động liên tục theo thời gian: Bảng giá dịch vụ thay đổi hàng tuần, quy định hoàn tiền cập nhật hàng tháng, hoặc thông số cấu hình server thay đổi sau mỗi đợt triển khai phần mềm. RAG cho phép bạn chỉ cần cập nhật dữ liệu vào kho lưu trữ nội bộ là AI sẽ lập tức trích xuất thông tin mới nhất mà không phải can thiệp vào code hay prompt.
- Cách đặt câu hỏi của người dùng rất đa dạng: Người dùng không nhớ chính xác tiêu đề tài liệu hay thuật ngữ kỹ thuật chuyên môn. Họ hỏi bằng ngôn ngữ tự nhiên: "Hôm nay cổng trừ tiền bị chậm thì xử lý thế nào?". Thuật toán tìm kiếm ngữ nghĩa của RAG sẽ hiểu được ý định và tìm đúng tài liệu
payment-gateway-troubleshooting.mddù trong câu hỏi không chứa từ "gateway". - Bắt buộc phải dẫn nguồn đối chiếu minh bạch: Trong các lĩnh vực kỹ thuật, y tế hoặc pháp lý, một câu trả lời dù viết hay đến đâu cũng vô giá trị nếu không biết trích từ văn bản nào. RAG có khả năng đính kèm chính xác đường dẫn tài liệu và số dòng trích xuất để kỹ sư có thể mở ra đối soát trước khi bấm nút thực thi.
Tuy nhiên, việc hệ thống trích dẫn đúng đường dẫn nguồn không có nghĩa là AI đã hiểu đúng 100% nội dung. Mô hình vẫn có thể diễn giải sai một điều kiện ràng buộc trong hợp đồng hoặc trích nhầm một đoạn văn bản thuộc phiên bản thử nghiệm. Trích dẫn nguồn chỉ giúp con người kiểm tra nhanh hơn, chứ không thay thế được trách nhiệm thẩm định của kỹ sư trực ca.
Kho tài liệu lộn xộn sẽ tạo ra câu trả lời lộn xộn
Một ảo tưởng phổ biến là hy vọng RAG sẽ trở thành chiếc "chổi thần" dọn sạch đống tài liệu nội bộ đang bừa bộn của doanh nghiệp. Nhiều người tin rằng chỉ cần đổ toàn bộ thư mục Google Drive hay Confluence vào hệ thống là AI sẽ tự động phân loại và trả lời chuẩn xác.
Thực tế hoàn toàn trái ngược: nếu kho dữ liệu ban đầu là rác, đầu ra của RAG chắc chắn sẽ là rác được định dạng đẹp mắt.
Hãy nhìn vào thư mục tài liệu của một nhóm vận hành sau ba năm hoạt động:
huong-dan-khoi-phuc-thanh-toan.docx
huong-dan-khoi-phuc-thanh-toan-chuan.docx
huong-dan-khoi-phuc-thanh-toan-chuan-v2-moi.docx
Cả ba tài liệu đều tồn tại song song trên hệ thống lưu trữ. Bản cũ nói chỉ cần khởi động lại API; bản mới hơn yêu cầu kiểm tra worker; bản mới nhất thì bổ sung bước xóa cache. Khi người dùng đặt câu hỏi, thuật toán tìm kiếm có thể quét trúng bản cũ nhất chỉ vì file đó chứa nhiều từ khóa trùng khớp hơn. Mô hình AI nhận được tài liệu lỗi thời và tự tin đưa ra hướng dẫn sai quy chuẩn hiện hành.
RAG không có khả năng tự phán đoán xem file nào là "chính thức" nếu con người không dọn dẹp và gắn siêu dữ liệu (metadata) rõ ràng. Trước khi nghĩ đến việc lập chỉ mục cho RAG, bạn phải giải quyết ba bài toán cơ bản của quản trị dữ liệu:
- Xác định phiên bản duy nhất có hiệu lực: Lưu trữ tài liệu theo cấu trúc rõ ràng, đánh số phiên bản và loại bỏ các file nháp cũ khỏi khu vực tìm kiếm.
- Thời hạn của thông tin: Gắn ngày cập nhật vào từng tài liệu. Thuật toán tìm kiếm phải biết ưu tiên các tài liệu mới xuất bản thay vì đối xử bình đẳng với một file đã viết từ ba năm trước.
- Ghi rõ điều kiện áp dụng: Một quy trình chỉ áp dụng cho môi trường Staging thì phải được ghi chú tường minh, tránh để hệ thống nhầm lẫn và trích xuất áp dụng cho hệ thống Production.
Rủi ro rò rỉ dữ liệu khi thiếu lớp phân quyền ở khâu tìm kiếm
Đây là lỗ hổng bảo mật nghiêm trọng nhất mà các doanh nghiệp thường bỏ quên khi thử nghiệm RAG nội bộ.
Trong một tổ chức, mỗi nhân viên có một mức quyền hạn truy cập tài liệu khác nhau. Kỹ sư mới vào nghề chỉ được xem tài liệu kỹ thuật cơ bản. Trưởng nhóm được xem kế hoạch phân bổ nhân sự. Ban giám đốc và phòng nhân sự mới có quyền truy cập bảng lương và báo cáo tài chính nội bộ.
Nếu bạn lập chỉ mục toàn bộ tài liệu công ty vào một kho vector chung mà không tích hợp danh sách kiểm soát quyền truy cập (Access Control List - ACL), hệ thống RAG sẽ vô tình trở thành cánh cửa sau làm lộ bí mật:
- Một nhân viên thử việc gõ câu hỏi: "Chính sách đãi ngộ và mức thưởng cho các vị trí quản lý hiện nay ra sao?".
- Khâu tìm kiếm quét qua toàn bộ cơ sở dữ liệu, trích xuất đoạn văn bản từ biên bản họp kín của hội đồng quản trị và đưa vào prompt.
- AI đọc tài liệu và ngoan ngoãn tóm tắt lại toàn bộ số liệu nhạy cảm cho nhân viên thử việc xem.
Tài liệu hướng dẫn của OWASP về rủi ro LLM (LLM08: Vector and Embedding Weaknesses) cảnh báo rất rõ: việc phân quyền bắt buộc phải được thực hiện ở khâu tìm kiếm (Retrieval stage), chứ không thể dựa vào các câu lệnh nhắc AI kiểu "hãy từ chối nếu người dùng không phải là sếp". Mô hình AI rất dễ bị đánh lừa qua các kỹ thuật prompt injection; chỉ có việc chặn không cho dữ liệu nhạy cảm lọt vào prompt ngay từ tầng tìm kiếm mới là giải pháp an toàn tuyệt đối.
Lộ trình ba bước triển khai an toàn trước khi dựng hệ thống RAG
Để tránh rơi vào cái bẫy lãng phí thời gian và ngân sách cho một kiến trúc cồng kềnh, đội ngũ kỹ thuật nên đi theo lộ trình từng bước từ đơn giản đến phức tạp:
Bước 1: Thủ công             Bước 2: Tìm kiếm lai              Bước 3: RAG hoàn chỉnh
Dán trực tiếp tài liệu  -->  Tìm từ khóa + Ngữ nghĩa     -->  Tự động hóa luồng RAG
vào context của prompt (Hybrid Search nội bộ) kèm phân quyền ACL- Bước 1: Đưa tài liệu trực tiếp vào prompt (Manual Ingestion): Khi thử nghiệm một tính năng hoặc quy trình mới, hãy chọn ra 10 câu hỏi phổ biến nhất và dán thủ công các đoạn tài liệu tương ứng vào context. Đánh giá xem mô hình AI có khả năng đọc hiểu và trả lời chính xác dựa trên tài liệu đó hay không. Nếu bản thân AI đọc tài liệu mà vẫn diễn giải sai, việc xây RAG phía trước hoàn toàn vô nghĩa.
- Bước 2: Nâng cấp công cụ tìm kiếm nội bộ (Search First): Tận dụng tính năng tìm kiếm sẵn có của doanh nghiệp. Áp dụng cơ chế tìm kiếm lai (Hybrid Search) kết hợp giữa tìm từ khóa chính xác (BM25) và tìm kiếm theo ý nghĩa (vector embeddings). Đảm bảo rằng khi người dùng gõ câu hỏi, hệ thống luôn hiển thị đúng tài liệu gốc lên đầu danh sách kết quả.
- Bước 3: Kết nối tự động hóa vào mô hình AI (Full RAG Pipeline): Chỉ khi khâu tìm kiếm đạt độ chính xác trên 85% và người dùng có nhu cầu tổng hợp câu trả lời tự động, bạn mới nối API tìm kiếm đó vào mô hình ngôn ngữ lớn, đồng thời tích hợp chặt chẽ cơ chế lọc quyền truy cập theo từng tài khoản.
Giải pháp cho tình huống dịch vụ thanh toán ở đầu bài viết
Trở lại tình huống người trực ca hỏi về cách khởi động lại hệ thống thanh toán: sau khi thay đổi credential, làm thế nào để đảm bảo AI hướng dẫn đầy đủ cả bước restart worker và xóa cache Redis?
Khi áp dụng đúng nguyên lý RAG có kiểm soát:
- Hệ thống tìm kiếm chỉ quét các tài liệu được gắn thẻ
status: activetrong kho runbook của nhóm DevOps. Các file nháp cũ bị loại bỏ hoàn toàn. - Đoạn văn bản về quy trình đổi credential được trích xuất kèm thông tin phiên bản:
payment-runbook-v3.2.md (cập nhật ngày 10/10/2026). - Câu trả lời của AI liệt kê tuần tự 4 bước: (1) Đổi credential, (2) Khởi động lại API, (3) Khởi động lại background worker, và (4) Flush cache Redis. Ở cuối câu trả lời, AI dẫn kèm đường link đến đúng file runbook để người trực ca bấm vào đối soát trước khi gõ lệnh trên terminal.
Nhờ đó, kỹ sư trực ca vừa tiết kiệm được thời gian tra cứu tài liệu, vừa có đầy đủ căn cứ xác thực để thực hiện các thao tác kỹ thuật có độ rủi ro cao một cách an toàn.
Checklist 5 câu hỏi quyết định bạn có cần RAG hay không
Trước khi quyết định viết code hay mua một nền tảng RAG thương mại, hãy tự trả lời 5 câu hỏi sau:
- ☐ Kho tài liệu nội bộ đã được dọn dẹp sạch sẽ, loại bỏ file trùng lặp và có quy ước đánh số phiên bản rõ ràng chưa?
- ☐ Số lượng tài liệu có vượt quá khả năng đưa trực tiếp vào context của các mô hình hiện đại không?
- ☐ Công cụ tìm kiếm từ khóa thông thường đã bộc lộ giới hạn khi người dùng hỏi bằng nhiều cách diễn đạt khác nhau chưa?
- ☐ Đã có giải pháp phân quyền truy cập (ACL) ở tầng tìm kiếm để ngăn nhân viên xem trộm tài liệu mật chưa?
- ☐ Người dùng có thực sự cần một câu trả lời tổng hợp bằng văn bản tự nhiên, hay họ chỉ cần đường link dẫn thẳng tới tài liệu gốc?
Tài liệu tham khảo
- Google Cloud Generative AI Documentation - Retrieval-Augmented Generation (RAG) Architecture and Concepts.
- AWS Architecture Center - Question answering using Retrieval Augmented Generation with Amazon Bedrock.
- OWASP Top 10 for Large Language Model Applications (2025) - LLM08: Vector and Embedding Weaknesses & Data Leakage.