Bản thử nghiệm xử lý 100 ticket hỗ trợ khách hàng chạy rất rẻ. Mỗi ticket gửi lên mô hình một lần, kết quả trả về là một đoạn tóm tắt ngắn. Kỹ sư phụ trách lấy chi phí trung bình của một request thử nghiệm, nhân với 10.000 ticket dự kiến mỗi tháng rồi cộng thêm 15% dự phòng rủi ro. Con số dự toán chỉ vỏn vẹn vài trăm đô la — mức chi phí quá hấp dẫn để ban giám đốc phê duyệt đưa workflow vào vận hành chính thức.
Hóa đơn của tháng đầu tiên trên production vượt gấp bốn lần con số dự toán.
Thực tế vận hành không đơn giản như phòng lab:
- Trước khi tóm tắt, hệ thống phải chạy một lượt gọi mô hình nhỏ để phân loại yêu cầu.
- Các ticket phức tạp bị dồn thêm toàn bộ lịch sử trao đổi qua email khiến kích thước prompt phình to gấp mười lần.
- Khi kết quả trả về bị lỗi JSON hoặc thiếu trường dữ liệu bắt buộc, hệ thống tự động kích hoạt cơ chế thử lại (retry).
- Những ticket bị chuyên gia từ chối ở cổng phê duyệt buộc phải chạy lại lượt suy luận thứ hai với ngữ cảnh bổ sung.
Sai lầm phổ biến nhất khi lập dự toán AI là đồng nhất khái niệm "một API call" với "một tác vụ hoàn thành". Bảng giá của nhà cung cấp tính theo từng token rời rạc, nhưng doanh nghiệp chỉ trả tiền cho kết quả cuối cùng được chấp nhận. Giữa hai con số đó là toàn bộ sự phức tạp của một chuỗi quy trình kỹ thuật.
Bắt đầu từ luồng thực thi thực tế thay vì bảng giá lý thuyết
Để tính toán chi phí chính xác, bạn không thể nhìn vào mức giá niêm yết $2/triệu token rồi làm phép tính nhân đơn giản. Điểm xuất phát bắt buộc phải là sơ đồ đường đi thực tế của một yêu cầu trong hệ thống.
Hãy phân tích đường đi của một ticket kỹ thuật tiêu chuẩn:
- Lượt gọi 1 (Router): Đọc tiêu đề để phân loại nghiệp vụ và chọn tài liệu liên quan. Input ngắn, output chỉ là một mã phân loại (vài chục token).
- Lượt gọi 2 (RAG & Draft): Ghép ticket gốc với hai bài hướng dẫn nội bộ để soạn câu trả lời. Input lúc này có thể lên tới 4.000 token, output khoảng 500 token.
- Lượt gọi 3 (Validation): Kiểm tra lại cú pháp và các cam kết kỹ thuật trước khi gửi qua cổng phê duyệt của con người.
Chỉ riêng nhánh xử lý thuận lợi nhất đã tiêu tốn ba lượt gọi mô hình với kích thước ngữ cảnh hoàn toàn khác nhau. Nếu ticket thiếu thông tin định danh, quy trình phải rẽ nhánh để gửi tin nhắn hỏi lại khách hàng. Nếu mô hình sinh ra nội dung sai lệch, kỹ sư phải từ chối và kích hoạt lượt chạy lại.
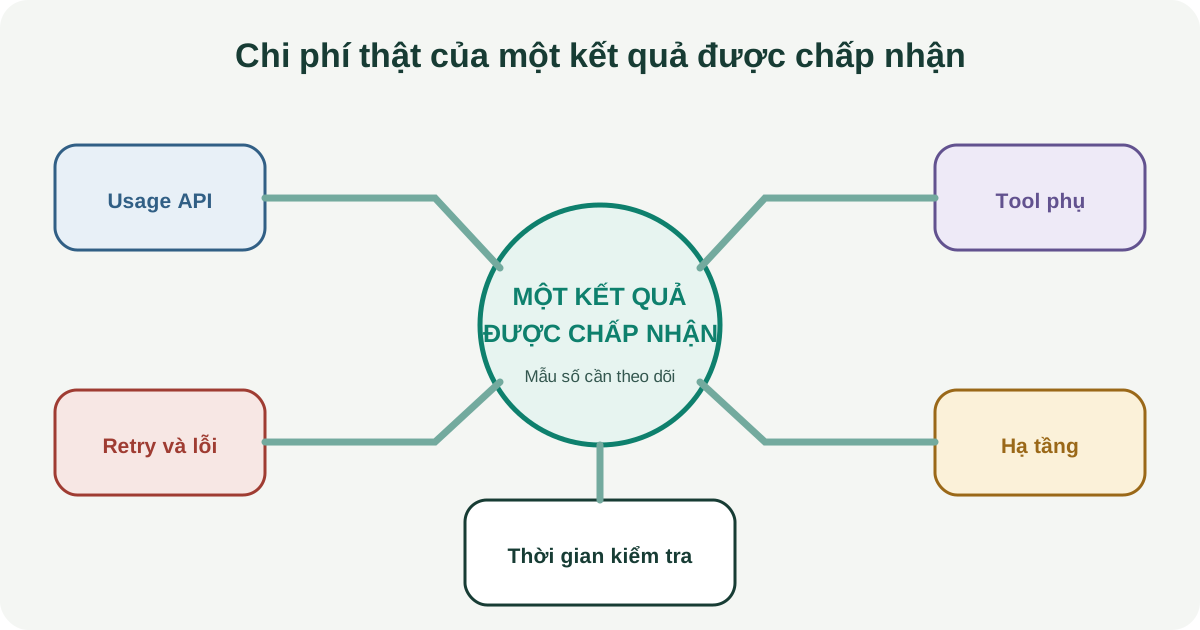
Cách tính đáng tin cậy nhất là bóc tách nhật ký vận hành (log) của hệ thống thành ba nhóm tỷ lệ:
- Nhánh thuận lợi (Happy path): Tỷ lệ các tác vụ đi thẳng một mạch từ đầu đến cuối mà không gặp lỗi (ví dụ: 65%).
- Nhánh phát sinh retry (Exception path): Tỷ lệ các tác vụ phải gọi lại API do lỗi định dạng hoặc lỗi mạng (ví dụ: 20%).
- Nhánh chuyển tiếp chuyên gia (Escalation path): Tỷ lệ các tác vụ phức tạp phải đổi sang mô hình cao cấp hơn hoặc xử lý lại thủ công (ví dụ: 15%).
Gán chi phí đo lường được cho từng nhánh rẽ sẽ giúp bạn nhìn thấy bức tranh ngân sách sát với thực tế, loại bỏ hoàn toàn cảm giác bất ngờ khi nhận hóa đơn vào cuối tháng.
Đo lường chi phí dựa trên dữ liệu đối soát thực tế từ API
Nhiều nhà phát triển có thói quen ước tính chi phí bằng các thư viện đếm token phía client (như tiktoken hoặc các hàm tokenizer cục bộ). Các công cụ này rất hữu ích trong việc ước tính sơ bộ hoặc chặn các request vượt quá giới hạn ngữ cảnh, nhưng chúng không phản ánh con số billing cuối cùng của nhà cung cấp dịch vụ.
Khi hệ thống bắt đầu dùng tính năng gọi hàm (function calling), nhúng hình ảnh, hoặc tận dụng cơ chế lưu đệm ngữ cảnh (prompt caching), cách tính token của nền tảng đám mây sẽ có sự phân hóa rõ rệt. Tài liệu của Google Cloud Vertex AI nêu rõ rằng số lượng token phục vụ tính cước chính xác nhất chỉ xuất hiện trong trường usage_metadata được trả về sau khi request thực thi xong. Tương tự, đối tượng usage của OpenAI Chat Completions API cũng phân tách chi tiết thành prompt token, completion token và cached token.
Để đối soát chi phí một cách khoa học, hệ thống của bạn cần lưu lại các trường thông tin tối thiểu sau cho mỗi lượt gọi API:
- Mã lượt chạy của tác vụ (
execution_id) và định danh bước thực hiện (step_name). - Phiên bản mô hình cụ thể (tránh dùng alias chung chung như
latestvì giá có thể thay đổi theo từng đợt cập nhật). - Số lượng token đầu vào chuẩn, token đầu vào có áp dụng cache, và số lượng token đầu ra thực tế.
- Trạng thái thực thi (thành công, lỗi cú pháp, hay timeout).
Từ dữ liệu này, chi phí cho mỗi lượt gọi API được bóc tách theo công thức chuẩn:
Chi phí lượt gọi
= (Token input thường × Giá input)
+ (Token input có cache × Giá cache)
+ (Token output × Giá output)
+ (Phí gọi công cụ / Search nếu có)
Bạn không nên mặc định rằng mọi câu lệnh lặp lại đều tự động được giảm giá nhờ cache. Chỉ có trường dữ liệu cached_tokens trong kết quả trả về mới chứng minh được request đó có tận dụng được vùng nhớ đệm hay không. Tương tự, các request thất bại giữa chừng do ngắt kết nối mạng hoặc lỗi kiểm duyệt nội dung vẫn có thể bị tính phí cho phần token mà mô hình đã xử lý trước đó.
Kiểm soát sự phình to của ngữ cảnh trong các quy trình dài
Trong môi trường thử nghiệm, kỹ sư thường chỉ kiểm tra với một câu hỏi đơn lẻ kèm một đoạn văn bản ngắn. Nhưng khi đưa lên production, kích thước của dữ liệu đầu vào bắt đầu phình to nhanh chóng do ba nguyên nhân:
- Chuỗi lịch sử trao đổi kéo dài: Trong các ứng dụng trợ lý ảo hoặc hỗ trợ kỹ thuật, toàn bộ lịch sử 10 lượt chat trước đó thường bị gửi kèm vào mỗi câu hỏi mới. Một cuộc trò chuyện càng kéo dài thì mỗi câu hỏi ngắn ở cuối phiên lại phải trả tiền cho toàn bộ ngữ cảnh đã tích lũy từ đầu.
- System prompt đồ sộ: Các hướng dẫn an toàn, định dạng JSON schema mẫu và quy tắc ứng xử nội bộ có thể chiếm từ 1.500 đến 3.000 token cố định. Nếu một tác vụ gồm 3 bước suy luận liên tiếp mà không có cơ chế prompt caching, bạn đang trả tiền ba lần cho cùng một bộ quy tắc giống hệt nhau.
- Tài liệu RAG không được cắt lọc: Việc đưa nguyên cả tài liệu PDF dài 20 trang vào prompt thay vì chỉ trích xuất đúng 3 đoạn văn có liên quan trực tiếp khiến chi phí input tăng vọt mà không đem lại giá trị suy luận nào tốt hơn.
Chi phí đầu vào (input tokens) thường rẻ hơn chi phí đầu ra (output tokens) tính trên mỗi đơn vị, nhưng khối lượng input lại thường gấp từ 10 đến 30 lần khối lượng output. Do đó, việc tối ưu hóa và cắt gọt ngữ cảnh đầu vào mới là nơi giúp doanh nghiệp tiết kiệm ngân sách nhiều nhất trong toàn bộ workflow.
Tác động khuếch đại chi phí từ cơ chế thử lại và kiểm duyệt
Cơ chế tự động thử lại (retry) là kỹ thuật phổ biến để bảo đảm tính ổn định của hệ thống phân tán. Tuy nhiên, trong các workflow sử dụng AI, một vòng lặp retry không được kiểm soát chặt chẽ sẽ nhanh chóng nhân bản chi phí lên gấp nhiều lần.
Hãy xem xét một tình huống thực tế: mô hình AI nhận được prompt dài 5.000 token để trích xuất dữ liệu thành cấu trúc JSON. Vì một lý do nào đó, kết quả trả về bị thiếu một dấu ngoặc nhọn ở cuối khiến code backend không parse được:
- Lần gọi 1: Tiêu tốn 5.000 token input + 800 token output. Kết quả bị hỏng.
- Cơ chế tự động kích hoạt lần gọi 2: Hệ thống gửi lại toàn bộ 5.000 token cũ kèm theo thông báo lỗi cú pháp. Tiêu tốn thêm 5.500 token input + 800 token output.
- Nếu lần 2 vẫn lỗi và tiếp tục thử lần 3, chi phí của một tác vụ đơn lẻ đã tăng gấp ba lần so với dự toán ban đầu.
Một nguồn khuếch đại chi phí khác đến từ việc người duyệt từ chối kết quả. Khi một kỹ sư bấm "Từ chối" trên giao diện phê duyệt vì AI trích dẫn sai số liệu, hệ thống buộc phải nạp thêm ngữ cảnh bổ sung và chạy lại lượt suy luận mới. Nếu tỷ lệ từ chối của người duyệt là 15%, điều đó có nghĩa là ít nhất 15% khối lượng công việc đang phải tiêu tốn chi phí gọi mô hình từ hai đến ba lần.
Để ngăn chặn sự lãng phí này, workflow cần áp dụng kỹ thuật kiểm tra cục bộ (local validation):
- Sử dụng các thư viện sửa lỗi cú pháp nhẹ (như
dirtyjsonhoặc regex) ở tầng code backend để khắc phục các lỗi nhỏ thay vì gọi lại toàn bộ mô hình LLM lớn. - Giới hạn số lần retry tối đa không quá 1 lần đối với cùng một prompt. Nếu tiếp tục thất bại, tác vụ phải được chuyển thẳng sang hàng chờ thủ công thay vì tiếp tục đốt ngân sách vào các lượt suy luận vô vọng.
Đừng bỏ quên chi phí hạ tầng phụ trợ và thời gian của con người
Một sai lầm kinh điển khác là chỉ cộng dồn tiền hóa đơn API từ nhà cung cấp mô hình (như OpenAI hay Anthropic) mà quên mất toàn bộ hệ sinh thái phần mềm chạy xung quanh.
Một tác vụ AI hoàn chỉnh thường kéo theo ba nhóm chi phí phụ trợ:
- Chi phí Embedding và Vector Database: Mỗi khi người dùng đặt câu hỏi, hệ thống phải gọi API tạo vector nhúng (embedding), sau đó truy vấn vào các cơ sở dữ liệu chuyên dụng (như Pinecone, Qdrant hay pgvector). Các dịch vụ này đều tính phí lưu trữ hàng tháng và phí trên từng lượt truy vấn dữ liệu.
- Chi phí công cụ bên thứ ba: Nếu workflow sử dụng tính năng tìm kiếm web (Web Search API), bóc tách văn bản từ PDF (OCR API) hoặc các công cụ phân tích dữ liệu, chi phí của các dịch vụ này thường đắt tương đương, thậm chí đắt hơn cả một lượt gọi LLM thông thường.
- Chi phí thời gian thẩm định của con người: Đây là khoản chi phí lớn nhất nhưng hầu như không bao giờ xuất hiện trong bảng tính kỹ thuật. Nếu một kỹ sư có mức lương 15 USD/giờ phải mất 2 phút để đọc và đối chiếu một bản nháp do AI soạn, chi phí nhân sự cho bước duyệt đó là 0,50 USD. Con số này cao gấp hàng chục lần chi phí token của mô hình (thường chỉ vài cent).
Nếu workflow được thiết kế vụng về khiến con người phải mất quá nhiều thời gian kiểm tra lại các lỗi ngớ ngẩn của AI, khoản tiết kiệm từ việc tự động hóa sẽ bị xóa sạch bởi chính chi phí nhân sự ngồi rà soát hàng ngày.
Công thức tính chi phí toàn diện trên mỗi tác vụ hoàn tất
Thay vì tính chi phí theo từng request riêng lẻ, chỉ số tài chính chuẩn xác nhất mà bạn cần báo cáo là Chi phí trên mỗi công việc hoàn thành được chấp nhận (Cost per Accepted Output).
Công thức tổng quát được xác lập như sau:
$$\text{Chi phí tác vụ} = \frac{\sum (\text{Phí LLM} + \text{Phí Retry} + \text{Phí Tool/RAG}) + \text{Phí duyệt con người}}{\text{Số lượng tác vụ hoàn thành thực tế}}$$
Hãy nhìn vào bảng so sánh giữa giả định ban đầu khi làm PoC và số liệu vận hành thực tế trên production:
| Hạng mục chi phí | Giả định ban đầu (PoC) | Thực tế vận hành (Production) |
|---|---|---|
| Số lượt gọi mô hình | 1 lần duy nhất | 2,3 lần (Router + RAG + Retry) |
| Kích thước prompt | 800 token | 4.200 token (kèm context & history) |
| Tỷ lệ thử lại (Retry) | 0% | 18% (lỗi JSON hoặc timeout) |
| Phí dịch vụ phụ trợ | 0 USD | 0,02 USD (Embedding + Search API) |
| Thời gian con người rà soát | Bỏ qua (coi như tự động) | 1,5 phút/ticket (tương đương 0,40 USD) |
| Tổng chi phí / ticket | 0,015 USD | 0,485 USD (tăng gấp hơn 30 lần) |
Bảng số liệu trên chỉ ra sự thật phũ phàng: chi phí mô hình AI thuần túy chỉ chiếm một phần nhỏ trong bức tranh tổng thể. Khi tính toán đầy đủ các nhánh lỗi, chi phí công cụ và thời gian con người phải can thiệp, con số ngân sách thực tế có thể cao hơn hàng chục lần so với dự toán trên slide thuyết trình.
Thiết lập hạn mức cảnh báo và ngắt tự động
Để bảo vệ ngân sách của doanh nghiệp trước các đợt bùng nổ lưu lượng hoặc vòng lặp vô tận do bug phần mềm, bạn cần triển khai cơ chế kiểm soát chi phí ở cả tầng ứng dụng lẫn tầng tài khoản đám mây:
- Thiết lập ngân sách cứng (Hard cap) trên dashboard nhà cung cấp: Cài đặt hạn mức chi tiêu hàng ngày và hàng tháng trên console của OpenAI, Anthropic hay Google Cloud. Khi vượt quá 80% hạn mức, hệ thống phải gửi cảnh báo qua kênh chat nội bộ; khi chạm 100%, API phải tự động từ chối request thay vì tiếp tục tính tiền nợ thẻ tín dụng.
- Kiểm soát độ dài ngữ cảnh bằng mã nguồn (Context truncation): Trước khi gửi prompt, luôn chạy hàm cắt tỉa (pruning) để loại bỏ các lượt chat quá cũ hoặc giới hạn độ dài của tài liệu RAG ở một số lượng token cố định.
- Áp dụng mô hình định tuyến thông minh (Model routing): Không dùng một mô hình flagship đắt đỏ (như GPT-4o hay Claude 3.5 Sonnet) cho toàn bộ các khâu. Hãy sử dụng các mô hình nhỏ, tốc độ cao và chi phí thấp (như GPT-4o-mini hoặc Gemini Flash) cho các tác vụ phân loại sơ bộ, tóm tắt và trích xuất thực thể. Chỉ chuyển tiếp sang mô hình lớn khi gặp các tác vụ lập luận đa bước phức tạp.
- Theo dõi chi phí theo mã dự án hoặc phòng ban (Cost tagging): Gắn metadata định danh phòng ban (
department_id) hoặc tính năng (feature_tag) vào mỗi request. Điều này giúp bạn nhận diện chính xác tính năng nào đang gây lãng phí tài nguyên để có kế hoạch tối ưu hóa kịp thời.
Checklist kiểm soát chi phí workflow AI trước khi chạy chính thức
Trước khi công bố tính năng AI cho người dùng cuối, hãy tự kiểm tra 5 tiêu chí kỹ thuật sau:
- ☐ Dự toán chi phí được tính toán dựa trên toàn bộ các nhánh rẽ của workflow (kể cả retry và ngoại lệ), không lấy mẫu từ một request đơn lẻ.
- ☐ Dữ liệu đối soát chi phí được ghi nhận trực tiếp từ trường
usagehoặcusage_metadatatrả về trong response API. - ☐ Đã cấu hình cơ chế prompt caching cho các phần system prompt và tài liệu cố định có kích thước lớn.
- ☐ Có ngưỡng giới hạn số lần retry tối đa cho mỗi tác vụ và có cơ chế sửa lỗi cú pháp cục bộ trước khi gọi lại API.
- ☐ Đã kích hoạt hạn mức ngân sách cứng (hard cap) và hệ thống cảnh báo chi tiêu tự động trên tài khoản nhà cung cấp.
Tài liệu tham khảo
- Google Cloud Vertex AI Documentation - Token counting, Usage metadata and Cost optimization strategies.
- OpenAI Platform Documentation - Managing costs and Token usage in Chat Completions API.
- Anthropic Claude Documentation - Prompt Caching: Reducing costs and latency for long contexts.