"Viết giúp tôi một thông báo bảo trì chuyên nghiệp dựa trên nội dung dưới đây."
Một kỹ sư nhập dòng lệnh quen thuộc vào cửa sổ chat. Kèm theo đó là ba dòng ghi chú ngắn: hệ thống đơn hàng sẽ bảo trì tối ngày 18/10 từ 22:00 đến 23:30; người dùng có thể gặp gián đoạn truy cập; thông tin cập nhật sẽ đưa lên trang trạng thái.
Chỉ vài giây sau, mô hình AI trả về một bản thông báo mạch lạc và trau chuốt. Bản nháp giải thích rằng hệ thống được "nâng cấp hạ tầng định kỳ nhằm tối ưu hóa hiệu năng", tự động quy đổi khung giờ sang định dạng UTC, và khẳng định chắc nịch rằng "toàn bộ dữ liệu của quý khách được bảo toàn tuyệt đối".
Về mặt hành văn, thông báo nghe rất êm tai. Nhưng về mặt vận hành, ba chi tiết vừa xuất hiện lại là ba rủi ro nghiêm trọng:
- Đợt bảo trì này nhằm vá lỗ hổng khẩn cấp của database, hoàn toàn không phải "nâng cấp định kỳ".
- Người dùng mục tiêu đều ở Việt Nam, việc đưa giờ UTC vào chỉ gây thêm hiểu lầm.
- Không ai dám cam đoan 100% dữ liệu an toàn khi chưa hoàn tất script migration.
Từ "chuyên nghiệp" mô tả cảm xúc mà người viết mong muốn, nhưng nó không cung cấp bất kỳ ranh giới kỹ thuật nào cho mô hình suy luận. AI không biết đâu là nguồn thông tin gốc bắt buộc phải tuân thủ, dữ kiện nào được phép diễn đạt lại và chi tiết nào tuyệt đối không được tự ý suy đoán.
Một yêu cầu hiệu quả không nhất thiết phải dài dòng. Giá trị của một câu lệnh nằm ở việc thiết lập được ranh giới rõ ràng: khi đọc kết quả đầu ra, bạn có thể chỉ tay vào từng câu và biết chính xác câu đó lấy từ dòng dữ liệu nào trong tài liệu gốc.
Ngừng kỳ vọng vào các khẩu hiệu chung chung trong prompt
Khi nhận một chỉ đạo mơ hồ, con người có phản xạ tự nhiên là hỏi lại để làm rõ: Đối tượng nhận thông báo là ai? Mức độ gián đoạn ra sao? Có được phép tiết lộ nguyên nhân kỹ thuật không?
Ngược lại, mô hình ngôn ngữ lớn (LLM) được tối ưu hóa để dự đoán từ tiếp theo sao cho câu văn liền mạch và tự nhiên nhất. Khi gặp một khoảng trống dữ liệu, thay vì dừng lại đặt câu hỏi, mô hình sẽ tự động điền vào các chi tiết mang tính xác suất cao mà nó đã học từ hàng triệu văn bản tương tự trên internet. Khả năng hành văn trôi chảy khiến các thông tin suy đoán này hòa lẫn hoàn hảo vào dữ kiện thật, khiến người duyệt rất dễ bỏ sót sai lệch.
Phản xạ sửa sai phổ biến của nhiều người là chèn thêm các khẩu hiệu vào prompt: "Hãy viết thật chính xác", "Tuyệt đối không được bịa đặt", hoặc "Chỉ sử dụng dữ liệu có sẵn".
Những câu nhắc này hầu như vô tác dụng trong môi trường thực tế. "Chính xác" so với cái gì? Nếu ghi chú chỉ ghi "ngày 18/10" mà không có năm, AI nên lấy năm hiện tại hay từ chối trả lời? Nếu hai tài liệu nội bộ ghi hai mốc thời gian khác nhau, mô hình phải ưu tiên nguồn nào?
Thay vì nhắc nhở mô hình bằng ngôn từ cảm tính, bạn phải chuyển các kỳ vọng của mình thành những ràng buộc kỹ thuật có thể kiểm chứng được:
- Nguồn dữ liệu nào là chân lý duy nhất (Single Source of Truth)?
- Những thông tin nào chưa rõ thì phải giữ nguyên hoặc đánh dấu nghi vấn?
- Cấu trúc đầu ra bắt buộc phải có những trường dữ liệu nào?
Tài liệu hướng dẫn thiết kế prompt của Google Cloud Prompt Engineering Strategies nhấn mạnh việc tách bạch rõ ràng giữa mục tiêu, ngữ cảnh, ràng buộc và định dạng phản hồi. Một yêu cầu rõ ràng giúp kỹ sư không phải căng thẳng đoán định xem AI có vừa "sáng tạo" thêm chi tiết nào ngoài luồng hay không.
Tránh nhồi nhét tài liệu không chọn lọc vào ngữ cảnh
Sau khi nhận thấy AI tự ý suy diễn thông tin, một phản xạ tự nhiên khác là gom toàn bộ tài liệu hiện có và thả vào cửa sổ chat: kế hoạch bảo trì, biên bản họp tuần trước, ticket Jira và vài mẫu thông báo cũ. Nhiều người tin rằng cung cấp càng nhiều chữ thì AI sẽ càng hiểu sâu.
Thực tế hoàn toàn ngược lại. Việc nhồi nhét ngữ cảnh hỗn loạn làm loãng sự chú ý của mô hình và gia tăng nguy cơ mâu thuẫn dữ liệu:
- Biên bản họp từ tuần trước ghi khung giờ dự kiến từ 20:00 đến 22:00.
- Ticket Jira cập nhật sát giờ lại chốt dời lịch sang 22:00 đến 23:30.
- Một mẫu thông báo cũ năm ngoái dùng cụm từ "dịch vụ không bị gián đoạn", trong khi đợt bảo trì này chắc chắn làm rớt kết nối database hai lần.
Nếu bạn không phân định thứ bậc ưu tiên giữa các tài liệu, mô hình có thể tự do cắt ghép các mẩu thông tin rời rạc từ các nguồn mâu thuẫn để tạo ra một bản nháp nghe rất hợp lý nhưng hoàn toàn sai lệch thực tế.
Ngữ cảnh hữu ích là phần thông tin tối thiểu và chính xác nhất mà mô hình cần để hoàn thành đúng nhiệm vụ. Với thông báo bảo trì, bạn chỉ cần trích xuất các dữ kiện đã chốt: khung giờ chính thức, dịch vụ bị ảnh hưởng trực tiếp, hành vi người dùng cần lưu ý và kênh tiếp nhận hỗ trợ. Toàn bộ các tranh luận nội bộ về nguyên nhân kỹ thuật hoặc phân bổ nhân sự trực đêm cần được loại bỏ khỏi prompt.
Đồng thời, dữ liệu đưa vào cần được phân tách thành các khối có định danh rõ ràng:
[NGUỒN A — Lịch bảo trì chính thức từ ticket OPS-4102]
- Khung giờ: 22:00 đến 23:30 ngày 18/10/2026 (Giờ Việt Nam - GMT+7).
- Hệ thống tác động: Cổng thanh toán và dịch vụ tra cứu đơn hàng.

[NGUỒN B — Đánh giá mức độ ảnh hưởng của Lead Kỹ thuật]
- Dự kiến có 2 đợt ngắt kết nối ngắn, mỗi đợt kéo dài khoảng 3-5 phút.
- Khách hàng đang thao tác dở đơn hàng có thể phải tải lại trang.

[NGUỒN C — Kênh điều phối]
- Kênh theo dõi tiến độ thời gian thực: status.example.com
Việc gắn thẻ định danh [NGUỒN A], [NGUỒN B] giúp tạo ra một dấu vết kiểm chứng rõ ràng (audit trail). Khi đọc bản thảo do AI viết, kỹ sư có thể lập tức đối chiếu: câu này được trích từ nguồn nào? Nếu có một câu khẳng định nào không trỏ được về một trong ba nguồn trên, câu đó lập tức bị xếp vào diện nghi vấn và cần loại bỏ.
Thiết lập ranh giới đóng kín cho vùng suy luận
Để triệt tiêu thói quen tự suy đoán của mô hình, bạn cần áp dụng kỹ thuật đóng khung nguồn (Source Framing). Kỹ thuật này buộc mô hình phải coi đoạn văn bản được cung cấp là phạm vi hiểu biết duy nhất của nó cho tác vụ hiện tại, chặn đứng việc lôi kéo kiến thức chung từ internet vào văn bản vận hành.
Ba quy tắc ràng buộc cốt lõi cần đưa thẳng vào prompt:
- Ràng buộc phạm vi sự thật (Closed-domain constraint): Yêu cầu mô hình chỉ sử dụng thông tin có mặt tường minh trong các nguồn dữ liệu được cung cấp. Cấm suy diễn thêm các chi tiết bổ trợ như mục đích nâng cấp hạ tầng, cam kết bồi thường, hoặc tối ưu hóa tốc độ.
- Quy tắc xử lý khoảng trống dữ liệu (Missing data handling): Chỉ định rõ hành vi khi thiếu thông tin. Ví dụ: "Nếu tài liệu không nêu rõ nguyên nhân bảo trì, tuyệt đối không tự bịa lý do; hãy để trống hoặc ghi chú [Cần kỹ thuật bổ sung nguyên nhân]".
- Quy tắc trích dẫn nguồn cho từng luận điểm (Attribution): Yêu cầu mô hình sau mỗi đoạn văn hoặc mỗi thông số kỹ thuật phải ghi chú rõ dữ kiện đó được lấy từ nguồn nào (ví dụ:
(Nguồn A)).
Khi được đặt trong một khuôn khổ khép kín, mô hình ngôn ngữ sẽ chuyển từ trạng thái "sáng tác tự do" sang vai trò của một công cụ tổng hợp và định dạng dữ liệu có kiểm soát.
Ép khuôn định dạng đầu ra để tăng tốc độ đối chiếu
Khi bạn yêu cầu AI viết một đoạn văn bản tự do, các dữ kiện kỹ thuật (thời gian, cổng mạng, tên service, phiên bản phần mềm) sẽ bị phân tán rải rác khắp các câu văn. Để phát hiện một lỗi sai về khung giờ, người duyệt buộc phải đọc từng chữ từ đầu đến cuối đoạn văn. Nếu mỗi ngày phải duyệt hàng chục tài liệu, việc rà soát thủ công này sẽ làm giảm đáng kể sự tập trung và dễ để lọt lỗi.
Giải pháp là buộc mô hình tuân thủ một cấu trúc đầu ra có phân vùng rõ ràng. Thay vì trả về một khối văn bản liền mạch, hãy yêu cầu AI chia kết quả thành hai phần riêng biệt:
- Bảng tóm lược dữ kiện kỹ thuật (Fact Sheet): Liệt kê độc lập các tham số then chốt (thời gian bắt đầu, thời gian kết thúc, dịch vụ ảnh hưởng, hành động của người dùng). Kỹ sư chỉ cần lướt qua bảng này trong 5 giây là có thể đối chiếu ngay với ticket kỹ thuật gốc.
- Nội dung văn bản hoàn chỉnh: Đoạn thông báo hoàn chỉnh được biên soạn dựa trên chính các thông số đã liệt kê ở bảng trên.
### Mẫu yêu cầu cấu trúc đầu ra có thể kiểm tra

Đầu ra của bạn BẮT BUỘC phải tuân thủ định dạng Markdown sau:

## 1. BẢNG THÔNG SỐ XÁC MINH
- Thời gian thực hiện: [Trích nguyên văn từ Nguồn A]
- Mức độ ảnh hưởng: [Trích nguyên văn từ Nguồn B]
- Kênh cập nhật: [Trích nguyên văn từ Nguồn C]
- Thông tin còn thiếu: [Ghi rõ nếu nguồn chưa cung cấp]

## 2. NỘI DUNG THÔNG BÁO CHO NGƯỜI DÙNG
[Soạn thông báo ngắn gọn, sử dụng chính xác các thông số từ bảng trên, không bổ sung bất kỳ thông tin nào khác]
Việc phân tách này đem lại hai lợi ích lớn:
- Hạn chế ảo giác của mô hình: Khi bị ép phải điền vào bảng thông số trước, mô hình buộc phải thực hiện bước trích xuất dữ liệu thô trước khi bước vào giai đoạn hành văn. Quá trình này giúp mô hình "bám chặt" vào dữ liệu nguồn hơn.
- Tối ưu hóa thời gian rà soát: Người duyệt chỉ cần kiểm tra tính chính xác của bảng thông số. Nếu bảng thông số sai, người duyệt có thể từ chối ngay lập tức mà không cần mất thời gian đọc hết phần văn bản phía sau.
Yêu cầu mô hình tự đối chiếu các dữ kiện đã sử dụng
Một kỹ thuật nâng cao nhưng cực kỳ hiệu quả khi giao việc cho AI là yêu cầu mô hình tự lập một bảng đối chiếu giữa các câu khẳng định trong bài viết với nguồn dữ liệu gốc (Claim-to-source mapping).
Thay vì để mô hình viết xong rồi con người tự đi tìm xem câu đó lấy từ đâu, bạn đưa thêm chỉ dẫn sau vào prompt:
"Sau khi viết xong bản nháp thông báo, hãy lập một bảng gồm 3 cột: (1) Câu khẳng định trong bài, (2) Nguồn dữ liệu tương ứng (A, B hoặc C), (3) Đánh dấu [Tự suy luận] nếu câu đó không có trong nguồn."
Khi bị đặt vào thế phải chỉ ra nguồn gốc của từng câu chữ, mô hình AI sẽ tự động kích hoạt cơ chế tự kiểm tra (self-reflection). Trong rất nhiều trường hợp, việc yêu cầu trích dẫn nguồn sẽ ngăn chặn mô hình đưa ra những câu khẳng định vô căn cứ như "dữ liệu an toàn 100%" hay "hệ thống được nâng cấp định kỳ", bởi vì nó nhận thức được rằng nó không thể tìm thấy thẻ nguồn nào để gán cho các câu văn đó.
Nếu mô hình vẫn tự ý suy luận, bảng đối chiếu này sẽ phơi bày rõ ràng các câu văn mang nhãn [Tự suy luận]. Nhờ đó, kỹ sư vận hành có thể phát hiện và loại bỏ các chi tiết thêm thắt chỉ bằng một cái liếc mắt, biến công việc kiểm duyệt từ một nhiệm vụ mơ hồ thành một quy trình kiểm tra đối chiếu cơ học và chuẩn xác.
Áp dụng cấu trúc hoàn chỉnh cho bài toán thông báo bảo trì
Để thấy rõ sự khác biệt giữa một câu lệnh cảm tính và một câu lệnh có thể kiểm chứng, hãy đặt bản prompt ban đầu cạnh bản prompt đã được tái cấu trúc:
### Bản prompt hoàn chỉnh sau khi chuẩn hóa

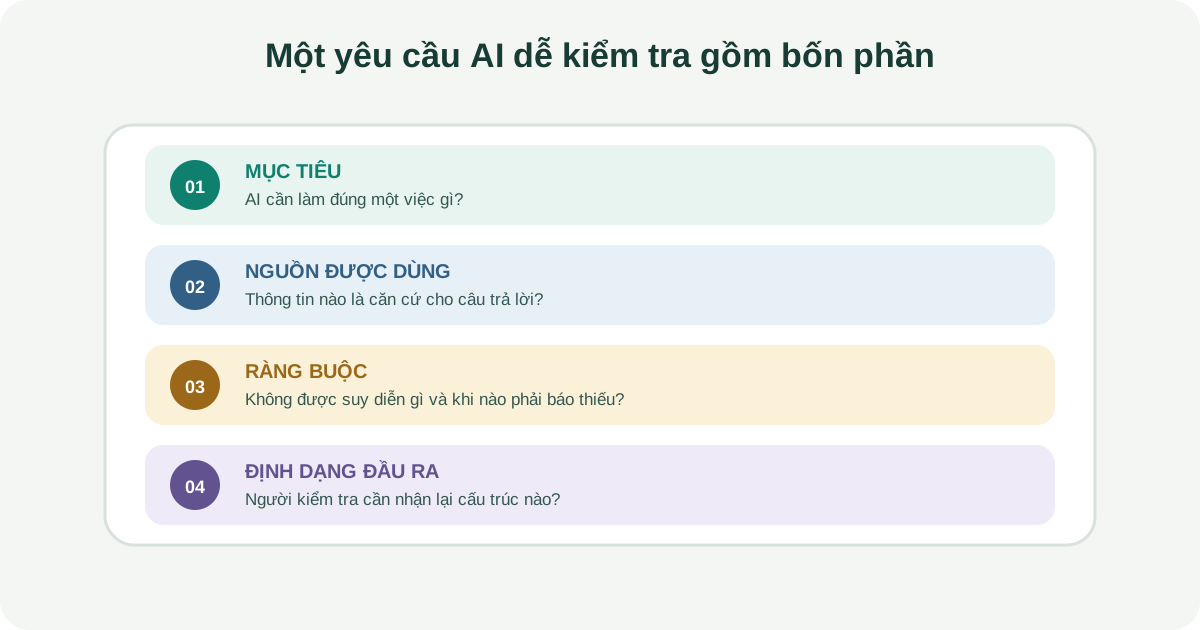
**1. Mục tiêu:** Soạn một thông báo bảo trì hệ thống ngắn gọn (dưới 150 từ) để gửi cho khách hàng tại Việt Nam qua email.

**2. Dữ liệu nguồn:**
[NGUỒN A — Lịch bảo trì]
- Khung giờ: 22:00 đến 23:30 ngày 18/10/2026 (Giờ Việt Nam).
- Dịch vụ ảnh hưởng: Quản lý đơn hàng.

[NGUỒN B — Mức độ gián đoạn]
- Dự kiến có thể gián đoạn truy cập trong khung giờ trên.
- Khách hàng không thể tạo đơn hàng mới trong lúc bảo trì.

[NGUỒN C — Kênh theo dõi]
- Tiến độ cập nhật tại: status.example.com.

**3. Ràng buộc kỹ thuật:**
- CHỈ sử dụng dữ liệu trong Nguồn A, B, C. Tuyệt đối không tự suy diễn lý do bảo trì (như "nâng cấp hạ tầng", "tối ưu hiệu năng").
- Không đưa ra cam kết về việc dữ liệu có an toàn hay không vì nguồn chưa đề cập.
- Giữ nguyên múi giờ Việt Nam, không tự ý quy đổi sang UTC.

**4. Định dạng phản hồi:**
- Bảng thông số: Khung giờ, Dịch vụ tác động, Kênh hỗ trợ.
- Nội dung email: Đoạn văn ngắn gọn, rõ ràng, văn phong lịch sự.
Với bản prompt này, kết quả AI trả về sẽ khác biệt hoàn toàn:
BẢNG THÔNG SỐ XÁC MINH:
- Khung giờ: 22:00 – 23:30 ngày 18/10/2026 (Giờ Việt Nam)
- Dịch vụ tác động: Hệ thống Quản lý đơn hàng
- Kênh cập nhật: status.example.com

NỘI DUNG THÔNG BÁO:
Kính gửi Quý khách hàng,

Hệ thống Quản lý đơn hàng sẽ bước vào khung giờ bảo trì từ 22:00 đến 23:30 ngày 18/10/2026 (Giờ Việt Nam). Trong khoảng thời gian này, quý khách tạm thời không thể tạo mới hoặc cập nhật đơn hàng.

Tiến độ bảo trì sẽ được cập nhật liên tục tại status.example.com. Đội ngũ kỹ thuật sẽ nỗ lực hoàn tất công việc sớm nhất để khôi phục dịch vụ ổn định.

Trân trọng,
Đội ngũ Vận hành Hệ thống
Bản thông báo này ngắn gọn, đi thẳng vào vấn đề, và quan trọng nhất: không chứa bất kỳ một chi tiết tự bịa nào. Toàn bộ các thông số về thời gian, dịch vụ tác động và đường dẫn đều có thể đối chiếu ngược lại 100% với dữ liệu nguồn.
Checklist kiểm tra yêu cầu trước khi gửi cho AI
Trước khi bấm gửi prompt cho mô hình, hãy dành 30 giây rà soát nhanh 5 câu hỏi cốt lõi sau:
- ☐ Mục tiêu có đo lường được không? Đã xác định rõ đối tượng tiếp nhận văn bản, độ dài ước tính và ngữ cảnh sử dụng chưa?
- ☐ Ngữ cảnh có được chắt lọc không? Đã loại bỏ các tài liệu cũ, thông tin mâu thuẫn hoặc biên bản nội bộ không liên quan chưa?
- ☐ Các nguồn dữ liệu đã được đánh nhãn chưa? Đã phân tách rõ [NGUỒN A], [NGUỒN B] để làm căn cứ đối chiếu chưa?
- ☐ Đã có quy tắc xử lý khi thiếu thông tin chưa? Đã yêu cầu AI để trống hoặc báo thiếu thay vì tự ý suy diễn chưa?
- ☐ Định dạng đầu ra có phân tách rõ ràng không? Đã ép mô hình xuất bảng thông số trước khi viết văn bản tự do chưa?
Tài liệu tham khảo
- Google Cloud Architecture Center (2025) - Prompt Design Strategies for Generative AI.
- OpenAI Documentation - Best Practices for Prompt Engineering with LLMs.
- Anthropic Claude Documentation - Use XML tags and source grounding to reduce hallucinations.