Khi vận hành ứng dụng trên kiến trúc nhiều cụm máy chủ hoặc đa đám mây theo mô hình máy chủ dự phòng Warm-Standby, rủi ro lớn nhất không nằm ở việc cụm dự phòng chưa sẵn sàng, mà nằm ở thời gian chuyển hướng người dùng khi Data Center chính gặp sự cố đột ngột.
Nếu việc chuyển hướng lưu lượng vẫn phụ thuộc vào thao tác thủ công—kỹ sư nhận cuộc gọi cảnh báo lúc nửa đêm, mở máy tính đăng nhập vào bảng điều khiển tên miền rồi sửa địa chỉ IP bản ghi A—hệ thống thường đã gián đoạn từ 30 phút đến hàng tiếng đồng hồ. Thậm chí, ngay cả khi IP đã được đổi thành công, phần lớn người dùng vẫn tiếp tục bị kẹt lại ở cụm máy chủ chết do bộ nhớ đệm DNS (caching) tại các nhà mạng (ISP) chưa hết hạn.
Bài viết này hướng dẫn bạn xây dựng kịch bản chuyển vùng DNS tự động (Automated DNS Failover) tại tầng Anycast Edge. Cơ chế này tự động phát hiện sự cố diện rộng tại Data Center thông qua các điểm kiểm tra phân tán, tự động điều hướng lưu lượng sang cụm máy chủ dự phòng trong vòng 1 đến 2 phút, đồng thời kiểm soát triệt để hiện tượng nhấp nháy mạng (flapping) để tránh nguy cơ chia cắt dữ liệu (Split-Brain).
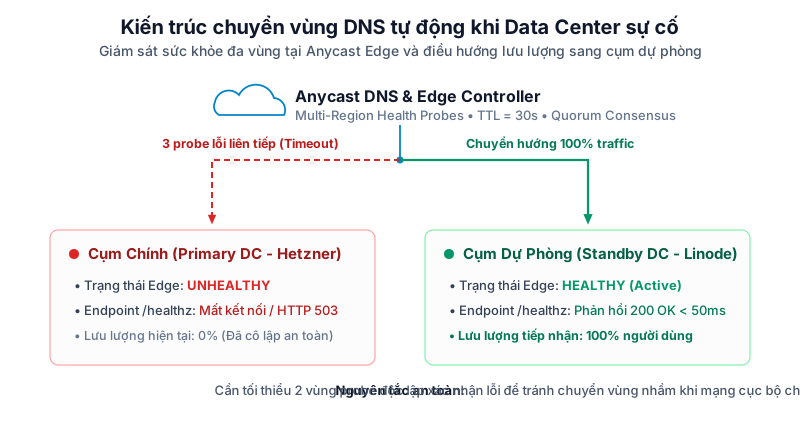
Giới hạn của việc đổi DNS thủ công khi xảy ra sự cố
Trong các bài toán phục hồi sau thảm họa, việc thay đổi bản ghi DNS thủ công bộc lộ hai rào cản kỹ thuật nghiêm trọng:
1. Độ trễ thao tác của con người (MTTR quá dài)
Một sự cố Data Center (như cháy trạm biến áp, mất điện lưới hoặc đứt tuyến cáp quang ngầm) thường diễn ra bất ngờ. Quy trình xử lý thủ công phải trải qua các bước:
- Hệ thống giám sát gửi cảnh báo qua Telegram/Slack hoặc cuộc gọi tự động.
- Kỹ sư tiếp nhận, xác nhận đây là sự cố sập Data Center thật sự chứ không phải lỗi mạng cá nhân.
- Đăng nhập vào nhà cung cấp DNS, tìm bản ghi và cập nhật sang địa chỉ IP của cụm dự phòng.
Chuỗi thao tác này hiếm khi hoàn tất dưới 20-30 phút, khiến chỉ số thời gian phục hồi (RTO) bị kéo dài ngoài tầm kiểm soát của doanh nghiệp.
2. Cạm bẫy bộ nhớ đệm và thời gian sống (TTL)
Ngay cả khi bạn cập nhật IP mới trên hệ thống DNS có thẩm quyền (Authoritative DNS), các máy chủ phân giải đệm (Recursive Resolver) của các nhà mạng viễn thông như VNPT, Viettel hay FPT vẫn sẽ phục vụ địa chỉ IP cũ cho người dùng cho đến khi giá trị thời gian sống (TTL - Time To Live) của bản ghi hết hạn.
Nếu bản ghi của bạn đang để giá trị TTL mặc định là 3600 giây (1 giờ) hoặc 86400 giây (1 ngày), người dùng sẽ tiếp tục truy cập vào địa chỉ IP chết trong suốt khoảng thời gian đó. Do đó, để chuyển vùng tự động hiệu quả, hạ tầng DNS bắt buộc phải hỗ trợ giá trị TTL ngắn kết hợp với tính năng giám sát chủ động tại tầng mạng Anycast Edge.
Cơ chế giám sát và điều hướng lưu lượng tại Anycast Edge
Hạ tầng DNS hiện đại (như Cloudflare Load Balancing, AWS Route 53 Application Recovery Controller hoặc NS1) không chỉ làm nhiệm vụ dịch tên miền thành địa chỉ IP, mà còn đóng vai trò là một bộ điều phối lưu lượng thông minh đặt tại hàng trăm trung tâm dữ liệu Anycast trên toàn cầu.
1. Giám sát đa vùng địa lý (Multi-Region Probes)
Để tránh trường hợp chuyển vùng nhầm khi chỉ có đường truyền mạng từ một khu vực cụ thể bị nghẽn, hệ thống Anycast Edge gửi các gói tin kiểm tra sức khỏe (Health Check Probes) từ nhiều vị trí độc lập trên thế giới:
- Khu vực Đông Nam Á (Singapore / Tokyo).
- Khu vực Bắc Mỹ (San Jose / Ashburn).
- Khu vực Châu Âu (Frankfurt / London).
Chỉ khi đa số các trạm kiểm tra (Quorum Consensus, ví dụ 2/3 vùng) cùng ghi nhận cụm chính không phản hồi đúng chuẩn, hệ thống Edge mới ra quyết định đánh dấu cụm đó là suy giảm sức khỏe (Unhealthy).
2. Chuyển mạch lưu lượng tức thời tại tầng Proxy
Nếu tên miền được đặt sau lớp proxy bảo vệ của Cloudflare (chế độ bật đám mây màu cam / Proxied), việc chuyển vùng diễn ra trực tiếp tại các node biên Anycast Edge mà không cần chờ xóa bộ nhớ đệm DNS của người dùng cuối. Edge Server sẽ lập tức chuyển tiếp các kết nối HTTP/HTTPS mới sang địa chỉ IP của cụm dự phòng, giúp thời gian gián đoạn thực tế giảm xuống chỉ còn tương đương chu kỳ phát hiện lỗi của Health Check.
Thiết kế endpoint kiểm tra trạng thái ứng dụng (/healthz)
Một sai lầm rất phổ biến khi cấu hình Health Check là chỉ kiểm tra cổng 80/443 (TCP Ping) hoặc kiểm tra trang chủ (/):
- TCP Check cổng 443: Nginx Load Balancer vẫn phản hồi bắt tay TLS bình thường ngay cả khi toàn bộ container ứng dụng phía sau bị quá tải hoặc database bị treo.
- HTTP Check trang chủ
/: Trang chủ thường được lưu cache tại Nginx FastCGI cache hoặc CDN, khiến probe luôn nhận mãHTTP 200giả tạo dù ứng dụng thực tế đã mất khả năng xử lý nghiệp vụ.
Bạn cần thiết lập một endpoint chuyên dụng /healthz phản ánh trung thực trạng thái của toàn bộ ngăn xếp dịch vụ:
1. Logic kiểm tra bên trong ứng dụng
Endpoint /healthz phải thực hiện lần lượt các kiểm tra nhanh sau đây:
- Kiểm tra truy vấn đọc nhẹ vào cơ sở dữ liệu chính:
SELECT 1;. - Kiểm tra kết nối tới bộ nhớ đệm Redis: gửi lệnh
PINGvà nhận phản hồiPONG. - Kiểm tra dung lượng ổ đĩa còn trống: từ chối nếu ổ đĩa ghi dữ liệu vượt ngưỡng 95%.
Nếu toàn bộ thành phần đều sẵn sàng, ứng dụng trả về mã HTTP 200 OK kèm chuỗi JSON {"status": "healthy"}. Nếu bất kỳ dịch vụ phụ thuộc nào bị ngắt quãng, trả về ngay mã HTTP 503 Service Unavailable.
2. Cấu hình bảo vệ endpoint tại Nginx
Endpoint kiểm tra sức khỏe cần được cấu hình không lưu cache và giới hạn quyền truy cập chỉ cho phép các IP của hệ thống Health Check:
# Cấu hình location /healthz trên Nginx Load Balancer
location = /healthz {
    # Cấm hoàn toàn mọi cơ chế cache
    add_header Cache-Control "no-store, no-cache, must-revalidate, proxy-revalidate" always;
    add_header Pragma "no-cache" always;

    # Chuyển tiếp truy vấn vào backend ứng dụng
    proxy_pass http://app_upstream/healthz;
    proxy_connect_timeout 2s;
    proxy_read_timeout 3s;

    # Chỉ cho phép dải IP của Cloudflare Health Check hoặc probe nội bộ
    # allow 173.245.48.0/20;
    # allow 103.21.244.0/22;
    # deny all;
}
Cấu hình chính sách kiểm tra sức khỏe và nhóm máy chủ
Để hệ thống chuyển vùng hoạt động chính xác, bạn cần cấu hình 3 thành phần chính trên bảng điều khiển DNS/Load Balancing:
1. Hồ sơ Health Check (Monitor Profile)
- Đường dẫn kiểm tra (Path):
/healthz - Giao thức (Protocol):
HTTPS(cổng 443) - Mã phản hồi mong đợi (Expected Code):
200 - Chu kỳ kiểm tra (Interval):
60giây (với các hệ thống yêu cầu phục hồi nhanh hơn, có thể cấu hình30giây). - Thời gian chờ phản hồi tối đa (Timeout):
5giây. Nếu quá 5 giây không nhận được byte đầu tiên, probe tính là 1 lần thất bại. - Số lần thất bại liên tiếp (Consecutive Failures):
3lần. - Số vùng kiểm tra (Probe Regions): Tối thiểu 3 khu vực địa lý độc lập.
2. Cấu hình nhóm máy chủ (Pools)
Bạn phân chia hạ tầng thành hai nhóm máy chủ riêng biệt:
- Primary Pool (Cụm máy chủ chính - Hetzner):
- Địa chỉ IP nguồn: IP công khai của Nginx Load Balancer tại cụm chính.
- Trọng số phân phối (Weight):
100. - Ngưỡng sức khỏe (Healthy Threshold):
1. Khi node này khỏe mạnh, nó sẽ đảm nhận toàn bộ lưu lượng. - Secondary Pool (Cụm máy chủ dự phòng - Linode):
- Địa chỉ IP nguồn: IP công khai của Nginx Load Balancer tại cụm dự phòng Warm-Standby.
- Trọng số phân phối (Weight):
0trong điều kiện vận hành bình thường.
3. Chính sách điều hướng lưu lượng (Steering Policy)
Thiết lập chính sách điều hướng ở chế độ Off-Premises Fallback / Failover:
- Quy tắc mặc định: Định tuyến 100% người dùng vào
Primary Pool. - Quy tắc chuyển vùng: Khi
Primary Poolbị Edge đánh dấu làUnhealthy, toàn bộ lưu lượng được tự động chuyển sangSecondary Pool. - Thời gian TTL của bản ghi DNS: Cấu hình giá trị từ 30 đến 60 giây.
Phân tích chuỗi trễ và phòng ngừa hiện tượng nhấp nháy mạng (Flapping)
Một trong những bài toán hóc búa nhất khi vận hành hệ thống chuyển vùng tự động là kiểm soát hiện tượng nhấp nháy mạng (Network Flapping).
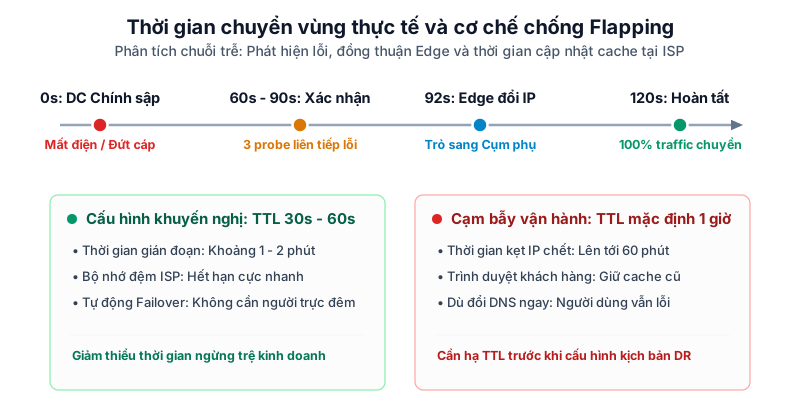
1. Phân rã thời gian chuyển vùng thực tế
Thời gian gián đoạn dịch vụ thực tế từ lúc sự cố xảy ra đến khi lưu lượng được điều hướng hoàn toàn sang cụm dự phòng được tính bằng tổng của ba giai đoạn:
- Giai đoạn phát hiện lỗi (Detection Window): Với chu kỳ kiểm tra 30 giây và ngưỡng xác nhận 3 lần liên tiếp, thời gian phát hiện dao động từ 60s đến 90s.
- Giai đoạn đồng thuận và chuyển bản ghi (Decision Window): Hệ thống Anycast Edge mất khoảng 2s - 5s để đồng thuận trạng thái giữa các trạm kiểm tra và cập nhật bảng định tuyến nội bộ.
- Giai đoạn lan truyền DNS (Propagation Window): Với TTL = 30s, các máy chủ phân giải trung gian của ISP sẽ lần lượt hết hạn cache và trỏ người dùng sang IP cụm dự phòng trong vòng 30s.
Tổng thời gian chuyển vùng thực tế thường rơi vào khoảng 1.5 đến 2 phút. Đây là mức độ sẵn sàng rất tốt cho các hệ thống quy mô vừa và nhỏ mà không cần đầu tư chi phí hạ tầng mạng BGP Anycast đắt đỏ.
2. Nguy cơ chia cắt hệ thống (Split-Brain) do nhấp nháy mạng
Khi Data Center chính gặp sự cố chập chờn (mạng bị ngắt 1 phút, có lại 30 giây rồi lại ngắt tiếp), nếu hệ thống Health Check chuyển vùng quay ngược trở lại cụm chính quá vội vàng:
- Lưu lượng người dùng bị giật qua lại liên tục giữa hai cụm, làm rớt session đăng nhập của khách hàng.
- Hai cụm máy chủ cùng nhận các truy vấn ghi cơ sở dữ liệu song song trong khi đường truyền đồng bộ giữa hai bên bị gián đoạn. Đây là nguyên nhân dẫn đến hiện tượng Split-Brain (xung đột dữ liệu hai chiều), khiến dữ liệu bị phân mảnh và cực kỳ khó khắc phục.
3. Thiết lập ngưỡng phục hồi an toàn (Pass Threshold)
Để loại bỏ triệt để hiện tượng nhấp nháy mạng:
- Cấu hình số lần kiểm tra thành công liên tiếp (Consecutive Passes): Yêu cầu tối thiểu từ
5đến10lần probe thành công liên tiếp (tương đương 5 đến 10 phút mạng ổn định liên tục) thì mới cho phép cụm chính chuyển trạng thái từ Unhealthy sang Healthy. - Khóa chuyển vùng tự động ngược (Manual Failback): Đối với các hệ thống có cơ sở dữ liệu phức tạp, khuyến nghị tối ưu là: Tự động chuyển vùng sang cụm phụ khi có sự cố, nhưng bắt buộc người vận hành xác nhận thủ công khi chuyển trả lưu lượng về cụm chính.
Quy trình chuyển trả lưu lượng có kiểm soát (Safe Failback Runbook)
Khi Data Center chính đã hoàn toàn khắc phục sự cố phần cứng hoặc mạng lưới, bạn không nên vội vàng trỏ lại DNS ngay lập tức. Hãy thực hiện quy trình phục hồi theo đúng thứ tự an toàn sau:
Bước 1: Kiểm tra kết nối mạng riêng WireGuard
Xác nhận đường hầm mạng riêng WireGuard giữa hai cụm máy chủ đã thông suốt để đảm bảo dữ liệu có thể truyền ngầm an toàn giữa hai bên:
# Kiểm tra kết nối ping qua IP mạng riêng nội bộ
ping -c 4 10.100.0.1
Bước 2: Tạm dừng quyền ghi trên cụm dự phòng
Để tránh việc người dùng tiếp tục tạo ra các đơn hàng hoặc dữ liệu mới trên cụm phụ trong lúc đang đồng bộ ngược:
-- Khóa ghi an toàn trên cụm dự phòng
SET GLOBAL super_read_only = ON;
Bước 3: Đồng bộ dữ liệu chênh lệch ngược về cụm chính
Sử dụng công cụ nhân bản hoặc nạp lại các binlog ghi nhận sự thay đổi trên cụm dự phòng trong thời gian diễn ra sự cố ngược trở về database của cụm chính. Đảm bảo độ trễ dữ liệu giữa hai cụm đã về mức 0 (Seconds_Behind_Master = 0).
Bước 4: Mở quyền ghi trên cụm chính và chuyển bản ghi DNS
- Bật lại quyền nhận ghi trên cơ sở dữ liệu của cụm chính:
SET GLOBAL read_only = OFF;- Trên bảng điều khiển Edge DNS, kích hoạt lại
Primary Poolđể hệ thống bắt đầu phân phối lại lưu lượng cho người dùng.
Bước 5: Theo dõi nhật ký lỗi
Duy trì theo dõi nhật ký truy cập Nginx và biểu đồ tải của cả hai cụm trong 30 phút sau khi hoàn tất chuyển vùng ngược để đảm bảo không có request nào bị thất lạc.
Các bước tiếp theo để hoàn thiện kế hoạch phục hồi thảm họa
Việc thiết lập cơ chế chuyển vùng DNS tự động kết hợp với hệ thống sao lưu chống Ransomware bằng S3 Object Lock (HTS-109) giúp hạ tầng của bạn đạt mức độ sẵn sàng cao trước các sự cố nghiêm trọng. Để đảm bảo toàn bộ hệ thống luôn vận hành trơn tru khi thảm họa thực tế xảy ra, bạn nên tiếp tục hoàn thiện các quy trình tiếp theo:
- Thực hành quy trình khẩn cấp định kỳ: Tổ chức các buổi mô phỏng sự cố thực tế theo kịch bản diễn tập phục hồi thảm họa cho đội ngũ kỹ thuật (
HTS-111) để đo lường chính xác thời gian phản ứng của con người và máy móc. - Kiểm toán độ sẵn sàng hạ tầng: Sử dụng checklist kiểm toán khả năng phục hồi sau thảm họa định kỳ (
HTS-112) nhằm rà soát chứng chỉ SSL, thời hạn khóa dữ liệu và trạng thái của các điểm kiểm tra DNS trước khi sự cố bất ngờ ập đến.