Khi doanh nghiệp phát triển và mở rộng hạ tầng từ một VPS đơn lẻ sang mô hình cụm phân tán Multi-Server, tính sẵn sàng của ứng dụng web được cải thiện rõ rệt nhờ việc phân tách máy chủ Web và máy chủ Database. Tuy nhiên, toàn bộ cụm máy chủ này thông thường vẫn được đặt tại cùng một trung tâm dữ liệu hoặc phụ thuộc vào hạ tầng của một nhà cung cấp dịch vụ đám mây duy nhất.
Nhiều đội ngũ kỹ thuật tin rằng chỉ cần thuê thêm một máy chủ ở vùng khác (khác Region hoặc khác Data Center) trong cùng một nhà cung cấp là đã đủ an toàn. Trên thực tế vận hành, các sự cố thảm họa nghiêm trọng hiếm khi dừng lại ở việc hỏng một thanh RAM hay sập một máy chủ ảo. Những rủi ro lớn nhất thường đến từ bên ngoài: hỏa hoạn thiêu rụi toàn bộ trung tâm dữ liệu, sự cố đứt nhiều tuyến cáp quang biển quốc tế cùng lúc, hoặc tài khoản quản trị đám mây bị tạm khóa đột ngột do lỗi thanh toán thẻ tín dụng. Trong các tình huống này, toàn bộ các Region của cùng một nhà cung cấp đều có thể bị gián đoạn đồng thời.
Bài viết này phân tích giải pháp thiết lập máy chủ dự phòng xuyên nhà cung cấp (Cross-Provider / Multi-Cloud Disaster Recovery) theo mô hình Warm-Standby. Chúng tôi sẽ cùng bạn xây dựng đường hầm mạng riêng ảo mã hóa bằng WireGuard để đồng bộ cơ sở dữ liệu liên tục, cấu hình cơ chế bảo vệ chống hiện tượng ghi nhầm dữ liệu hai đầu (Split-Brain), tối ưu chi phí duy trì máy chủ dự phòng ở mức tối thiểu, và thiết lập kịch bản chuyển vùng thảm họa (Failover Runbook) kèm quy trình đưa hệ thống trở lại máy chủ chính (Failback Runbook) an toàn mà không làm mất mát dữ liệu giao dịch.
Tại sao doanh nghiệp cần máy chủ dự phòng trên hai nhà cung cấp khác nhau?
Để đánh giá đúng mức độ cần thiết của việc đặt máy chủ dự phòng ở một nhà cung cấp khác, bạn cần nhìn nhận các sự cố thảm họa dưới góc độ vận hành thực tế tại Việt Nam và trên thế giới:
1. Thảm họa vật lý tại trung tâm dữ liệu
Trung tâm dữ liệu được thiết kế với nhiều lớp bảo vệ (máy phát điện diesel dự phòng, hệ thống chữa cháy khí trơ, đường cáp quang đa hướng). Tuy nhiên, rủi ro vật lý vẫn luôn tồn tại. Vụ hỏa hoạn tại khu phức hợp máy chủ OVH SBG2 ở Strasbourg (Pháp) năm 2021 là bài học kinh nghiệm điển hình cho toàn ngành công nghệ: hàng triệu website bị tê liệt, và nhiều doanh nghiệp mất trắng dữ liệu vì các bản sao lưu cũng được đặt trong cùng một tòa nhà trung tâm dữ liệu đó.
2. Sự cố đường truyền viễn thông diện rộng
Với các doanh nghiệp vận hành dịch vụ phục vụ người dùng trong nước nhưng đặt máy chủ chính tại nước ngoài (như Hetzner Đức/Phần Lan hoặc DigitalOcean Singapore), sự cố đứt đồng thời nhiều tuyến cáp quang biển quốc tế (AAG, APG, IA, AAE-1) có thể đẩy độ trễ truy cập lên hàng trăm mili-giây, kèm tỷ lệ rớt gói tin (packet loss) cao khiến người dùng trong nước hầu như không thể tải trang. Nếu có một máy chủ dự phòng đặt tại một nhà cung cấp điện toán đám mây nội địa hoặc khu vực lân cận, bạn có thể chủ động chuyển hướng lưu lượng truy cập để duy trì dịch vụ.
3. Rủi ro chính sách và cổng thanh toán đám mây
Đây là rủi ro phi kỹ thuật nhưng xảy ra rất phổ biến:
- Thẻ tín dụng quốc tế dùng để gia hạn dịch vụ tự động bị ngân hàng chặn do nghi ngờ gian lận, hoặc hạn mức thanh toán bị quá tải vào đầu tháng.
- Hệ thống phòng chống gian lận (Anti-Fraud) của các nhà cung cấp đám mây quốc tế quét nhầm tài khoản, dẫn đến việc tài khoản bị đình chỉ (Account Suspended) và toàn bộ tài nguyên bị đóng băng chỉ sau 24 đến 48 giờ.
- Bảng điều khiển quản trị (Control Plane) của nhà cung cấp gặp sự cố diện rộng khiến bạn không thể đăng nhập vào bảng điều khiển, không thể mở máy ảo mới và cũng không thể tải về các bản snapshot sao lưu.
Giới hạn của mô hình Multi-Region cùng nhà cung cấp
Khi thuê hai máy chủ ở hai Region khác nhau của cùng một hãng (chẳng hạn một máy ở Frankfurt và một máy ở Singapore):
- Bạn vẫn dùng chung một tài khoản quản trị và một phương thức thanh toán.
- Bạn vẫn chịu sự điều phối của cùng một hệ thống xác thực định danh (IAM / Single Sign-On của nhà cung cấp đó).
- Nếu tài khoản gặp sự cố chính sách hoặc hạ tầng mạng lõi toàn cầu của nhà cung cấp bị gián đoạn, cả hai Region đều chịu ảnh hưởng như nhau.
Chỉ khi đặt máy chủ dự phòng tại một nhà cung cấp hoàn toàn độc lập (ví dụ: Cụm chính tại Hetzner, Cụm dự phòng tại DigitalOcean hoặc Linode), bạn mới loại trừ được rủi ro phụ thuộc vào một nhà cung cấp duy nhất (Vendor Lock-in).
So sánh các mô hình phục hồi thảm họa: Cold, Warm và Hot-Standby
Trong kỹ thuật quản trị tính liên tục kinh doanh (Business Continuity), hai chỉ số quan trọng nhất quyết định thiết kế kiến trúc là:
- RTO (Recovery Time Objective): Thời gian tối đa cho phép hệ thống ngừng hoạt động trước khi được khôi phục.
- RPO (Recovery Point Objective): Mức độ mất mát dữ liệu tối đa chấp nhận được (tính bằng khoảng thời gian giữa dữ liệu được khôi phục và thời điểm xảy ra sự cố).
Bảng so sánh dưới đây phân tích sự đánh đổi giữa 3 mô hình dự phòng phổ biến:
| Tiêu chí | Cold Standby (Dự phòng nguội) | Warm Standby (Dự phòng ấm) | Hot-Hot / Active-Active (Dự phòng nóng hai chiều) |
|---|---|---|---|
| Bản chất hạ tầng | Không duy trì máy chủ chạy sẵn. Chỉ lưu file backup sang nhà cung cấp thứ hai. Khi có sự cố mới tạo VPS và bung dữ liệu. | Duy trì 1 máy chủ bật sẵn ở cấu hình tối thiểu, liên tục nhận luồng đồng bộ cơ sở dữ liệu ngầm; container ứng dụng ở trạng thái chờ. | Cả hai nhà cung cấp đều chạy cụm máy chủ đầy đủ, cùng phục vụ lưu lượng truy cập thực tế của người dùng đồng thời. |
| RTO (Thời gian khôi phục) | Rất lâu: 2 – 8 giờ (phụ thuộc thời gian tạo máy ảo, cài đặt môi trường và giải nén cơ sở dữ liệu lớn). | Nhanh: 5 – 15 phút (thăng cấp Database, khởi động container web và chuyển đổi bản ghi DNS). | Tức thì: Gần như bằng 0 (hạ điểm số healthcheck của site gặp sự cố, DNS tự động điều hướng sang site còn lại). |
| RPO (Mất mát dữ liệu) | Lớn: 12 – 24 giờ (bằng chu kỳ giữa hai lần chạy cron sao lưu dữ liệu). | Rất thấp: Dưới 1 phút (chênh lệch độ trễ sao chép replication lag qua mạng riêng). | Cực thấp: 0 giây (nếu sử dụng cơ chế đồng bộ đồng thuận hai chiều). |
| Chi phí hạ tầng | Rất thấp: Không tốn chi phí máy chủ, chỉ tốn vài USD tiền lưu trữ Object Storage hàng tháng. | Tối ưu: Chỉ tốn thêm khoảng 20% – 35% so với chi phí cụm máy chủ chính hàng tháng. | Rất đắt: Tăng thêm 100% – 130% chi phí hạ tầng (gấp đôi toàn bộ máy chủ và phát sinh băng thông liên lục địa). |
| Độ phức tạp kỹ thuật | Thấp, nhưng rủi ro thất bại khi bung restore khẩn cấp rất cao do môi trường mới chưa được kiểm chứng trước. | Vừa phải: Cần thiết lập kênh mạng riêng ảo mã hóa (WireGuard) và đồng bộ cơ sở dữ liệu một chiều. | Cực kỳ phức tạp: Dễ xảy ra xung đột ghi dữ liệu hai đầu (Split-Brain Write Conflicts), độ trễ mạng xuyên đám mây làm chậm hiệu năng ghi. |
| Đánh giá phù hợp | Phù hợp với blog cá nhân, website tài liệu hoặc ứng dụng nội bộ không ràng buộc về thời gian hoạt động. | Điểm cân bằng lý tưởng cho doanh nghiệp vừa và nhỏ (SME), hệ thống thương mại và SaaS. | Chỉ dành cho các hệ thống tài chính, ngân hàng lớn với ngân sách hàng chục nghìn USD mỗi tháng. |
Với đại đa số doanh nghiệp và nhóm phát triển, mô hình Warm-Standby mang lại tỷ lệ hiệu quả trên chi phí (ROI) tốt nhất: bạn vừa đảm bảo RTO dưới 15 phút và RPO dưới 1 phút, vừa không phải gánh mức chi phí gấp đôi của mô hình Hot-Hot.
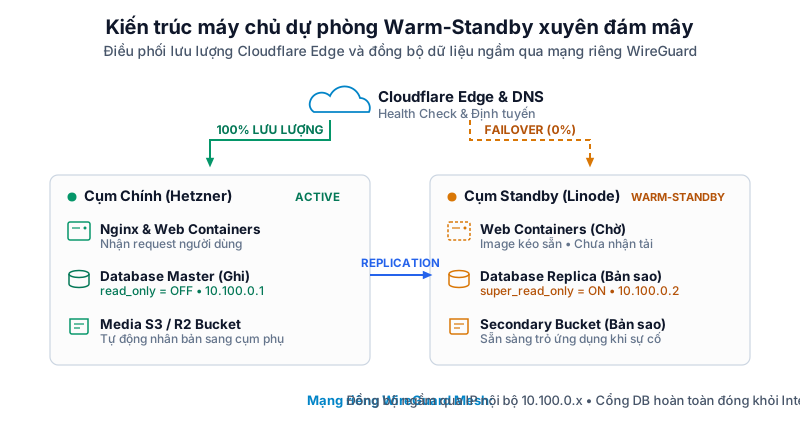
Kiến trúc tổng thể hệ thống Warm-Standby xuyên nhà cung cấp
Kiến trúc Warm-Standby bao gồm hai phân vùng hạ tầng độc lập được kết nối với nhau qua một đường truyền mạng riêng ảo:
1. Hạ tầng chính (Primary Site - Nhà cung cấp A)
Đặt tại nhà cung cấp chính (ví dụ: Hetzner tại Đức):
- Cân bằng tải & Web Nodes: Nginx Load Balancer đón nhận toàn bộ lưu lượng người dùng từ Internet và điều phối vào các Web Node theo mô hình cân bằng tải Nginx.
- Database Master: Máy chủ cơ sở dữ liệu (MySQL hoặc PostgreSQL) hoạt động ở chế độ đọc-ghi bình thường (
read_only = OFF). - Lưu trữ tĩnh (Media/Uploads): Tệp tin người dùng tải lên được đẩy trực tiếp lên dịch vụ Object Storage tương thích S3 (như Cloudflare R2 hoặc AWS S3) theo nguyên tắc tách lưu trữ tệp khỏi máy chủ cục bộ.
2. Hạ tầng dự phòng (Standby Site - Nhà cung cấp B)
Đặt tại nhà cung cấp thứ hai (ví dụ: DigitalOcean hoặc Linode):
- Máy chủ Standby: Một máy chủ VPS duy nhất (hoặc cụm máy chủ cấu hình tối giản) luôn bật sẵn 24/7.
- Database Replica: Nhận luồng dữ liệu sao chép liên tục từ Database Master của Primary Site. Máy chủ này được khóa cứng ở chế độ chỉ đọc nghiêm ngặt (
read_only = ONvàsuper_read_only = ON). - Web Containers: Các container ứng dụng Docker đã được kéo sẵn image từ trước thông qua pipeline CI/CD, nhưng được đặt ở trạng thái chờ (dormant /
replicas: 0) hoặc chưa nhận lưu lượng truy cập từ ngoài Internet.
3. Kênh kết nối mạng riêng và tầng điều phối
- Đường hầm WireGuard Mesh: Thay vì kết nối cơ sở dữ liệu trực tiếp qua địa chỉ IP công cộng (rất dễ bị tấn công quét cổng), hai máy chủ thiết lập một đường hầm mã hóa điểm-điểm (Point-to-Point) theo chuẩn mạng nội bộ Zero Trust WireGuard. Toàn bộ dữ liệu sao chép chỉ di chuyển qua giao diện mạng ảo nội bộ
wg-dr0(10.100.0.1và10.100.0.2). - Tầng điều phối Edge (Cloudflare DNS): Trỏ 100% lưu lượng người dùng về địa chỉ IP của Primary Site. Khi có sự cố thảm họa được xác nhận, bản ghi DNS hoặc cấu hình Cloudflare Load Balancing sẽ được chuyển hướng sang IP của Standby Site.
Thiết lập kênh truyền an toàn và tường lửa liên đám mây
Để luồng sao chép cơ sở dữ liệu diễn ra an toàn giữa hai nhà cung cấp, bạn không được mở cổng cơ sở dữ liệu (MySQL 3306 hoặc PostgreSQL 5432) ra ngoài Internet. Toàn bộ lưu lượng bắt buộc phải đi qua giao diện mạng riêng ảo WireGuard.
1. Cấu hình WireGuard trên Máy chủ Chính (Primary DB Node)
Giả sử địa chỉ IP public của Primary là 198.51.100.10, và IP public của Standby là 203.0.113.50.
Tạo file cấu hình /etc/wireguard/wg-dr0.conf trên máy chủ Primary:
[Interface]
Address = 10.100.0.1/24
ListenPort = 51820
PrivateKey = <PRIMARY_PRIVATE_KEY>

[Peer]
PublicKey = <STANDBY_PUBLIC_KEY>
Endpoint = 203.0.113.50:51820
AllowedIPs = 10.100.0.2/32
PersistentKeepalive = 25
2. Cấu hình WireGuard trên Máy chủ Dự phòng (Standby Node)
Tạo file cấu hình /etc/wireguard/wg-dr0.conf trên máy chủ Standby:
[Interface]
Address = 10.100.0.2/24
ListenPort = 51820
PrivateKey = <STANDBY_PRIVATE_KEY>

[Peer]
PublicKey = <PRIMARY_PUBLIC_KEY>
Endpoint = 198.51.100.10:51820
AllowedIPs = 10.100.0.1/32
PersistentKeepalive = 25
Khởi chạy và bật tự động khởi động cùng hệ điều hành trên cả hai máy chủ:
sudo systemctl enable --now wg-quick@wg-dr0Kiểm tra trạng thái kết nối bằng lệnh sudo wg show. Bạn cần thấy dòng latest handshake cập nhật trong vòng vài giây gần nhất và lệnh ping 10.100.0.2 từ Primary phản hồi ổn định với độ trễ dưới 40ms (nếu cùng khu vực) hoặc dưới 160ms (nếu khác châu lục).
3. Thiết lập tường lửa UFW nghiêm ngặt
Trên cả hai máy chủ, bạn chỉ mở cổng UDP 51820 cho dịch vụ WireGuard trên giao diện mạng ngoài (eth0). Cổng cơ sở dữ liệu chỉ được phép tiếp nhận kết nối đến từ địa chỉ IP WireGuard đối ứng:
# Mở cổng WireGuard trên card mạng ngoài
sudo ufw allow 51820/udp

# Tại Primary DB: chỉ cho phép Standby kết nối MySQL qua giao diện wg-dr0
sudo ufw allow in on wg-dr0 to 10.100.0.1 port 3306 proto tcp from 10.100.0.2 comment "MySQL DR Replication"

# Khóa tuyệt đối cổng 3306 trên mọi giao diện khác
sudo ufw deny 3306/tcp
Thiết lập này đảm bảo kẻ tấn công quét cổng IP public của bạn sẽ thấy cổng 3306 ở trạng thái đóng hoàn toàn (filtered/closed).
Cơ chế đồng bộ dữ liệu liên tục (Continuous Data Replication)
Hệ thống Warm-Standby duy trì 3 luồng dữ liệu độc lập để đảm bảo trạng thái của máy chủ dự phòng luôn sẵn sàng thay thế máy chủ chính bất kỳ lúc nào:
1. Đồng bộ Cơ sở dữ liệu quan hệ (RDBMS)
Cơ sở dữ liệu là thành phần có trạng thái (Stateful) quan trọng nhất. Chúng ta sử dụng cơ chế nhân bản bất đồng bộ dựa trên Transaction ID (GTID trong MySQL hoặc Streaming Replication với WAL trong PostgreSQL).
Trên máy chủ Standby, sau khi cấu hình nhận replication từ Primary IP 10.100.0.1, bạn bắt buộc phải bật hai tham số bảo vệ trong file cấu hình /etc/mysql/mysql.conf.d/mysqld.cnf:
[mysqld]
server-id = 2
gtid_mode = ON
enforce_gtid_consistency = ON

# Khóa ghi nghiêm ngặt để chống xung đột dữ liệu
read_only = ON
super_read_only = ONĐể giám sát độ trễ đồng bộ (Replication Lag), bạn kiểm tra trạng thái replica định kỳ:
SHOW REPLICA STATUS\GHai chỉ số kỹ thuật cần xác nhận:
Replica_IO_Running: YesvàReplica_SQL_Running: Yes: Luồng đọc và luồng ghi log đang hoạt động bình thường.Seconds_Behind_Source: Thường xuyên duy trì ở mức 0 hoặc dưới 5 giây. Nếu chỉ số này tăng vọt lên hàng trăm giây, bạn cần kiểm tra ngay băng thông mạng WireGuard hoặc tình trạng nghẽn I/O đĩa trên máy chủ Standby.
2. Đồng bộ Tệp tin tĩnh và Media (Uploads)
Nếu ứng dụng của bạn cho phép người dùng tải lên hình ảnh, tài liệu hoặc video, việc đồng bộ các file này qua lệnh rsync truyền thống thường gặp vấn đề về độ trễ và dễ gây nghẽn đĩa.
Giải pháp chuẩn hóa theo kiến trúc Multi-Server là đẩy toàn bộ media lên Object Storage tương thích S3 (như Cloudflare R2 hoặc AWS S3) theo hướng dẫn tại HTS-094. Sau đó, bạn bật tính năng Cross-Region / Cross-Bucket Replication trên bảng điều khiển của nhà cung cấp lưu trữ để bucket tại Region A tự động nhân bản dữ liệu sang một bucket dự phòng tại Region B. Khi máy chủ Standby được kích hoạt, ứng dụng chỉ cần đọc dữ liệu từ bucket dự phòng này.
3. Đồng bộ Hình ảnh Docker và Cấu hình môi trường
Để máy chủ Standby có thể khởi chạy ứng dụng ngay lập tức mà không phải chờ build mã nguồn:
- Mọi phiên bản ứng dụng sau khi vượt qua bài kiểm tra tự động trên Self-Hosted Runner sẽ được đóng gói thành Docker Image và đẩy lên Container Registry chung.
- Pipeline CI/CD được cấu hình để gửi lệnh SSH nội bộ tới máy chủ Standby, chạy lệnh
docker compose pullđể tải sẵn các layer image về ổ đĩa cục bộ. - File cấu hình môi trường
.envđược đồng bộ an toàn thông qua hệ thống quản lý secret tập trung Infisical thay vì copy file thủ công.
Tối ưu chi phí hạ tầng: Giữ chi phí Standby ở mức thấp
Một trong những lý do khiến nhiều doanh nghiệp ngần ngại triển khai máy chủ dự phòng khác nhà cung cấp là lo ngại chi phí tăng gấp đôi. Trong mô hình Warm-Standby, bạn hoàn toàn có thể kiểm soát chi phí nhờ hai nguyên tắc sau:
1. Cấu hình thích ứng tối thiểu (Right-Sizing the Standby Node)
Trong điều kiện vận hành bình thường, máy chủ Standby không phải xử lý hàng nghìn truy vấn web từ người dùng. Nhiệm vụ duy nhất của nó là nhận các gói tin binlog qua WireGuard và ghi tuần tự vào đĩa cứng.
Do đó, máy chủ Standby không cần cấu hình 8 vCPU hay 32GB RAM như cụm Primary:
- Bạn chỉ cần chọn một máy ảo VPS với 2 vCPU, 4GB RAM và ổ đĩa NVMe đủ chứa dung lượng cơ sở dữ liệu.
- Mức cấu hình này đủ để tiến trình Database Replica chạy mượt mà mà chi phí hàng tháng chỉ dao động trong khoảng vài trăm nghìn đồng (khoảng 12 –20/tháng).
2. Kịch bản đánh thức khẩn cấp (Awakening Strategy)
Khi thảm họa xảy ra và bạn quyết định chuyển toàn bộ lưu lượng người dùng sang máy chủ Standby, máy chủ này sẽ cần nhiều tài nguyên hơn để phục vụ tải thực tế.
Thay vì trả tiền cho cấu hình lớn trong suốt 30 ngày mỗi tháng, bạn áp dụng quy trình 2 bước:
- Bước 1 (Tự động nâng cấu hình): Sử dụng Cloud CLI hoặc API của nhà cung cấp đám mây (ví dụ DigitalOcean API hoặc Linode CLI) để nâng cấu hình VPS (Resize) từ 2 vCPU lên 8 vCPU trong vòng 2 đến 3 phút.
- Bước 2 (Khởi động ứng dụng): Chạy lệnh
docker compose up -d --scale web=4để khởi chạy đầy đủ các tiến trình xử lý web.
Nhờ chiến lược này, bạn chỉ phải trả tiền cho cấu hình máy chủ cao trong những ngày thực sự diễn ra thảm họa hoặc trong các buổi diễn tập định kỳ.
Kịch bản kích hoạt chuyển vùng thảm họa (Disaster Cutover Runbook)
Khi trung tâm dữ liệu chính gặp sự cố gián đoạn nghiêm trọng, đội ngũ kỹ thuật cần tuân thủ nghiêm ngặt quy trình 5 bước chuyển vùng để tránh làm hỏng dữ liệu:
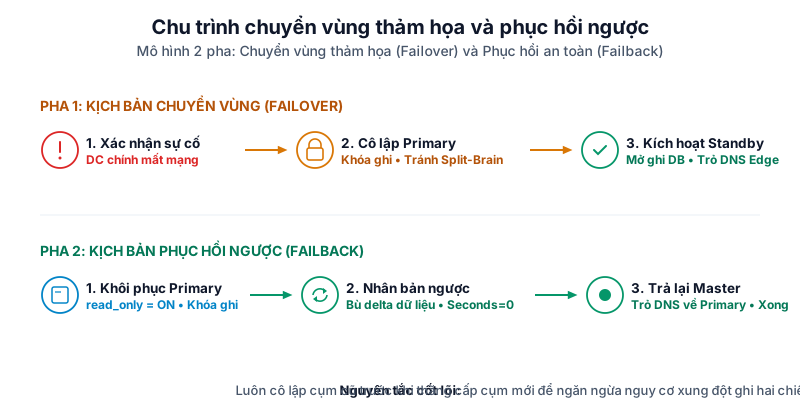
Bước 1: Xác nhận thảm họa (Disaster Declaration Gate)
Không bao giờ kích hoạt chuyển vùng chỉ vì một công cụ giám sát báo lỗi timeout trong vài chục giây. Chuyển vùng thảm họa là một quyết định kỹ thuật lớn.
Tiêu chí xác nhận thảm họa:
- Máy chủ chính không thể truy cập từ ít nhất 3 vị trí mạng độc lập (Multi-vantage health checks).
- Bảng điều khiển của nhà cung cấp A thông báo sự cố mất điện, cháy trạm, hoặc đứt cáp diện rộng.
- Thời gian gián đoạn dự kiến vượt quá ngưỡng RTO cam kết (> 15 phút).
Bước 2: Cô lập Máy chủ Chính (Fence the Primary)
Trước khi mở quyền ghi trên máy chủ Standby, bạn phải đảm bảo máy chủ Primary không còn nhận thêm bất kỳ lệnh ghi nào từ người dùng để ngăn chặn hiện tượng não phân đôi (Split-Brain):
- Nếu bảng điều khiển nhà cung cấp A còn truy cập được: Tắt nguồn máy chủ Primary (Power Off) hoặc ngắt card mạng ngoài.
- Nếu không truy cập được: Chuyển hướng bản ghi DNS ngay lập tức để cắt đứt lưu lượng người dùng gửi đến địa chỉ IP cũ.
Bước 3: Thăng cấp Standby Database thành Master
Đăng nhập vào máy chủ Standby qua SSH và thực hiện quy trình thăng cấp cơ sở dữ liệu:
-- 1. Kiểm tra đảm bảo replica đã đọc hết các relay log cuối cùng nhận được
SHOW REPLICA STATUS\G

-- 2. Dừng tiến trình sao chép
STOP REPLICA;
RESET REPLICA ALL;

-- 3. Gỡ bỏ chế độ khóa ghi
SET GLOBAL read_only = OFF;
SET GLOBAL super_read_only = OFF;
Lúc này, Database trên máy chủ Standby đã trở thành một cơ sở dữ liệu Master độc lập, sẵn sàng tiếp nhận các truy vấn đọc-ghi từ ứng dụng.
Bước 4: Khởi động dịch vụ ứng dụng tại Standby
Khởi chạy toàn bộ các vùng chứa ứng dụng và kiểm tra trạng thái hoạt động:
cd /opt/application
docker compose up -d

# Kiểm tra phản hồi HTTP từ cổng nội bộ
curl -I http://localhost:8080/health
Khi endpoint nội bộ trả về mã HTTP 200 OK, ứng dụng tại Standby đã sẵn sàng phục vụ.
Bước 5: Chuyển hướng lưu lượng DNS
Cập nhật bản ghi DNS (hoặc quy tắc định tuyến trên Cloudflare) trỏ tên miền chính của ứng dụng từ địa chỉ IP của nhà cung cấp A sang địa chỉ IP của nhà cung cấp B.
Nếu bạn sử dụng Cloudflare Proxy, việc thay đổi địa chỉ IP Origin Server diễn ra gần như tức thì mà không phải chờ đợi thời gian phân giải DNS (DNS Propagation) của các nhà mạng viễn thông. Hệ thống của bạn chính thức hoạt động trở lại trên hạ tầng mới.
Kế hoạch phục hồi ngược (Failback Runbook): Trở về máy chủ chính an toàn
Trong vận hành thảm họa, nhiều đội ngũ kỹ thuật xử lý rất tốt khâu chuyển vùng (Failover), nhưng lại gặp khủng hoảng nghiêm trọng ở khâu phục hồi ngược (Failback).
Quy trình phục hồi ngược an toàn được thực hiện tuần tự theo 4 bước:
Bước 1: Khởi động Primary cũ ở chế độ chỉ đọc nghiêm ngặt
Khi nhà cung cấp A đã khắc phục xong sự cố mạng hoặc phần cứng:
- Khởi động lại máy chủ Primary cũ.
- Trước khi mở bất kỳ dịch vụ nào, đăng nhập vào MySQL trên Primary cũ và kích hoạt ngay:
  SET GLOBAL read_only = ON;
SET GLOBAL super_read_only = ON;- Kiểm tra kết nối mạng riêng WireGuard giữa hai máy chủ để đảm bảo đường truyền
10.100.0.xđã thông suốt trở lại.
Bước 2: Thiết lập cơ chế sao chép ngược (Reverse Replication)
Lúc này, máy chủ Standby đang đóng vai trò là Master. Bạn cần cấu hình để Primary cũ trở thành Replica nhận dữ liệu từ Standby:
-- Thực hiện trên Primary cũ
CHANGE REPLICATION SOURCE TO
  SOURCE_HOST='10.100.0.2',
  SOURCE_USER='repl_user',
  SOURCE_PASSWORD='<SECURE_PASSWORD>',
  SOURCE_AUTO_POSITION=1;

START REPLICA;
Toàn bộ các giao dịch mới phát sinh trên Standby trong thời gian thảm họa sẽ được truyền ngược về và nạp vào Primary cũ qua đường hầm WireGuard.
Bước 3: Đo kiểm dữ liệu bắt kịp hoàn toàn
Theo dõi chỉ số Seconds_Behind_Source trên Primary cũ:
SHOW REPLICA STATUS\GChờ cho đến khi chỉ số này chạm mốc 0 giây. Điều này chứng minh 100% dữ liệu phát sinh tại Standby đã được đồng bộ đầy đủ và nhất quán sang Primary.
Bước 4: Đổi quyền Master trong cửa sổ bảo trì
Lựa chọn khung giờ thấp điểm (thường từ 2h đến 3h sáng):
- Bật trang thông báo bảo trì ngắn (khoảng 3 – 5 phút) trên Cloudflare.
- Dừng ghi trên Standby:
SET GLOBAL read_only = ON; SET GLOBAL super_read_only = ON;. - Kiểm tra lần cuối đảm bảo Primary cũ đã nhận hết log từ Standby.
- Thăng cấp Primary cũ trở lại làm Master:
   STOP REPLICA;
   RESET REPLICA ALL;
   SET GLOBAL read_only = OFF;
SET GLOBAL super_read_only = OFF;- Đổi máy chủ Standby trở lại làm Replica nhận dữ liệu từ Primary (
10.100.0.1). - Cập nhật DNS Cloudflare trỏ lưu lượng về IP của Primary và tắt trang bảo trì.
Hệ thống đã quay trở về trạng thái vận hành chuẩn ban đầu mà không làm mất mát bất kỳ bản ghi dữ liệu nào của khách hàng.
Lộ trình hoàn thiện hệ thống DR trong Cụm 4
Thiết lập máy chủ dự phòng Warm-Standby là nền tảng cốt lõi của năng lực phục hồi thảm họa doanh nghiệp. Để hoàn thiện hệ thống phòng thủ toàn diện cho hạ tầng số, bạn nên tiếp tục triển khai các chuyên đề chuyên sâu tiếp theo trong Cụm 4:
- Khóa bảo vệ dữ liệu chống tấn công mã hóa: Thiết lập cơ chế lưu trữ bất biến (WORM) với sao lưu chống Ransomware qua Restic và S3 Object Lock (
HTS-109), đảm bảo ngay cả khi kẻ tấn công chiếm được quyền root trên máy chủ cũng không thể xóa hoặc mã hóa các bản sao lưu. - Tự động hóa chuyển vùng DNS: Thay thế thao tác đổi IP thủ công bằng kịch bản chuyển vùng DNS tự động khi Data Center sự cố (
HTS-110) sử dụng Cloudflare Health Checks và kịch bản Failover thông minh. - Rèn luyện kỹ năng cho đội ngũ: Tổ chức các buổi diễn tập định kỳ theo kịch bản diễn tập phục hồi thảm họa cho đội ngũ kỹ thuật (
HTS-111) để đo lường RTO thực tế và phát hiện sớm các điểm nghẽn quy trình. - Đánh giá mức độ sẵn sàng: Sử dụng checklist kiểm toán khả năng phục hồi sau thảm họa định kỳ (
HTS-112) để rà soát định kỳ hàng quý tính toàn vẹn của hệ thống dự phòng.