Trong quản trị hạ tầng, có một nguyên lý vận hành được nhiều đội ngũ kỹ thuật đúc kết: một bản sao lưu chưa từng được phục hồi thử nghiệm thực chất chỉ là một giả định trên lý thuyết. Rất nhiều hệ thống duy trì lịch sao lưu tự động hàng ngày lên các dịch vụ đám mây, dữ liệu nén thành công và thông báo gửi về Telegram đều đặn màu xanh. Tuy nhiên, khi trung tâm dữ liệu gặp sự cố phần cứng nghiêm trọng hoặc hệ thống bị tấn công mã hóa, đội ngũ kỹ thuật lại mất hàng ngày trời mà vẫn không thể đưa dịch vụ hoạt động trở lại.
Tình trạng gián đoạn kéo dài thường không nằm ở việc thiếu file dữ liệu, mà do tài liệu vận hành đã lỗi thời và quy trình phối hợp chưa từng được thực hành dưới áp lực thời gian. Diễn tập phục hồi thảm họa (Disaster Recovery Simulation hay GameDay) là phương pháp trực tiếp giúp bạn kiểm chứng tính khả thi của quy trình cứu hộ trước khi đối mặt với sự cố thực tế.
Bản chất của diễn tập phục hồi thảm họa trong môi trường kỹ thuật
Nhiều quản trị viên thường nhầm lẫn giữa việc kiểm tra tính toàn vẹn của file sao lưu và một buổi diễn tập phục hồi thảm họa toàn diện.
Kiểm tra sao lưu thụ động thường chỉ dừng lại ở mức xác minh file nén có đọc được hay không, hoặc checksum dữ liệu có khớp với bản ghi ban đầu. Ngược lại, diễn tập phục hồi thảm họa là một bài thực hành phối hợp của toàn bộ đội ngũ kỹ thuật trong một khung thời gian giới hạn, nhằm đưa toàn bộ ngăn xếp ứng dụng trở lại trạng thái sẵn sàng phục vụ từ con số không.
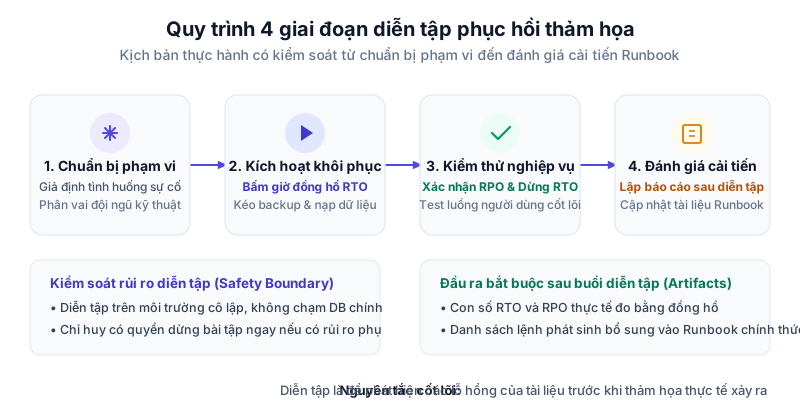
Mục tiêu của buổi diễn tập không phải là chứng minh quy trình đã trơn tru, mà là tìm ra những điểm gián đoạn phát sinh trong tài liệu vận hành (Runbook) khi con người thao tác dưới áp lực thời gian.
Hai chỉ số đo lường cốt lõi: RTO và RPO thực tế
Mọi buổi diễn tập chuyên nghiệp đều phải xoay quanh việc kiểm chứng hai chỉ số phục hồi then chốt bằng số liệu thực tế thay vì ước lượng cảm tính:
- RPO (Recovery Point Objective - Điểm khôi phục mục tiêu): Đo lường lượng dữ liệu tối đa chấp nhận mất mát giữa bản sao lưu hợp lệ gần nhất và thời điểm xảy ra sự cố. Trong buổi diễn tập, bạn đối soát mốc giao dịch cuối cùng được khôi phục trong cơ sở dữ liệu với thời điểm kích hoạt kịch bản để tính ra độ lệch dữ liệu thực tế (Delta).
- RTO (Recovery Time Objective - Thời gian khôi phục mục tiêu): Tổng thời gian tính từ lúc bắt đầu phát lệnh thảm họa cho đến khi ứng dụng khởi chạy thành công và vượt qua các bài kiểm tra nghiệp vụ.
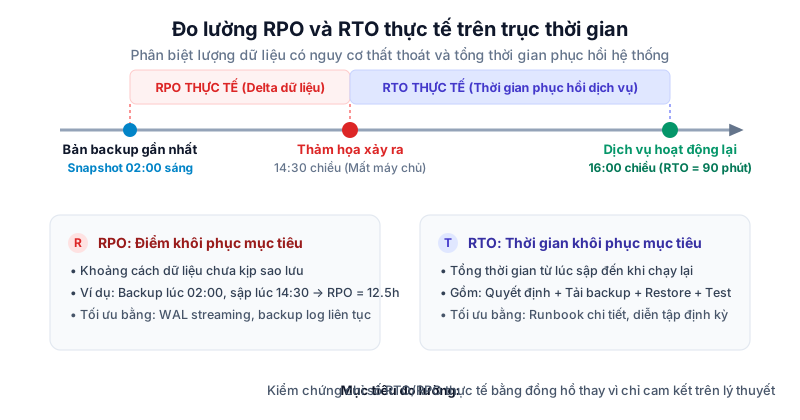
Nếu cam kết vận hành với doanh nghiệp là dịch vụ phải phục hồi trong vòng 2 giờ (RTO ≤ 120 phút), nhưng buổi diễn tập mất tới 4 giờ chỉ để tải và giải nén dữ liệu, bạn đã phát hiện ra khoảng trống kỹ thuật cần tối ưu ngay lập tức.
Chuẩn bị kịch bản và phân định trách nhiệm đội ngũ
Để buổi diễn tập mang lại hiệu quả mà không gây rủi ro cho môi trường sản xuất đang chạy, khâu lập kế hoạch cần được kiểm soát chặt chẽ.
Thiết lập ranh giới an toàn cho buổi diễn tập
Một nguyên tắc quan trọng khi tổ chức GameDay là kiểm soát vùng ảnh hưởng (Blast Radius Control). Diễn tập phải được tiến hành trên một hạ tầng độc lập hoàn toàn với cụm máy chủ chính:
- Khởi tạo các máy chủ ảo tạm thời (hoặc sử dụng cụm máy chủ dự phòng Warm-Standby như đã thiết lập trong bài viết Thiết lập máy chủ dự phòng trên hai nhà cung cấp khác nhau).
- Sử dụng tài khoản IAM có quyền chỉ đọc (Read-Only) khi kéo bản sao lưu từ kho lưu trữ đám mây. Như đã phân tích trong bài Sao lưu chống Ransomware với Restic và S3 Object Lock, cơ chế khóa bảo lưu dữ liệu (WORM) và việc phân quyền chặt chẽ sẽ ngăn chặn nguy cơ thao tác nhầm làm thay đổi hoặc xóa các snapshot lịch sử.
- Cô lập hoàn toàn kết nối mạng giữa môi trường diễn tập và cơ sở dữ liệu sản xuất để ngăn chặn nguy cơ ghi đè dữ liệu thật hoặc chạy nhầm kịch bản dọn dẹp.
- Trỏ các tác vụ gửi email thông báo, cổng thanh toán hoặc webhook bên thứ ba sang môi trường Sandbox, hoặc tạm dừng hoàn toàn các worker xử lý nền.
Mô hình phân vai trong buổi diễn tập
Khi có sự cố xảy ra, việc thiếu người điều phối sẽ nhanh chóng dẫn đến tình trạng nhiều người cùng gõ lệnh chồng chéo hoặc không ai ghi nhận các bước phát sinh. Một buổi diễn tập cần tối thiểu 3 vai trò độc lập:
| Vai trò | Trách nhiệm chính | Thao tác thực tế |
|---|---|---|
| Chỉ huy sự cố (Incident Commander) | Điều phối chung, bấm giờ RTO, ra quyết định kích hoạt hoặc hủy diễn tập | Theo dõi tiến độ, không trực tiếp gõ lệnh kỹ thuật để giữ cái nhìn bao quát. |
| Kỹ sư thao tác (Lead SRE / DevOps) | Thực thi các bước khôi phục hạ tầng theo tài liệu | Kéo bản sao lưu từ S3, dựng container, import cơ sở dữ liệu. |
| Thư ký ghi nhận (Scribe) | Ghi lại mốc thời gian và mọi điểm nghẽn phát sinh | Ghi chú lại từng câu lệnh lỗi, thời gian chờ tải dữ liệu, các bước phải tra cứu bên ngoài. |
Quy trình 4 bước thực hiện diễn tập phục hồi thảm họa
Dưới đây là kịch bản chuẩn cho một phiên diễn tập phục hồi thảm họa kéo dài nửa ngày dành cho đội ngũ vận hành.
Bước 1: Kích hoạt tình huống giả định và bấm giờ
Chỉ huy sự cố công bố tình huống giả định cụ thể cho toàn đội ngũ:
- Tình huống ví dụ: Trung tâm dữ liệu của nhà cung cấp A gặp sự cố mất điện diện rộng kéo dài, toàn bộ máy chủ sản xuất không thể truy cập qua mạng.
- Thư ký ghi nhận bắt đầu bấm đồng hồ tính thời gian RTO tại mốc T_0.
- Kỹ sư thao tác mở tài liệu Runbook khôi phục thảm họa chính thức của hệ thống. Nguyên tắc nghiêm ngặt tại bước này là: chỉ được làm theo những gì đã viết trong tài liệu, không làm theo trí nhớ cá nhân.
Bước 2: Dựng môi trường độc lập từ dữ liệu sao lưu mới nhất
Kỹ sư thao tác tiến hành khởi tạo máy chủ mới trên nhà cung cấp dự phòng và kéo dữ liệu từ kho lưu trữ đám mây độc lập:
# 1. Khởi tạo thư mục phục hồi thảm họa trên máy chủ kiểm thử
mkdir -p /opt/dr-recovery && cd /opt/dr-recovery

# 2. Kết nối và tải bản sao lưu mới nhất từ S3 kho khóa bảo lưu
restic -r s3:https://s3.ap-southeast-1.wasabisys.com/company-backup-dr restore latest \
  --target /opt/dr-recovery/data \
  --verbose

# 3. Nạp lại cơ sở dữ liệu vào môi trường kiểm thử
docker compose -f docker-compose.dr.yml up -d db
docker exec -i dr-mysql-container mysql -u root -p"$DR_ROOT_PASS" < /opt/dr-recovery/data/mysql_dump.sql
Trong lúc dữ liệu đang được import, Thư ký ghi nhận mốc thời gian tải mạng (Network Download Time) và thời gian giải nén cơ sở dữ liệu để đưa vào báo cáo đánh giá.
Bước 3: Kiểm tra tính toàn vẹn ứng dụng và xác nhận điểm dữ liệu (RPO)
Sau khi cơ sở dữ liệu nạp xong, người kiểm thử truy vấn các bảng ghi quan trọng để xác nhận mốc thời gian dữ liệu cuối cùng:
-- Kiểm tra bản ghi giao dịch mới nhất đã được khôi phục thành công
SELECT id, created_at, status
FROM orders
ORDER BY created_at DESC
LIMIT 5;
Nếu bản ghi đơn hàng mới nhất dừng lại ở 14:02:15, trong khi thảm họa được giả lập tại mốc 14:30:00, đội ngũ xác nhận mức thất thoát dữ liệu thực tế (RPO) là khoảng 28 phút. Con số này sẽ được so sánh với cam kết kinh doanh nội bộ.
Bước 4: Kiểm thử luồng nghiệp vụ thực tế và dừng đồng hồ (RTO)
Ứng dụng chỉ được coi là đã phục hồi khi người dùng thực tế có thể thao tác bình thường, không chỉ dừng lại ở việc container trả về mã HTTP 200 tại trang chủ:
- Thử nghiệm đăng nhập tài khoản người dùng đã có từ trước.
- Tạo một đơn hàng thử nghiệm mới trong môi trường kiểm tra.
- Xác nhận các file hình ảnh, chứng từ tải lên trước đó được hiển thị đầy đủ.
Khi toàn bộ các bài kiểm tra nghiệp vụ cốt lõi hoàn tất thành công, Chỉ huy sự cố công bố kết thúc kịch bản và dừng đồng hồ RTO tại mốc T_{end}.
Năm cạm bẫy khiến hệ thống không thể khởi động dù file sao lưu hợp lệ
Quá trình diễn tập thường bộc lộ những sai lệch nhỏ trong cấu hình mà các công cụ kiểm tra tự động hàng ngày không phát hiện được:
[Máy chủ mới dựng] ──x── [Thiếu file .env] ──────────> Ứng dụng báo lỗi CrashLoopBackOff
[Cơ sở dữ liệu]    ──x── [Thiếu RAM giải nén] ───────> Hệ điều hành kích hoạt OOM Killer
[Khóa giải mã]     ──x── [Lưu cục bộ trên máy cũ] ──> Không thể giải mã dữ liệu sao lưu
1. Lệch biến môi trường và bí mật cấu hình (.env)
Kho mã nguồn Git thường bỏ qua file .env theo chuẩn bảo mật. Khi dựng một máy chủ hoàn toàn mới từ bản sao lưu dữ liệu, ứng dụng thường xuyên bị lỗi dừng đột ngột (CrashLoopBackOff) vì thiếu các biến môi trường thiết yếu như khóa mã hóa phiên làm việc, thông tin kết nối cổng dịch vụ, hoặc khóa API nội bộ. File cấu hình mẫu .env.example thường bị bỏ quên không cập nhật suốt nhiều tháng so với môi trường sản xuất.
2. Chứng chỉ TLS và cấu hình tên miền phụ
Để kiểm thử dịch vụ trên máy chủ mới, bạn thường phải trỏ một tên miền phụ tạm thời (ví dụ: dr-test.domain.com) về IP mới. Nếu hệ thống chưa chuẩn bị sẵn chứng chỉ số hoặc sử dụng Let's Encrypt nhưng bị giới hạn tần suất yêu cầu (Rate Limit), máy chủ web Nginx sẽ từ chối khởi động, khiến toàn bộ quy trình bị đình trệ.
3. Khóa giải mã lưu trên máy chủ đã bị sập
Nhiều đội ngũ cấu hình mã hóa bản sao lưu rất chặt chẽ bằng GPG hoặc khóa bí mật của công cụ sao lưu, nhưng lại lưu trữ file chứa mật khẩu giải mã ngay trong thư mục /root của máy chủ chính. Khi máy chủ chính bị mất quyền truy cập hoặc bị xóa sạch đĩa, bản sao lưu trên đám mây không thể phục hồi được vì không ai còn giữ khóa mở dữ liệu. Khóa giải mã phải luôn được lưu trữ tại một trình quản lý mật khẩu nhóm độc lập bên ngoài hạ tầng máy chủ.
4. Thiếu tài nguyên RAM và dung lượng đĩa khi phục hồi
File dump cơ sở dữ liệu nén có thể chỉ chiếm 15GB trên kho S3, nhưng khi giải nén và tái thiết lập chỉ mục (rebuilding indexes), dung lượng đĩa thực tế cần dùng có thể lên tới 50GB. Nếu máy chủ dùng để phục hồi thảm họa được cấu hình với thông số phần cứng quá thấp, tiến trình phục hồi sẽ bị hệ điều hành tắt ngang do hết RAM (Out of Memory) hoặc hết dung lượng phân vùng tạm /tmp.
5. Lệch phân quyền người dùng trong container
Khi giải nén dữ liệu từ máy chủ này sang máy chủ khác, định danh người dùng (UID/GID) thường bị thay đổi thành root:root. Khi ứng dụng chạy bằng tài khoản người dùng hạn chế (như www-data hoặc node), container sẽ gặp lỗi không có quyền đọc ghi (Permission Denied) tại các thư mục lưu cache hoặc upload file.
Báo cáo đánh giá và cải tiến tài liệu vận hành sau diễn tập
Một buổi diễn tập chỉ thực sự hoàn tất khi các bài học thực tế được chuyển hóa thành những thay đổi cụ thể trong quy trình kỹ thuật.
Lập bảng đối soát thời gian thực tế
Trong vòng 24 giờ sau buổi diễn tập, Thư ký ghi nhận phát hành biên bản tổng kết đối soát hai chỉ tiêu:
| Tiêu chí | Cam kết mục tiêu | Kết quả thực tế đo được | Đánh giá |
|---|---|---|---|
| RPO (Độ thất thoát dữ liệu) | ≤ 1 giờ | 28 phút | Đạt yêu cầu cam kết. |
| Thời gian tải dữ liệu từ S3 | ≤ 20 phút | 45 phút | Cần bổ sung băng thông mạng nội bộ. |
| Thời gian nạp cơ sở dữ liệu | ≤ 30 phút | 52 phút | Cần tinh chỉnh tham số import của MySQL. |
| Tổng thời gian khôi phục (RTO) | ≤ 90 phút | 125 phút | Vượt ngưỡng cam kết 35 phút. |
Cập nhật tài liệu Runbook
Tất cả các lệnh phải gõ thủ công ngoài kịch bản trong buổi diễn tập phải được đưa ngay vào tài liệu chính thức:
- Bổ sung quy trình sao lưu định kỳ cho file biến môi trường bí mật vào kho an toàn.
- Tự động hóa các bước gõ lệnh dài bằng shell script đã được kiểm thử.
- Lên lịch cho buổi diễn tập kế tiếp sau 3 đến 6 tháng để kiểm tra các cải tiến vừa thực hiện.
Checklist chuẩn bị trước giờ G cho buổi diễn tập
Trước khi bắt đầu buổi diễn tập tiếp theo của đội ngũ, bạn có thể rà soát nhanh 8 hạng mục kiểm tra sau:
- Đã xác lập kịch bản giả định cụ thể (sập máy chủ, mất kết nối mạng hay lỗi cơ sở dữ liệu).
- Đã phân định rõ 3 vai trò độc lập: Chỉ huy sự cố, Kỹ sư thao tác và Thư ký ghi nhận.
- Môi trường diễn tập được cách ly hoàn toàn, không có kết nối ghi vào cơ sở dữ liệu sản xuất.
- Khóa giải mã và mật khẩu sao lưu có thể truy cập được từ bên ngoài hạ tầng máy chủ chính.
- Đã chuẩn bị đồng hồ bấm giờ độc lập để ghi nhận chính xác mốc bắt đầu và kết thúc RTO.
- Bản sao lưu cơ sở dữ liệu được đối soát mốc bản ghi cuối cùng để xác nhận chỉ số RPO thực tế.
- Đã kiểm thử luồng người dùng cốt lõi (đăng nhập, truy vấn, ghi dữ liệu mới) trước khi dừng bài tập.
- Biên bản đánh giá sau diễn tập được phát hành và tài liệu Runbook được cập nhật trong vòng 24 giờ.
Để đánh giá toàn diện năng lực phục hồi của toàn bộ hệ thống từ con người, công cụ, quyền truy cập khẩn cấp đến cơ chế rà soát định kỳ theo khung chuẩn, bạn có thể tham khảo tiếp Checklist kiểm tra định kỳ hệ thống phục hồi sau thảm họa.
Câu hỏi thường gặp
Bao lâu đội ngũ kỹ thuật nên tổ chức diễn tập phục hồi thảm họa một lần?
Với hầu hết các hệ sinh thái ứng dụng đang phát triển, tần suất phù hợp là mỗi quý một lần (3 tháng/lần) hoặc tối thiểu nửa năm một lần. Ngoài ra, bạn nên kích hoạt một buổi diễn tập ngắn mỗi khi có thay đổi lớn về kiến trúc hạ tầng (như chuyển đổi hệ quản trị cơ sở dữ liệu hoặc nâng cấp phiên bản hệ điều hành chính).
Có nên diễn tập trực tiếp trên môi trường sản xuất không?
Đối với các kịch bản diễn tập phục hồi từ bản sao lưu trắng (Cold Restore), bạn luôn nên thực hiện trên môi trường độc lập hoặc máy chủ dự phòng để tránh nguy cơ gián đoạn dịch vụ thật của người dùng. Việc diễn tập ngắt kết nối trực tiếp trên môi trường sản xuất chỉ áp dụng cho các hệ thống phân tán Active-Active đã cấu hình Kịch bản chuyển vùng DNS tự động khi Data Center sự cố hoàn chỉnh.
Nếu trong lúc diễn tập thời gian phục hồi vượt quá mức cam kết thì xử lý thế nào?
Việc thời gian phục hồi vượt quá mức RTO cam kết trong buổi diễn tập là một kết quả bình thường và có giá trị cao. Mục đích của diễn tập chính là phát hiện sự chậm trễ này khi chưa có thiệt hại thực tế. Đội ngũ kỹ thuật cần phân rã chuỗi thời gian để xem bước nào chiếm nhiều thời gian nhất (ví dụ: tốc độ tải mạng, thời gian nạp bảng chỉ mục) và tiến hành tối ưu hóa cho lần diễn tập kế tiếp.